How-to: เติมจารบีแบบ Precision ด้วย Ultrasound — 6 ขั้นตอนจาก Baseline dB สู่การเลิก Over-grease ตามปฏิทิน

How-to: เติมจารบีแบบ Precision ด้วย Ultrasound — 6 ขั้นตอนจาก Baseline dB สู่การเลิก Over-grease ตามปฏิทิน

Article
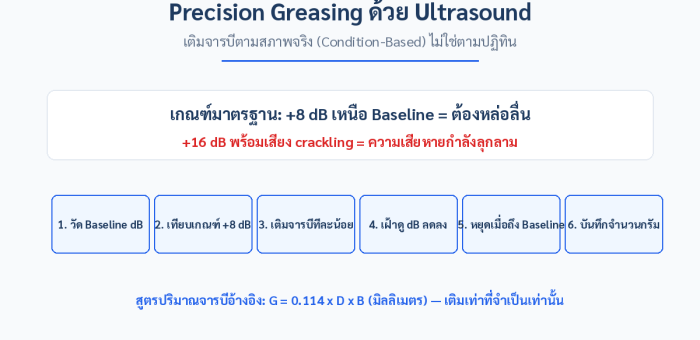
แบริ่งพังก่อนวัยส่วนใหญ่ไม่ได้พังเพราะ "ขาดจารบี" แต่พังเพราะ ถูกเติมจารบีเกินจำเป็น ตามรอบปฏิทินที่ตั้งไว้นานแล้วโดยไม่เคยถามว่าแบริ่งตัวนั้น "ต้องการจริงหรือไม่" บทความนี้คือคู่มือลงมือจริง 6 ขั้นตอน สำหรับเปลี่ยนจาก Calendar-based ไปสู่ Condition-Based Lubrication ด้วยเทคโนโลยี Ultrasound หลักการ: จารบีจำนวนเท่าไรคือ "พอดี" สัญญาณ Ultrasound ของแบริ่งคือเสียงแรงเสียดทานในย่านความถี่สูงที่หูมนุษย์ได้ยินไม่ได้ เมื่อฟิล์มจารบีบางลง ค่า dB จะค่อย ๆ ไต่ขึ้น เกณฑ์ที่ใช้กันเป็นมาตรฐานสากลคือ +8 dB เหนือ Baseline = แบริ่งต้องการการหล่อลื่น และถ้าค่าขึ้นถึง +16 dB เหนือค่าเดิม พร้อมเสียง Crackling นั่นไม่ใช่เรื่องจารบีอีกต่อไป แต่คือความเสียหายที่กำลังลุกลาม — เติมจารบีเพิ่มก็ไม่ช่วย สำหรับปริมาณอ้างอิงเบื้องต้น ใช้สูตรมาตรฐานอุตสาหกรรม G = 0.114 × D × B เมื่อ D คือเส้นผ่านศูนย์กลางรูแบริ่ง และ B คือความกว้างแบริ่ง (หน่วยมิลลิเมตร ผลลัพธ์เป็นกรัม) — แต่จำนวนนี้เป็นแค่ "เพดาน" ไม่ใช่เป้าหมาย เพราะหัวใจของวิธีนี้คือเติมทีละน้อยแล้วให้ตัวเลข dB เป็นคนบอกว่าพอหรือยัง 6 ขั้นตอนลงมือทำ สร้าง Baseline ทุกจุด — วัดค่า dB ของแบริ่งทุกตัวขณะเครื่องปกติ พร้อมบันทึกข้อมูลประกอบ (RPM, อุณหภูมิ, ชนิดจารบี) ไว้เป็นมาตรฐานเปรียบเทียบ ตั้ง Route เก็บค่าสม่ำเสมอ — อย่างน้อยเดือนละครั้งด้วยเครื่องมือ Ultrasound แบบถือได้ หรือติด Sensor ถาวรสำหรับจุดวิกฤต แล้วเทียบกับ Baseline ทุกครั้ง คัดแบริ่งที่เกินเกณฑ์ +8 dB — เฉพาะรายที่เกินเท่านั้นที่เข้าขั้นตอนเติมจารบี ที่เหลือไม่แตะต้อง นี่คือจุดที่ตัด Over-grease ได้ตั้งแต่ต้นทาง คำนวณปริมาณและเติมทีละน้อย — เริ่มจาก 1 ใน 3 ของปริมาณตามสูตร G = 0.114 × D × B พร้อมฟังเสียงและเฝ้าค่า dB แบบเรียลไทม์ อ่านทิศทาง dB ให้เป็น — dB ลดลง = ทิศทางถูก…
Read More
Ferrography คือการตรวจ MRI ของเครื่องจักร — อ่านอนุภาคสึกหรอ 6 ประเภทตาม ASTM D7690 ก่อนแบริ่งจะพัง

Ferrography คือการตรวจ MRI ของเครื่องจักร — อ่านอนุภาคสึกหรอ 6 ประเภทตาม ASTM D7690 ก่อนแบริ่งจะพัง

Article
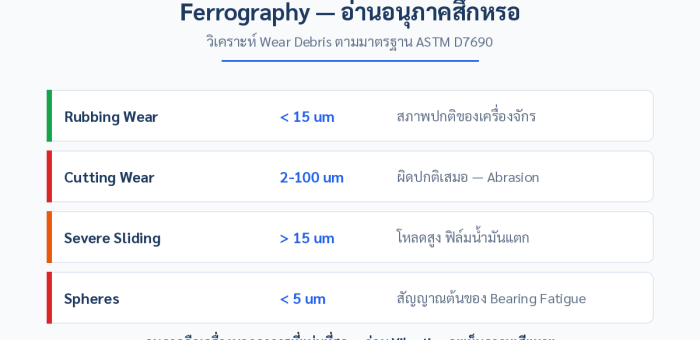
เมื่อแบริ่งหรือเฟืองทดเริ่มมีความเสียหายบนผิวสัมผัส สิ่งแรกที่ "หลุดออกมา" ไม่ใช่สัญญาณ vibration แต่เป็น อนุภาคโลหะขนาดไมโครน ที่ปนออกมากับน้ำมันหล่อลื่น Ferrography คือศาสตร์ของการเก็บอนุภาคเหล่านี้ด้วยสนามแม่เหล็ก แยกตามขนาด แล้วอ่านใต้กล้องจุลทรรศน์เพื่อบอกว่าเครื่องจักรกำลังสึกหรอ "ด้วยกลไกใด" และ "รุนแรงแค่ไหน" — ก่อนที่วิธีอื่นจะมองเห็น Ferrography ทำงานอย่างไร — สองระดับของการวิเคราะห์ Direct Reading (DR) Ferrography คือการวัดเชิงปริมาณเร็ว ๆ: ตัวอย่างน้ำมันไหลผ่านสนามแม่เหล็กความเข้มสูง อนุภาค Ferromagnetic ขนาดตั้งแต่ราว 0.1 ไมครอนขึ้นไปจะถูกดึงแยกออกมาได้เกือบสมบูรณ์ ผลลัพธ์คือค่า WPC (Wear Particle Concentration) และ WSI (Wear Severity Index) ที่ใช้เฝ้าแนวโน้ม (Trend) ได้ทุกสัปดาห์ Analytical Ferrography คือขั้นถัดมาเมื่อค่า trend เริ่มผิดปกติ: อนุภาคถูกฝากลงบนแผ่นกระจก (Ferrogram) เรียงตามขนาดด้วยแรงแม่เหล็ก แล้วส่องด้วยกล้องจุลทรรศน์แบบส่องผ่านและสะท้อนพร้อมกัน รวมถึงเผาความร้อน (Heat Treatment) เพื่อแยกชนิดเหล็กกล้า vs เหล็กหล่อ — กระบวนการทั้งหมดอ้างอิงมาตรฐาน ASTM D7690 และบุคลากรควรได้รับการรับรองตาม ISO 18436-4 (Condition Monitoring — Lubricant Analysis) ภาพที่ 1: อนุภาค 6 ประเภทหลักตาม ASTM D7690 — ขนาดและรูปร่างบอกกลไกการสึกหรอโดยตรง (ที่มา: เรียบเรียงจากมาตรฐาน ASTM D7690) อ่านอนุภาคให้เป็น — 6 ประเภทที่ต้องจำ ประเภท ขนาดเชิงอ้างอิง ความหมาย สถานะ Rubbing / Sliding< 15 ไมครอนPlatelet เรียบผิวเนียน เกิดจากการสัมผัสปกติปกติ Cutting Wearยาวได้ถึง ~100 ไมครอนเศษรูปเกลียวคล้ายเศษกลึง — มีวัตถุแข็งบุกรุกหรือ Misalignmentผิดปกติเสมอ Severe Sliding> 15 ไมครอนมีรอยขีดข่วนขนาน — โหลด/ความเร็วสูงจนฟิล์มน้ำมันแตกบางส่วนผิดปกติเสมอ Spheres< 5 ไมครอนเกิดในรอยแตกใต้ผิวแบริ่ง — สัญญาณล่วงหน้าของ Rolling Fatigueต้องเฝ้าระวัง Laminar> 50 ไมครอนMicro-spalling ที่ถูกกลิ้งแบนราบใน Rolling Contactเฝ้าระวังใกล้ชิด Non-metallic—สนิม ฝุ่น ใยพืช…
Read More
บทวิเคราะห์: Carbon Digital Twin — เมื่อ CBAM ปี 2026 บังคับให้โรงงานไทยรู้ตัวเลข Emission จริงของทุกชิ้นส่วน

บทวิเคราะห์: Carbon Digital Twin — เมื่อ CBAM ปี 2026 บังคับให้โรงงานไทยรู้ตัวเลข Emission จริงของทุกชิ้นส่วน

Article
ตั้งแต่ 1 มกราคม 2026 มาตรการ CBAM (Carbon Border Adjustment Mechanism) ของสหภาพยุโรปเข้าสู่ช่วง Definitive Period — ผู้นำเข้าสินค้ากลุ่มเหล็ก อะลูมิเนียม ซีเมนต์ ปุ๋ย ไฮโดรเจน และไฟฟ้าใน EU ต้องรายงาน embedded emissions (คาร์บอนที่ฝังอยู่ในสินค้า) และซื้อ CBAM certificate ตามปริมาณคาร์บอนของสินค้าที่นำเข้าทุกปี (ที่มา: กรมศุลกากรไทย, PIER) สำหรับผู้ส่งออกไทย ข้อความนี้แปลเป็นภาษาธุรกิจได้ง่ายๆ: ลูกค้าใน EU จะถามหาตัวเลข emission ระดับสินค้า (product-level) จากโรงงานคุณ — และถ้าคุณตอบไม่ได้ เขาจะใช้ default value ของ EU ซึ่งตั้งอย่างอนุรักษ์นิยม มักสูงกว่าค่าจริงของโรงงานที่บริหารพลังงานดี แปลว่าคุณจ่ายคาร์บอนแพงกว่าที่ควรจ่าย โดยไม่มีสิทธิ์แก้ตัว ทำไม "คาร์บอน" กลายเป็นโจทย์วิศวกรรม ไม่ใช่แค่งานเอกสาร ตัวเลข embedded emissions ที่ EU ต้องการไม่ใช่ค่าเฉลี่ยขององค์กร แต่คือ คาร์บอนต่อหน่วยผลิตภัณฑ์ ที่คำนวณจาก mass balance และ energy balance ของกระบวนการผลิตจริง — พลังงานไฟฟ้าที่ใช้, เชื้อเพลิงที่เผา, วัตถุดิบที่ซื้อเข้า (precursor) ทั้งหมดต้องถูกตรึงกับตัวเลข production จริง นี่คืองานที่ spreadsheet รายเดือนทำได้ยาก เพราะข้อมูลกระจัดกระจายใน metering, SCADA, MES และใบสั่งซื้อ จุดนี้เองที่ทำให้ Digital Twin เชิงคาร์บอน (Carbon Twin) กลายเป็นคำตอบที่ผู้ส่งออกทั่วโลกหันมาพูดถึงกันมากขึ้นในปี 2026 Carbon Twin ทำงานอย่างไร หลักการคือสร้างแบบจำลองที่ผูก กระแสวัสดุ (mass flow) เข้ากับ กระแสพลังงาน (energy flow) ของโรงงานแบบ real-time แล้วคำนวณคาร์บอนตาม emission factor ที่ตรวจสอบย้อนกลับได้: ภาพที่ 1: สถาปัตยกรรม Carbon Twin — ข้อมูล meter, SCADA และ MES ไหลเข้าโมเดล mass-energy balance เพื่อคำนวณ emission ระดับสินค้าและออกรายงาน CBAM/ESG…
Read More
How-to: สร้าง Asset-Level Digital Twin ของเครื่องจักรเดี่ยวใน 6 ขั้นตอน — จาก P&ID สู่โมเดลที่ทำนายได้

How-to: สร้าง Asset-Level Digital Twin ของเครื่องจักรเดี่ยวใน 6 ขั้นตอน — จาก P&ID สู่โมเดลที่ทำนายได้

Article
หลายโรงงานอยากมี Digital Twin แต่เริ่มไม่ถูก — พยายามจำลอง "ทั้งโรงงาน" ตั้งแต่วันแรก แล้วโครงการก็จบก่อนเริ่ม ความจริงคือ Digital Twin ที่สร้างคุณค่าได้จริงส่วนใหญ่เริ่มจากหน่วยที่เล็กที่สุดที่มีความหมายทางธุรกิจ: เครื่องจักรเดี่ยว (Asset-Level Digital Twin) — ปั๊มไฮโดรลิก คอมเพรสเซอร์ ตู้อบ หรือหุ่นยนต์เชื่อม ที่เมื่อหยุดแล้วสายการผลิตหยุดตาม บทความนี้คือคู่มือทีละขั้นตอนสำหรับวิศวกรและผู้จัดการโรงงาน ที่จะพาคุณสร้าง asset twin ตัวแรกให้สำเร็จภายใน 3-6 เดือน โดยไม่ต้องซื้ออะไรเกินจำเป็น ขั้นที่ 1: เลือก Asset ที่ "เจ็บที่สุด" — ไม่ใช่ที่ทันสมัยที่สุด เกณฑ์การเลือกควรใช้ criticality ไม่ใช่ความใหม่ของเครื่องจักร ใช้ผล FMEA (Failure Mode and Effects Analysis) หรือประวัติการเสียจริง 12 เดือนหลังสุด ถาม 3 คำถาม: (1) เครื่องนี้หยุดแล้วกระทบการผลิตมากแค่ไหน (2) อะไหล่หายากแค่ไหน (3) มี sensor ติดอยู่แล้วกี่จุด — เครื่องที่คะแนนสูงสุดคือตัวเริ่มที่ถูกต้อง ขั้นที่ 2: เก็บ "ข้อมูลฐาน" ให้ครบก่อนเขียนโค้ดแม้บรรทัดเดียว Asset twin ที่ดีต้องการข้อมูล 4 ชั้น ซึ่งมักกระจายอยู่ในหลายแผนก: ชั้นข้อมูล ตัวอย่าง แหล่งที่มา Geometryแบบ 3D CAD, P&ID, ผังการเดินสายแผนกวิศวกรรม, ผู้ผลิตเครื่อง Behaviorสมการ dynamics, กราฟประสิทธิภาพ, ค่าคงที่ตัวเครื่องDatasheet, คู่มือเครื่อง, ผลทดสอบ acceptance Telemetryค่า vibration, อุณหภูมิ, กระแสมอเตอร์, แรงดันPLC/SCADA ผ่าน OPC UA หรือ MQTT Knowledgeประวัติซ่อม, บันทึกช่าง, คู่มือ PMCMMS, logbook หน้างาน ภาพที่ 1: Asset-Level Digital Twin ประกอบด้วยข้อมูล 4 ชั้น — Geometry, Behavior, Telemetry และ Knowledge (ที่มา: Honey Corporation) ขั้นที่ 3: เชื่อมข้อมูลจริงเข้าโมเดล — อย่าคัดลอกมาเก็บใน…
Read More
Virtual Commissioning ด้วย Digital Twin: ทดสอบทั้งไลน์ผลิตในโลกเสมือนก่อนสั่งไฟเครื่องจริง

Virtual Commissioning ด้วย Digital Twin: ทดสอบทั้งไลน์ผลิตในโลกเสมือนก่อนสั่งไฟเครื่องจริง

Article
ในโครงการอัตโนมัติทั่วไป ช่วง Commissioning หรือการติดตั้งและทดสอบระบบก่อนส่งมอบ มักกินเวลาถึง 20-30% ของ timeline ทั้งโครงการ และเป็นช่วงที่ปัญหาทุกประเภทพร้อมโผล่พร้อมกัน — logic PLC ผิด, I/O map ไม่ตรง, ทางกลไกชนกัน, สัญญาณ sensor กลับด้าน ทั้งที่เครื่องจักรจริงหยุดรออยู่และทีม production กดดันให้เร็วขึ้นทุกวัน Virtual Commissioning (VC) คือแนวทางที่ย้ายการทดสอบทั้งหมดนั้นไปทำใน "โลกเสมือน" ก่อน — ด้วยการเชื่อม Digital Twin ของเครื่องจักรและสายการผลิต (ทั้งแบบจำลองเชิงกลไก 3D และ physics-based simulation) เข้ากับ โปรแกรมควบคุมจริง (PLC/DCS code) แล้วรันสถานการณ์ทดสอบทั้งหมดก่อนที่อุปกรณ์ชิ้นแรกจะถูกขนถึงหน้างาน หลักการสำคัญ: ยิ่งเจอ error เร็ว ต้นทุนยิ่งถูก แนวคิด "Cost of Change" ในวิศวกรรมระบบอ้างกันมานานว่า ต้นทุนการแก้ไขข้อผิดพลาดเพิ่มขึ้นราว 10 เท่าทุกครั้งที่ข้ามหนึ่งขั้นของโครงการ — แก้ logic ผิดตอนเขียนโปรแกรมอาจใช้เวลาไม่กี่ชั่วโมง แต่ error ตัวเดียวกันที่หลุดไปถึงช่วง commissioning ต้องหยุดเครื่อง รอวิศวกร แก้ code ทดสอบใหม่ และอาจทำให้กำหนดส่งมอบเลื่อนเป็นสัปดาห์ VC ทำงานบนหลักการนี้โดยตรง: ดันการทดสอบให้เกิด "ซ้าย" ของ timeline ให้มากที่สุด ภาพที่ 1: Workflow ของ Virtual Commissioning — สร้างโมเดลเสมือน เชื่อม PLC จริง ทดสอบใน simulation แล้วจึงลง hardware จริง (ที่มา: Honey Corporation) ระดับความสมบูรณ์ของการทดสอบ: จาก MIL ถึง HIL VC ไม่ใช่ all-or-nothing อุตสาหกรรมแบ่งระดับการทดสอบเป็นขั้นบันได โดยแต่ละขั้นให้ความสมจริงและความเชื่อมั่นต่างกัน: ระดับ สิ่งที่ถูกทดสอบ ความสมจริง เหมาะกับ MIL (Model-in-the-Loop)Logic ควบคุมในรูปแบบโมเดล ทดสอบกับ plant modelต่ำ-กลางเช็ค concept และ algorithm ตั้งแต่เฟส design SIL (Software-in-the-Loop)PLC code จริง (soft PLC) รันบน…
Read More
Case Study: รวม 4 เครื่อง HMI/Edge เก่าให้เหลือ Edge Server เครื่องเดียวด้วย Type-1 Hypervisor

Case Study: รวม 4 เครื่อง HMI/Edge เก่าให้เหลือ Edge Server เครื่องเดียวด้วย Type-1 Hypervisor

Article
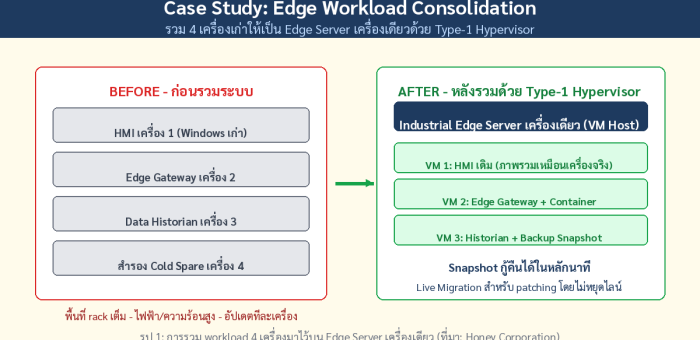
โรงงานประกอบชิ้นส่วนแห่งหนึ่งใน ร.น. มีปัญหาที่หลายโรงงานคุ้นเคย: ตู้คอนโทรลหน้าไลน์ผลิตมีคอมพิวเตอร์ถึง 4 เครื่อง — เครื่อง HMI ที่รัน Windows เวอร์ชันเก่าพร้อมโปรแกรมที่ vendor เดิมไม่มีมา update แล้ว, เครื่อง Edge Gateway เก็บข้อมูลเครื่องจักร, เครื่อง Data Historian และ Cold Spare อีกหนึ่งเครื่อง เครื่องไหนพังก็สลับเครื่อง การอัปเดต security patch ต้องทำทีละเครื่อง และเมื่อ HMI หลักเสียครั้งล่าสุด ทีม IT ใช้เวลากว่า 2 วันเต็มกว่าจะติดตั้งระบบกลับมาเหมือนเดิม บทความนี้เล่าว่าการรวมทั้งหมดมาไว้บน Edge Server เครื่องเดียวด้วย Type-1 Hypervisor เปลี่ยนสถานการณ์นี้อย่างไร รูป 1: การรวม workload จาก 4 เครื่องมาไว้บน Edge Server เครื่องเดียว (ที่มา: Honey Corporation) ปัญหา (Problem) เวลากู้คืนยาว: HMI พัง = ติดตั้ง OS + โปรแกรม + restore config ใหม่ทั้งหมด ใช้เวลา 2-3 วัน ระหว่างนั้น operator ดูค่าหน้าเครื่องไม่ได้ ภาระดูแล 4 เท่า: patch 4 เครื่อง 4 รอบ บางเครื่อง OS เก่าจนหา driver ยาก ทรัพยากรกระจาย: rack หน้าไลน์เต็ม ค่าไฟ ความร้อนสะสม และไม่มีสำรองที่ sync กันจริง ทางแก้ (Solution): Type-1 Hypervisor บน Edge Server เครื่องเดียว หัวใจของทางแก้คือการเลือก Type-1 (bare-metal) Hypervisor คือซอฟต์แวร์เสมือนมิได้รัน "บน" Windows หรือ Linux แต่รันบนฮาร์ดแวร์โดยตรง แล้วจำลองเครื่องเสมือน (VM) หลายเครื่องที่แยกกันสนิท การแบ่ง Type-1 กับ Type-2 (hosted) นี้มีมาตั้งแต่งานวิจัยคลาสสิกของ Goldberg ปี…
Read More
eBPF ที่ Edge ของโรงงาน: Observability และ Security ระดับ Kernel ที่ Agent แบบเดิมทำไม่ได้

eBPF ที่ Edge ของโรงงาน: Observability และ Security ระดับ Kernel ที่ Agent แบบเดิมทำไม่ได้

Article
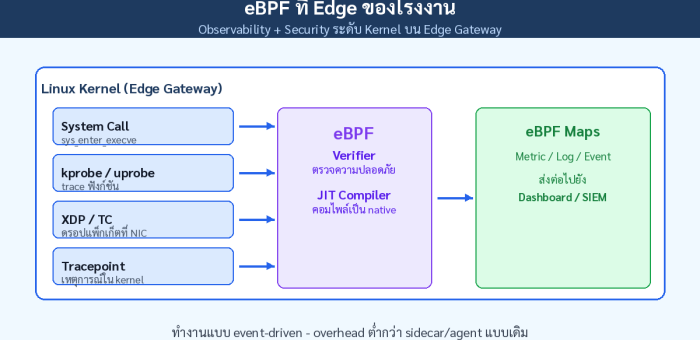
ถ้าคุณดูแล Edge Gateway ที่รัน Linux อยู่หน้าโรงงาน น่าจะคุ้นเคยกับภาพนี้: เครื่องหนึ่งต้องลง agent เก็บ metric อีกตัวเก็บ log อีกตัวเฝ้า security และอีกตัวดักจับ network — แต่ละตัวกิน CPU กันคนละเปอร์เซ็นต์ และต้องอัปเดตแยกกันคนละรอบ คำถามที่วงการ infrastructure เริ่มตอบด้วยเทคโนโลยีเดียวคือ eBPF (extended Berkeley Packet Filter) เทคโนโลย์จาก Linux kernel ที่ให้โปรแกรมขนาดเล็ก "รันอยู่ใน kernel" เพื่อเก็บข้อมูลและบังคับใช้นโยบายความปลอดภัยได้โดยตรง รูป 1: สถาปัตยกรรม eBPF บน Edge Gateway — hook รับเหตุการณ์ ผ่าน verifier และ JIT compiler แล้วส่งข้อมูลผ่าน maps (ที่มา: Honey Corporation) eBPF คืออะไร และทำไมมันปลอดภัยพอให้ใช้ในโรงงาน eBPF พัฒนาต่อจาก Berkeley Packet Filter เดิมที่ทำหน้าที่กรองแพ็กเก็ตเท่านั้น ปัจจุบันเป็นกลไกที่ให้โปรแกรม sandbox ทำงานในบริบท privileged ของ kernel โดยไม่ต้องแก้ source code ของ kernel หรือโหลด kernel module ตัวหลักที่ทำให้เราวางใจได้คือ Verifier ซึ่งตรวจทุกเส้นทางการทำงานของโปรแกรมก่อนรันจริง ว่าไม่มีการเข้าถึงหน่วยความจำนอกเขต ไม่วนลูปไม่รู้จบ และจบการทำงานภายในขีดจำกัดที่กำหนด จากนั้น JIT compiler จะคอมไพล์โปรแกรมให้เป็น machine code ที่ทำงานเร็วเทียบ native การทำงานเป็นแบบ event-driven: โปรแกรม eBPF จะถูกเรียกเมื่อเกิดเหตุการณ์ที่ "hook point" เช่น การเรียก system call, การเข้า-ออกฟังก์ชันใน kernel (kprobe) หรือแม้แต่ฟังก์ชันในแอปพลิเคชันเราเอง (uprobe) และเหตุการณ์ network ระดับ NIC ผ่าน XDP รูป 2: 4 กลุ่ม hook หลักที่ใช้ได้บน Edge Gateway ที่รัน Linux (ที่มา: eBPF.io documentation, Honey…
Read More
บทวิเคราะห์: Offline-First และ CRDT — เมื่อโรงงานหลายไซต์เลิกรอเน็ตจึงจะ sync ข้อมูลได้

บทวิเคราะห์: Offline-First และ CRDT — เมื่อโรงงานหลายไซต์เลิกรอเน็ตจึงจะ sync ข้อมูลได้

Article
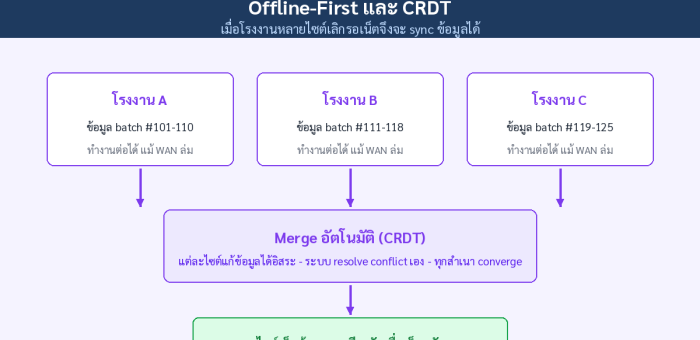
คำถามคลาสสิกของโรงงานหลายไซต์คือ "ข้อมูลควรอยู่ที่ไหน" — คำตอบยุคก่อนมักเป็น centralized ทั้งหมดขึ้น cloud แล้วให้ทุกไซต์ดึงจากศูนย์กลาง แต่ทุกคนที่เจอ WAN ล่มตอนกลางกะดีนหรือ fiber ถูกขุดด้วยคนงานหน้างานรู้ว่าสถาปัตยกรรมแบบนั้นแพงเกินไป บทวิเคราะห์นี้มองไปอีกทาง: Offline-First โดยใช้แนวคิด CRDT (Conflict-free Replicated Data Type) ที่กำลังเป็นกระแสในวงการ software เพื่อโรงงาน รูป 1: แนวคิด offline-first — ทุกไซต์ทำงานต่อได้แม้เน็ตหลุด แล้ว merge ข้อมูลอัตโนมัติเมื่อเชื่อมกลับมา (ที่มา: Honey Corporation) Store-and-Forward แก้ได้ครึ่งเดียวของปัญหา แนวทางที่โรงงาน IIoT ใช้กันทุกวันนี้คือ store-and-forward: edge gateway เก็บข้อมูลไว้ในเครื่อง เมื่อเน็ตกลับมาค่อยส่งขึ้น cloud แบบไม่สูญหาย วิธีนี้แก้ปัญหา ทิศทางเดียว — ข้อมูลจาก sensor ขึ้น cloud ได้ครบ แต่ทิศกลับกันไม่ได้ถูกออกแบบ ถ้าสองไซต์ต้อง "เขียน" ข้อมูลชุดเดียวกันขณะออฟไลน์ (เช่น ปรับ production order, บันทึกผลแม่พิมพ์ หรือแก้ setpoint) เมื่อเน็ตกลับมา ระบบส่วนใหญ่จะเลือกวิธีง่ายที่สุด: Last-Writer-Wins (LWW) เก็บเฉพาะฝั่งที่เขียนทีหลัง และทิ้งอีกฝั่งเงียบๆ CRDT คืออะไร CRDT ถูกนิยามอย่างเป็นทางการเมื่อปี 2011 โดยกลุ่มนักวิจัยนำโดย Marc Shapiro โดยมีคุณสมบัติ 3 ข้อที่น่าสนใจสำหรับโรงงาน: แต่ละสำเนา (replica) แก้ข้อมูลได้อิสระ โดยไม่ต้องประสานงานกับสำเนาอื่นระหว่างทำงาน อัลกอริทึมเป็นส่วนหนึ่งของโครงสร้างข้อมูลเอง ที่ resolve ความขัดแย้งโดยอัตโนมัติ ทุกสำเนาจะ converge ไปสู่ค่าเดียวกันในที่สุด (strong eventual consistency) โดย merge function ต้องเป็นไปตามคุณสมบัติ commutative, associative และ idempotent — ทำให้ลำดับและการซ้ำของการ sync ไม่กระทบผลลัพธ์ มีสองตระกูลหลัก: state-based (CvRDT) ที่ส่งสถานะเต็มไป merge และ operation-based ที่ส่งเฉพาะคำสั่งการเปลี่ยนแปลง รวมถึงรุ่นปรับปรุงอย่าง delta CRDT ที่ส่งเฉพาะส่วนที่เปลี่ยน เหมาะกับลิงก์ WAN ที่แพงและไม่เสถียรแบบที่โรงงานต่างจังหวัดเจอกันจริง รูป 2: สถาปัตยกรรม local-first สามชั้น…
Read More
Case Study: หุ่นยนต์ 400,000 ตัวที่ “เรียนงานจากช่างฝีมือ” — Embodied Learning, งบปรับปรุงโรงงาน 6,400 ล้านดอลลาร์ต่อปี และสัญญาณ Physical AI จากดีล M&A 675 ล้านดอลลาร์

Case Study: หุ่นยนต์ 400,000 ตัวที่ “เรียนงานจากช่างฝีมือ” — Embodied Learning, งบปรับปรุงโรงงาน 6,400 ล้านดอลลาร์ต่อปี และสัญญาณ Physical AI จากดีล M&A 675 ล้านดอลลาร์

Article
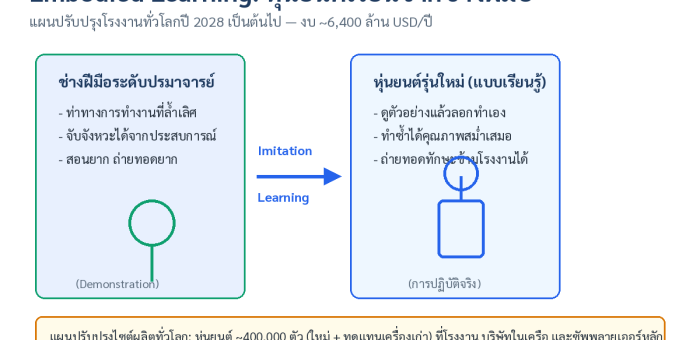
ข่าวใหญ่ปลายไตรมาส 3/2026 จากผู้ผลิตรถยนต์รายใหญ่ที่สุดของญี่ปุ่นให้สัญญาณที่โรงงานทั่วโลกต้องอ่านให้ขาด: ตั้งแต่ปี 2028 บริษัทจะลงทุนประมาณ 6,400 ล้านดอลลาร์ต่อปี ปรับปรุงไซต์ผลิตทั่วโลก พร้อมส่งหุ่นยนต์ราว 400,000 ตัว (ทั้งเครื่องใหม่และทดแทนเครื่องเก่า) ลงโรงงาน บริษัทในเครือ และซัพพลายเออร์หลัก — และหัวใจของแผนนี้ไม่ใช่ความเร็วหุ่นยนต์ แต่คือวิธีที่มัน "เรียนรู้" Embodied Learning: ช่างฝีมือระดับปรมาจารย์สาธิต (Demonstration) → หุ่นยนต์เรียนและลอกแบบท่าทางผ่าน Imitation Learning (ที่มา: เรียบเรียงจากงานนักลงทุน ก.ย. 2026 รายงานโดยสื่อการเงินระดับโลก) Problem: ทักษะปรมาจารย์ที่ถ่ายทอดไม่ได้ ในโรงงานการผลิตทุกแห่ง ทักษะของช่างฝีมืออาวุโสคือ "ทรัพย์สินที่หายไปเมื่อคนเกษียณ" งานประจำ เช่น การประกอบชิ้นส่วนที่ต้องอาศัยจังหวะ แรงบิด และความรู้สึกที่สั่งสมมาหลายสิบปี ถ่ายทอดด้วยเอกสารไม่ได้ หุ่นยนต์อุตสาหกรรมแบบดั้งเดิมจึงทำงานเหล่านี้แทนไม่ได้ เพราะต้องโปรแกรมทุกท่าทางล่วงหน้าแบบตายตัว ขณะที่ปัญหาขาดแรงงานฝีมือของไทยกำลังรุนแรงขึ้นทุกปี Solution: หุ่นยนต์ที่เรียนโดย "ดูตัวอย่าง" ในงานนักลงทุนเมื่อเดือนกันยายน ที่ศูนย์บริหารภูมิภาคยุโรป บริษัทได้สาธิตหุ่นยนต์ตัวใหม่ที่พัฒนาเองภายในองค์กร โดยมีชื่อย่อมาจากแนวคิด "Embodied Learning robot for Enhanced Yield" — หุ่นยนต์ขนาดเล็กกว่าหุ่นยนต์อุตสาหกรรมทั่วไป ที่เรียนรู้งานจากการดูช่างฝีมือทำจริงแล้วลอกแบบ (Imitation Learning) แทนการโปรแกรมทีละท่า แนวทางนี้เปลี่ยนเกมเพราะ: เวลาตั้งค่างานใหม่สั้นลงมาก — สาธิตไม่กี่ครั้ง หุ่นยนต์ก็เริ่มทำงานได้ แทนการโปรแกรมหลายวัน ทักษะถ่ายทอดได้ทั่วทั้งกลุ่มบริษัทและซัพพลายเออร์ — 400,000 ตัวหมายถึงเครือข่ายที่แชร์บทเรียนร่วมกัน ออกแบบมาเพื่ออยู่ร่วมกับคน (Coexist) — ไม่ใช่กรงขังเหล็กแบบหุ่นยนต์ดั้งเดิม สัญญาณยืนยันจากตลาด M&A: Physical AI กำลังถูกซื้อ ไม่กี่สัปดาห์ก่อนหน้า ยักษ์ใหญ่ด้านระบบออโตเมชันและเซ็นเซอร์ของญี่ปุ่นประกาศเข้าซื้อบริษัทผู้ผลิตคอมพิวเตอร์อุตสาหกรรมสัญชาติอเมริกันในราคา 675 ล้านดอลลาร์ (คาดปิดดีลต้นปี 2027) เป้าหมายชัดเจน: หลอมรวมเซ็นเซอร์+ระบบควบคุม+หุ่นยนต์ เข้ากับพลังการประมวลผลหน้างาน เพื่อสร้าง Physical AI — ระบบที่ประมวลผลข้อมูลมหาศาลจากเซ็นเซอร์ได้ทันที "หน้างาน" แบบ Real-time แทนการรอส่งขึ้นคลาวด์ เช่นระบบตรวจคุณภาพอัตโนมัติที่พบชิ้นงานผิดมาตรฐานแล้วสั่งปรับกระบวนการได้ทันทีแบบไร้รอยต่อ (Closed-loop Manufacturing) สถาปัตยกรรม 4 ชั้นของ Physical AI บนสายการผลิต: รับรู้ → คำนวณหน้างาน → ตัดสินใจ → ปรับเครื่องจักรจริง (ที่มา: เรียบเรียงจาก metrology.news) Results และสิ่งที่โรงงานไทยควรทำตอนนี้ สัญญาณจากข่าว ความหมายต่อโรงงานไทย งบปรับปรุงไซต์ผลิต 6,400 ล้านดอลลาร์/ปี เริ่มปี…
Read More
How-to: เตรียมโรงงานเข้าโครงการ IDA Quick Win ของ ส.อ.ท. ร่วมกับ NECTEC — คว้าโควตา 20 โรงงานนำร่อง Smart OEE และ Energy Monitoring

How-to: เตรียมโรงงานเข้าโครงการ IDA Quick Win ของ ส.อ.ท. ร่วมกับ NECTEC — คว้าโควตา 20 โรงงานนำร่อง Smart OEE และ Energy Monitoring

Article
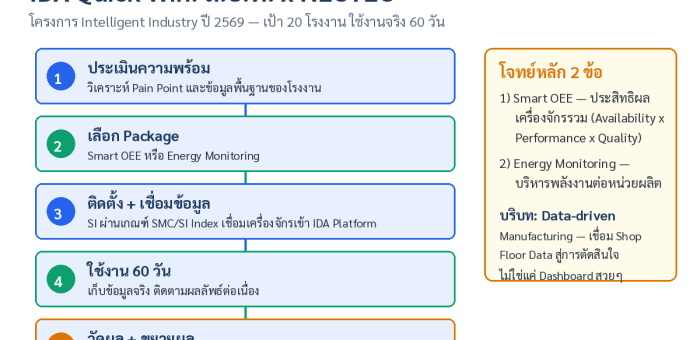
เมื่อ 10 กันยายน 2569 สภาอุตสาหกรรมแห่งประเทศไทย (ส.อ.ท.) โดยสถาบันดิจิทัลเพื่ออุตสาหกรรม (IDTI) ร่วมกับ NECTEC และศูนย์นวัตกรรมการผลิตยั่งยืน (SMC) เปิดตัวโครงการ "Intelligent Industry Quick Win Project" เพื่อสนับสนุนผู้ประกอบการไทยเปลี่ยนผ่านสู่ Smart Factory ด้วยแพลตฟอร์ม IDA (Industrial IoT and Data Analytics Platform) โดยตั้งเป้าคัดเลือก ไม่น้อยกว่า 20 โรงงานนำร่อง ให้ติดตั้งและใช้งานระบบจริงต่อเนื่อง อย่างน้อย 60 วัน เพื่อพิสูจน์ผลลัพธ์ด้าน Productivity และ Energy Management ภาพรวมโครงการ Intelligent Industry Quick Win ปี 2569: เป้าหมาย โจทย์หลัก และกระบวนการ 5 ขั้น (ที่มา: ข่าว ส.อ.ท. 10 ก.ย. 2569) โครงการนี้ตอบโจทย์อะไร หัวใจของโครงการคือการยกระดับสู่ยุค Data-driven Manufacturing — เชื่อมข้อมูลหน้างาน (Shop Floor Data) เข้าสู่การวิเคราะห์ เพื่อใช้ตัดสินใจ วางแผนการผลิต ติดตามประสิทธิภาพเครื่องจักร และบริหารพลังงานอย่างต่อเนื่อง โดยเน้น 2 โจทย์หลัก คือ Smart OEE (ประสิทธิผลโดยรวมของเครื่องจักร) และ Energy Monitoring (การบริหารพลังงาน) จุดสำคัญที่ ส.อ.ท. เน้นย้ำ: เป้าหมายไม่ใช่ "ติดตั้งเทคโนโลยี" หรือ Dashboard สวยๆ แต่ต้องนำ Data Insight ไปลด Downtime ลดพลังงานที่ไม่จำเป็น และเพิ่ม OEE ได้จริง 6 ขั้นตอนเตรียมโรงงานก่อนสมัคร ทำแผนผังกระบวนการผลิตให้ชัดตั้งแต่วัตถุดิบถึงสินค้า — ระบุว่าคอขวดอยู่จุดไหน เครื่องจักรหลักที่ควรต่อข้อมูลก่อนคือตัวไหน (เลือก 3–5 เครื่องแรกที่กระทบกำไรมากที่สุด) เก็บข้อมูลพื้นฐาน 30 วัน — จำนวนชั่วโมงหยุดเครื่อง สาเหตุการหยุด จำนวนชิ้นงานดี/เสีย และค่าไฟฟ้ารายเดือนแยกตามพื้นที่ ข้อมูลชุดนี้คือ Baseline ที่จะใช้วัดผลภายหลังติดตั้ง เช็คเครื่องจักรว่าต่อข้อมูลได้แค่ไหน — เครื่องที่มีพอร์ตอุตสาหกรรมมาตรฐาน (เช่น OPC UA หรือ Modbus)…
Read More