Agent-Based Simulation และ Knowledge Graph: เมื่อ Digital Twin เลิกรอคำสั่ง แล้วให้ทุกเครื่องจักรคิดเอง

Agent-Based Simulation และ Knowledge Graph: เมื่อ Digital Twin เลิกรอคำสั่ง แล้วให้ทุกเครื่องจักรคิดเอง

Article
เมื่อ Digital Twin เลิกเป็น "หุ่นยนต์เดินตามคำสั่ง": ทำไม Simulation ยุคใหม่ต้องให้ทุกเครื่องจักร "คิดเอง" ถ้าถามว่า Digital Twin คืออะไร คำตอบส่วนใหญ่คือ "โมเดลจำลองโรงงานที่ซิงก์ข้อมูล Real-Time" คำตอบนั้นถูกต้อง — แต่ไม่เพียงพออีกต่อไปแล้ว ปัญหาของ Twin แบบดั้งเดิมคือมันเป็น โมเดลเดี่ยวที่ต้องรอคนสั่ง: อยากรู้ว่าถ้าเพิ่มความเร็วคอนเวเยอร์ 15% จะเกิดอะไรขึ้น ต้องมีวิศวกรมานั่งตั้งค่า รัน What-If แล้วรอผล แนวโน้มใหม่ที่งานวิจัยระดับโลกกำลังพิสูจน์คือการผสาน Agent-Based Simulation (ABS) เข้ากับ Digital Twin — แทนที่จะสร้างโมเดลใหญ่หนึ่งเดียวที่คำนวณทุกอย่างพร้อมกัน ให้แต่ละองค์ประกอบในโรงงาน (เครื่องจักร, AGV, คนงาน, คลังสินค้า) กลายเป็น "เอเจนต์" ที่มีกฎการตัดสินใจของตัวเอง แล้วปล่อยให้พวกมันโต้ตอบกันเอง เหมือนโรงงานจริงที่ไม่มีใครสั่งการทุกจุด ระบบผลิตที่ซับซ้อน มีพฤติกรรม "อุบัติเหตุ" ที่ไม่มีสมการใดพรรณนาได้ — ภาพ: Wikimedia Commons สิ่งที่สมการเดี่ยวทำไม่ได้: Emergent Behavior จุดขายที่แท้จริงของ Agent-Based Simulation คือการจับ Emergent Behavior — พฤติกรรมที่เกิดขึ้นจากการโต้ตอบของส่วนย่อยจำนวนมาก แต่ไม่สามารถคาดเดาได้จากการดูส่วนย่อยแต่ละชิ้นแยกกัน ตัวอย่างคลาสสิกในโรงงาน: Deadlock ที่คลังสินค้า — AGV 8 คันไม่มีคันไหนผิดกติกา แต่ลำดับการเข้า-ออกของทั้งระบบในวันที่ Order เยอะทำให้ติดกับแก่นกันเอง คอขวดที่เคลื่อนตำแหน่ง — Buffer หน้าเครื่องจักรเครื่องหนึ่งเต็มทุกวัน เมื่อเพิ่มกำลังเครื่องนั้น คอขวดกลับไปโผล่ที่จุดที่ไม่มีใครคาดคิด ผลกระทบลูกโซ่ของ Breakdown — เครื่องหนึ่งหยุด 30 นาที ทำไม WIP ในส่วนอื่นของโรงงานแทบไม่ขยับ แต่บางครั้งหยุดแค่ 10 นาทีกลับสร้างความปั่นป่วนทั้งกะ ปรากฏการณ์เหล่านี้เกิดจาก ความแปรปรวนทางสถิติ (Stochastic Variability) ของเวลาทำงาน เวลารอ และลำดับเหตุการณ์ — สิ่งที่ Discrete-Event Simulation แบบดั้งเดิมจำลองได้ระดับหนึ่ง แต่การเพิ่ม "ตัวตนและกฎการตัดสินใจ" ให้แต่ละเอเจนต์ทำให้โมเดลสะท้อนความจริงได้ลึกกว่า โดยเฉพาะเมื่อมีคนและระบบอัตโนมัติทำงานปนกัน หลักฐานจากงานวิจัย: โมเดล 3 ชั้น + Knowledge Graph งานวิจัยที่ตีพิมพ์ในวารสาร Scientific Reports (2025) ได้สาธิตแนวทางนี้ด้วยสถาปัตยกรรมที่น่าสนใจ: แทนที่จะปล่อยให้เอเจนต์ "คิดเองเลือกอะไรก็ได้" พวกเขาคุมโครงสร้างความรู้ด้วย Knowledge Graph…
Read More
How-to: ออกแบบระบบ Wireless Vibration Monitoring ตั้งแต่ Fmax ถึง Battery Life — คู่มือ 6 ขั้นตอนสำหรับทีมผู้ดูแลโรงงาน

How-to: ออกแบบระบบ Wireless Vibration Monitoring ตั้งแต่ Fmax ถึง Battery Life — คู่มือ 6 ขั้นตอนสำหรับทีมผู้ดูแลโรงงาน

Article
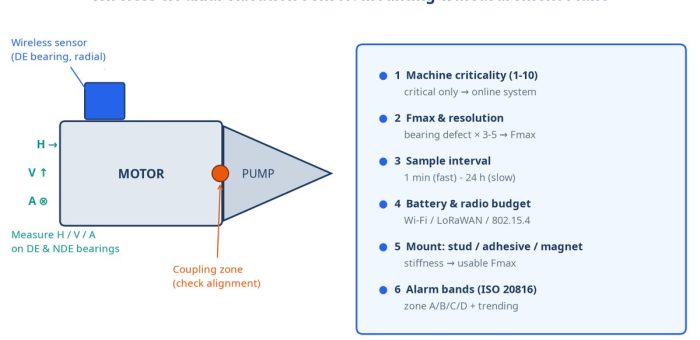
คำถามที่ทีมวิศวกรรมของ Honey Corporation ได้ยินบ่อยที่สุดเมื่อเริ่มโครงการ Predictive Maintenance คือ “เซ็นเซอร์ไร้สายตัวนี้ แบตอยู่ได้กี่ปี” — คำตอบที่ตรงประเด็นไม่ใช่ตัวเลขจากโบรชัวร์ แต่คือ การออกแบบ sampling strategy ให้สอดคล้องกับ failure mode ของเครื่องจักร บทความนี้รวมกระบวนการคิดทั้งหมดเป็น 6 ขั้นตอนที่ทีมใช้จริงในโครงการติดตั้งระบบมอนิเตอริ่งในโรงงานอุตสาหกรรม ขั้นที่ 1 — จัดลำดับเครื่องจักรตาม Criticality ก่อนซื้อเซ็นเซอร์สักตัว อย่าเพิ่งถามว่า “ติดกี่จุด” จนกว่าจะรู้ว่าเครื่องไหน “เสียแล้วเจ็บ” ใช้การประเมิน Criticality แบบ 1-10 ที่พิจารณาทั้ง Safety, Production Impact, Redundancy และ Repair Lead Time: คะแนน 8-10 (Critical): เครื่องหลักไม่มี spare เช่น ปั๊มหลัก boiler feed pump — เหมาะกับระบบ online ต่อเนื่อง คะแนน 5-7 (Essential): มี standby สลับกัน หรือหยุดได้ไม่เกินชั่วโมง — เหมาะกับ wireless วัดเป็นรอบ คะแนน 1-4 (General): มี stock สำรอง เปลี่ยนง่าย — พอด้วย route-based ด้วย handheld ประสบการณ์จากหลายโครงการคือ จำนวนเครื่องวิกฤติจริงมักไม่เกิน 10-15% ของเครื่องจักรทั้งโรงงาน — การเริ่มจากกลุ่มนี้ทำให้โครงการนำร่องเห็นผลเร็วและคุ้มค่าที่สุด ขั้นที่ 2 — คำนวณ Fmax จาก Bearing Frequency ความถี่สูงสุดที่ต้องเก็บ (Fmax) ไม่ใช่ตัวเลขลอยๆ แต่คำนวณจาก ความถี่ความเสียหายของแบริ่ง (BPFO/BPFI/BSF) คูณ 3-5 เท่า เพื่อให้เห็นทั้ง harmonic และ sideband: เครื่องจักร ความเร็วรอบ BPFO โดยประมาณ Fmax ที่แนะนำ Resolution (ล. ต่อรอบ) ปั๊มได้น้ำ / มอเตอร์ 2,950 rpm ~148 Hz 1-2 kHz ( waveform) /…
Read More
บทวิเคราะห์: Weibull Analysis กับกลยุทธ์บำรุงรักษา — ทำไม β คือคำตอบของคำถาม ‘ควรซ่อมตามเวลา หรือซ่อมตามสภาพ’

บทวิเคราะห์: Weibull Analysis กับกลยุทธ์บำรุงรักษา — ทำไม β คือคำตอบของคำถาม ‘ควรซ่อมตามเวลา หรือซ่อมตามสภาพ’

Article
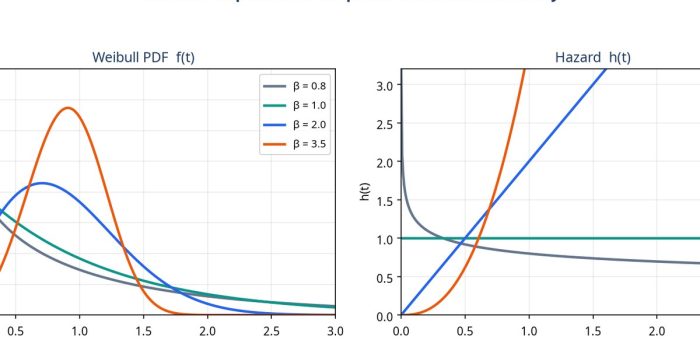
หลายโรงงานตั้ง schedule งาน preventive maintenance (PM) ด้วยเหตุผลเดียว: “เคยทำมาอย่างนี้” ทุก 3 เดือน ทุก 6 เดือน ทุกปี — คำถามคือ ตัวเลขเหล่านี้มีที่มาจากข้อมูลความล้มเหลวจริง หรือเป็นเพียงความเคยชิน? เครื่องมือสถิติที่ตอบคำถามนี้ตรงที่สุดคือ Weibull Analysis — การวิเคราะห์การแจกแจงความล้มเหลวที่ใช้ในอุตสาหกรรมการบินและอวกาศมาตั้งแต่ทศวรรษ 1950 และวันนี้กลายเป็นหัวใจของ data-driven maintenance ในโรงงานอุตสาหกรรมทั่วโลก และเมื่อรวมกับเซ็นเซอร์ IIoT ที่เก็บ condition data ได้ต่อเนื่อง Weibull ไม่ได้แข่งกับ Predictive Maintenance — แต่เป็น ชั้นข้อมูลที่บอกว่าเครื่องจักรแต่ละแบบควรถูกเฝ้าดูแบบไหน Weibull ใน 60 วินาที: สองพารามิเตอร์ที่อธิบายทุกเรื่องราว การแจกแจง Weibull อธิบายด้วยพารามิเตอร์สองตัว: β (beta) shape parameter และ η (eta) characteristic life โดย β บอก “รูปแบบการตาย” ของอุปกรณ์: β < 1: อัตราการล้มเหลวลดลงตามอายุ (Infant Mortality) — พบในอุปกรณ์ใหม่ที่มี defect จากการผลิต/ติดตั้ง β = 1: ล้มเหลวสุ่ม (Random) — ไม่มีอายุขัยที่ “ควรซ่อม” การตั้ง PM เป็นการทำให้แย่ลง (PM ตัวเองคือความเสี่ยง) β > 1: ล้มเหลวเพิ่มตามอายุ (Wear-out) — แน่นอนว่าเครื่องจักรกลไกส่วนใหญ่อยู่ในกลุ่มนี้ และเป็นกลุ่มที่ PM ทำงานได้ดี ภาพประกอบ: ซ้าย: PDF ของ Weibull ที่ β ต่างกัน / ขวา: hazard function — β > 1 คือโซนที่ preventive maintenance มีคุณค่า ส่วน β ≤ 1 คือโซนที่ PM ต้องถูกท้าทาย เมื่อโรงงานเก็บ CMMS Data แต่ไม่เคยวิเคราะห์ ปัญหาที่พบซ้ำๆ ในโรงงานไทย:…
Read More
Partial Discharge Monitoring: ฟังเสียงกระซิบของฉนวนก่อนที่ตู้สวิตช์เกียร์ MV จะกลายเป็นหน้าข่าว

Partial Discharge Monitoring: ฟังเสียงกระซิบของฉนวนก่อนที่ตู้สวิตช์เกียร์ MV จะกลายเป็นหน้าข่าว

Article
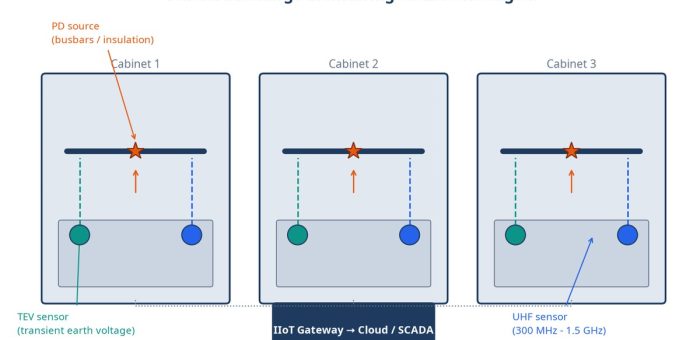
ไฟดับทั้งโรงงานตอนกลางคืน ปฏิบัติการผลิตหยุดนิ่ง 6-8 ชั่วโมง เสียหายของวัตถุดิบในกระบวนการ และค่าแรงช่างกะดึก — นี่คือราคาที่โรงงานหลายแห่งจ่ายไปก่อนจะรู้จักคำว่า Partial Discharge (PD) หรือ “การคายประจุบางส่วน” ปรากฏการณ์เงียบๆ ที่เกิดขึ้นภายในระบบฉนวนของตู้สวิตช์เกียร์แรงกลาง (MV Switchgear) ทุกครั้งที่ความเครียดไฟฟ้า (Electrical Stress) มากกว่าที่ฉนวนจะรับไหว แต่ยังไม่ถึงจุดลัดวงจรเต็มรูปแบบ จุดสำคัญคือ PD เกิดขึ้น เป็นเดือนหรือเป็นปีก่อนความเสียหายรุนแรงเกิดขึ้นจริง — IEEE และ CIGRE รายงานมาต่อเนื่องว่าการเสื่อมสภาพของฉนวนเป็นหนึ่งในสาเหตุอันดับต้นๆ ของความล้มเหลวของสวิตช์เกียร์แรงกลาง และ PD Monitoring แบบถาวร (Online Continuous Monitoring) ช่วยให้ทีมไฟฟ้าเห็นสัญญาณตั้งแต่ระยะแรก ที่ซ่อมแซมยังเป็นเรื่อง “วางแผน” ไม่ใช่ “ดับเพลิง” PD คืออะไร — และทำไมต้องวัดเป็นหน่วย pC PD คือประกายไฟจิ๋วที่เกิดใน “ช่องโหว่” ของฉนวน เช่น ฟองอากาศติดในเรซิน (Void) รอยต่อที่หลุดร่อน หรือขอบแหลมของตัวนำที่สนามไฟฟ้าเข้มข้นเกินไป แต่ละครั้งที่ประกายเกิด มันปล่อยประจุออกมาเป็นพัลส์สั้นๆ (นาโนวินาที) ที่วัดได้เป็น picocoulomb (pC) ตามมาตรฐาน IEC 60270 ซึ่งเป็นเกณฑ์สากลของการวัด PD แบบดั้งเดิม (Conventional PD Measurement) แต่ปริมาณประจุเพียงอย่างเดียวไม่พอตัดสิน ตัวชี้วัดที่สำคัญไม่แพ้กันคือ อัตราการเพิ่มขึ้นของ PD Activity ตามเวลา (Trend) — ตู้ที่ PD คงที่ 200 pC มาสามปี กับตู้ที่กระโดดจาก 100 เป็น 800 pC ในสองเดือน คนละเรื่องกันสิ้นเชิง ระบบมอนิเตอริ่งสมัยใหม่จึงเน้นเก็บแนวโน้มต่อเนื่องแทนการดูค่าจุดเดียว (Spot Measurement) 3 เทคโนโลยีเซ็นเซอร์หลัก: TEV, UHF และ Acoustic เพราะสัญญาณ PD เป็นพัลส์ความถี่สูงมาก การ “ดักฟัง” จึงมีได้หลายช่องทาง แต่ละแบบมีจุดแข็งต่างกัน — โครงการจริงมักใช้ผสมกัน: วิธีวัด หลักการ ช่วงความถี่ จุดแข็ง ข้อจำกัด TEV (Transient Earth Voltage) ดักความต่างศักย์ชั่วขณะบนผิวโลหะของตู้ 3-100 MHz ติดตั้งภายนอกตู้ ไม่ต้องดับไฟ สัญญาณเบาบาง อ่านเป็น dB ไม่ใช่…
Read More
บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

Article
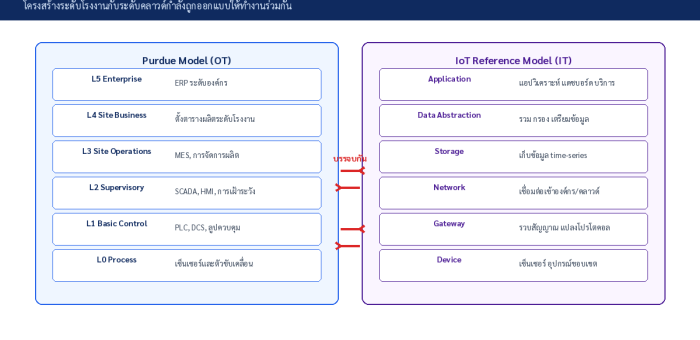
ช่วงสองสามปีที่ผ่านมา วิศวกรโรงงานไทยหลายท่านน่าจะเจอบทสนทนาแบบนี้: “เราควรเอาขึ้นคลาวด์หรือทำ edge ก่อน” คำถามดูเหมือนมีเหตุผล แต่ถ้าดูตัวเลขตลาดล่าสุดแล้ว จะพบว่านี่คือกรอบคิดที่กำลังล้าสมัย เพราะโลกไม่ได้กำลังเลือกระหว่างสองฝั่ง แต่กำลังเติบโต ทั้งสองฝั่งพร้อมกันอย่างก้าวกระโดด ตัวเลขที่ต้องรู้ก่อนตัดสินใจ รายงานล่าสุดของ Grand View Research ระบุว่าตลาด Edge Computing โลกมีมูลค่า 33.4 พันล้านดอลลาร์ในปี 2025 และประมาณการไว้ที่ 46.7 พันล้านดอลลาร์ในปี 2026 ก่อนจะขยายต่อไปถึง 328 พันล้านดอลลาร์ภายในปี 2033 คิดเป็น CAGR 32.1% ตลอดช่วง 2026–2033 — นี่คืออัตราเติบโตที่เร็วกว่าภาพรวมของ smart manufacturing ที่ IoT Analytics ประเมินไว้ที่ CAGR 9.3% (จาก 175 พันล้านดอลลาร์ในปี 2025 สู่ 274 พันล้านดอลลาร์ในปี 2030) ถึงสามเท่าครึ่ง ทำไมถึงเร็วขนาดนั้น? เพราะ edge ไม่ได้แข่งกับคลาวด์ แต่กำลัง เปิดกล่อง use case ใหม่ที่คลาวด์ทำไม่ได้ และเอเชียแปซิฟิกคือภูมิภาคที่โตเร็วที่สุด — Grand View Research ระบุ CAGR ของภูมิภาคเราที่ราว 39% สูงกว่าค่าเฉลี่ยโลก ซึ่งสอดคล้องกับการลงทุน infrastructure ดิจิทัลของไทยในช่วงนี้ Purdue Reference Model เทียบกับ IoT Reference Model — โครงสร้างระดับโรงงานกับระดับคลาวด์กำลังถูกออกแบบให้ทำงานร่วมกัน ไม่ใช่แยกกัน — ภาพ: Wikimedia Commons (CC BY-SA 4.0) คำถามที่ถูกต้อง: Workload นี้ควรอยู่ที่ไหน แทนที่จะถามว่า “เอาขึ้นคลาวด์หรือ edge” ให้ถามว่า “workload นี้มีคุณสมบัติอะไร” แล้วให้คุณสมบัตินั้นตัดสินใจแทน โดยเฉพาะสี่มิติที่ตัดสินได้ชัดเจนที่สุด: มิติการตัดสินใจ ชี้ไปทาง Edge ชี้ไปทาง Cloud Latency ที่ยอมรับได้ ต่ำกว่า ~50 ms เช่น interlock, หยุดเครื่องฉุกเฉิน วินาทีถึงนาที เช่น dashboard, รายงานรายเดือน ปริมาณข้อมูล สูงมากต่อวินาที (vibration 10 kHz, วิดีโอ 30 fps)…
Read More
Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Article
เรื่องนี้เล่าถึงโรงงานอาหารแห่งหนึ่งในนิคมอุตสาหกรรมภาคตะวันออก ที่เดิมใช้เกตเวย์ IoT แบบ standalone จำนวน 24 ตัวกระจายอยู่ทุกสายการผลิต แต่ละตัวเก็บค่าอุณหภูมิห้องเย็น ความชื้น และสถานะเครื่องจักร แล้วส่งขึ้นคลาวด์ผ่าน MQTT ทุกอย่างทำงานได้ดี… จนกระทั่งคืนหนึ่งที่เกตเวย์ตัวหนึ่งหยุดทำงานเพราะการ์ดหน่วยความจำเสีย และไม่มีใครรู้ตัวจนกระทั่งเช้าวันรุ่งขึ้น ข้อมูลห้องเย็นหายไป 7 ชั่วโมงเต็ม ซึ่งในธุรกิจอาหารแปลว่าต้องเขียนรายงานเหตุการณ์ deviation ยาวเหยียด และต้องประเมินความเสี่ยงต่อสินค้าที่เก็บในช่วงเวลานั้น ปัญหา: ความล้มเหลวแบบเงียบ (Silent Failure) การตรวจสอบย้อนหลังพบว่าปัญหาไม่ได้อยู่ที่ตัวเกตเวย์ แต่อยู่ที่สถาปัตยกรรม ระบบเดิมไม่มีกลไกใดตรวจจับว่าเกตเวย์ “ยังมีชีวิต” หรือไม่ และเมื่อเกตเวย์หนึ่งตัวตาย ก็ไม่มีตัวไหนรับหน้าที่แทน ทีมวิศวกรรมจึงเสนอแนวคิดที่ตอนนั้นดูเกินจำเป็นสำหรับโรงงานอาหาร นั่นคือการนำ container orchestration แบบ Kubernetes รุ่นเบา ลงมาวางที่ระดับสายการผลิต — ไม่ใช่เพื่อความสวยงามทางเทคนิค แต่เพื่อให้ได้สามอย่าง: self-healing, declarative configuration และ rollback ที่ทำได้ในไม่กี่วินาที การวางโหนด Edge หลายชั้นให้ครอบคลุมทุกสายการผลิต คือฐานของ orchestration แบบกระจาย — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทางออก: Single-node Cluster ที่ทุกสายการผลิต แนวทางที่เลือกไม่ใช่คลัสเตอร์กลางขนาดใหญ่ แต่เป็น คลัสเตอร์เล็กๆ อยู่กับสายการผลิต แต่ละสายมี industrial computer ตั้งแต่ 2 โหนดขึ้นไป รัน Kubernetes distribution แบบ lightweight ที่ตัดส่วนประกอบที่ไม่จำเป็นออก ตัว workload หลักมีสามชนิด: Collector — อ่านค่าจาก PLC ผ่าน OPC UA และเซ็นเซอร์ผ่าน Modbus TCP เขียนลง local time-series storage Rule engine — ประเมินเงื่อนไข alarm เช่น อุณหภูมิห้องเย็นเกิน -18°C นานเกิน 10 นาที แล้วส่งแจ้งเตือนผ่านหลายช่องทาง Forwarder — ส่งข้อมูลแบบ batch ขึ้นคลาวด์ พร้อม store-and-forward เมื่อลิงก์หลุด จุดเปลี่ยนที่สำคัญคือการตั้งค่า liveness/readiness probe ให้กับทุก workload — collector ที่ค้างไม่อ่านค่า PLC…
Read More
Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Article
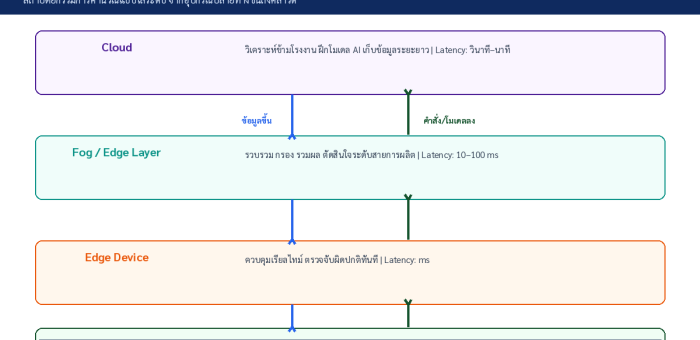
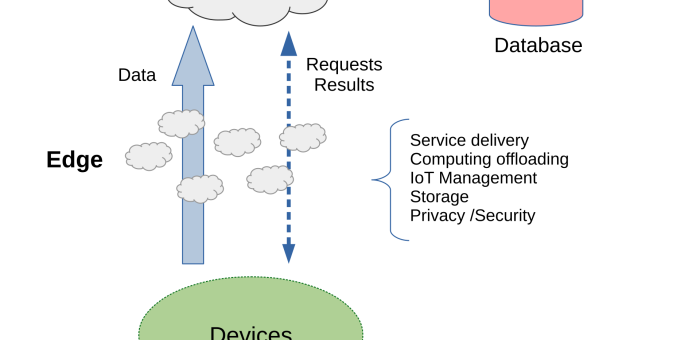
หลายโรงงานในไทยวางแผนธุรกิจดิจิทัลของตัวเองแบบสองขั้ว คือมีอุปกรณ์ IoT และ PLC อยู่ปลายทาง แล้วส่งข้อมูลขึ้นคลาวด์เพื่อประมวลผลทั้งหมด แต่เมื่อปริมาณข้อมูลเพิ่มขึ้นเป็นสิบเท่า และ AI เริ่มถูกใช้ตัดสินใจแบบเรียลไทม์บนพื้นโรงงาน สถาปัตยกรรมแบบสองขั้วนี้ก็เริ่มสะดุด คำตอบที่ถูกที่สุดไม่ใช่การย้ายทุกอย่างกลับมาอยู่ในโรงงาน แต่คือการเพิ่ม ชั้นคำนวณระหว่างกลาง ที่เรียกว่า Fog Computing ซึ่งกำลังกลับมาเป็นที่พูดถึงอีกครั้งในวงการอุตสาหกรรมปี 2026 สถาปัตยกรรมการคำนวณแบบไล่ระดับ ตั้งแต่อุปกรณ์ปลายทาง (Things) ผ่านชั้น Edge/Fog ขึ้นไปถึงคลาวด์ — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทำไมสองขั้วไม่พออีกต่อไป ลองนึกภาพสายการผลิตที่มีกล้องตรวจคุณภาพ 16 ตัว ส่งภาพความละเอียดสูงกลับคลาวด์เพื่อรันโมเดล Computer Vision ที่ 30 เฟรมต่อวินาที เสียงวิเคราะห์คลื่นเสียงเครื่องจักร และข้อมูล vibration ที่สุ่มที่ 10 kHz — แบนด์วิดท์ที่ต้องใช้ไม่ใช่แค่ “เยอะ” แต่แพงและเปราะ ถ้าเน็ตหลุดแม้เพียง 30 วินาที งานตรวจคุณภาพช่วงนั้นก็หายไปตลอดกาล ในทางกลับกัน การเอาทุกอย่างมาไว้ในเซิร์ฟเวอร์กลางในโรงงานล้มเหลวในอีกแบบ ทีม IT ต้องดูแลฮาร์ดแวร์ ทำ backup อัปเดต patch และขยายระบบทุกครั้งที่เพิ่มสายการผลิต Fog Computing เสนอทางที่สาม — กระจายการคำนวณลงไปในหลายๆ โหนดที่อยู่ใกล้แหล่งข้อมูล แต่ยังจัดการแบบรวมศูนย์ ตามแนวคิดที่ OpenFog Consortium (ซึ่งต่อมาควบรวมเข้ากับ Linux Foundation Edge) เคยสรุปไว้ใน Reference Architecture ว่าต้องมีคุณสมบัติ 8 ด้าน ตั้งแต่ Security, Scalability, Openness, Autonomy, Manageability, Agility, Hierarchical Organization ไปจนถึง Programmability ข้อกำหนดทางเทคนิคที่ต้องรู้ก่อนออกแบบ ประเด็นออกแบบ โจทย์จริงในโรงงาน แนวทาง Fog Latency budget ปิดสวิตช์ฉุกเฉินภายใน 10–50 ms หลังตรวจพบความผิดปกติ ประมวลผลและตัดสินใจที่โหนด Fog ในสายการผลิต ไม่รอ round-trip ไปคลาวด์ แบนด์วิดท์ กล้องตรวจคุณภาพ 16 ตัว ที่ 30 fps กินลิงก์ WAN เกินกว่าที่ลิงก์สำรองจะรับไหว สกัดเฉพาะผลลัพธ์และภาพที่พบ defect ขึ้นคลาวด์ ลดปริมาณข้อมูลขาออกได้ 90%…
Read More
How-to: สร้าง Line-level Digital Twin ใน 6 ขั้นตอน — จาก Data Pipeline ตาม ISA-95 สู่ What-if Simulation ที่ใช้ตัดสินใจจริง

How-to: สร้าง Line-level Digital Twin ใน 6 ขั้นตอน — จาก Data Pipeline ตาม ISA-95 สู่ What-if Simulation ที่ใช้ตัดสินใจจริง

Article
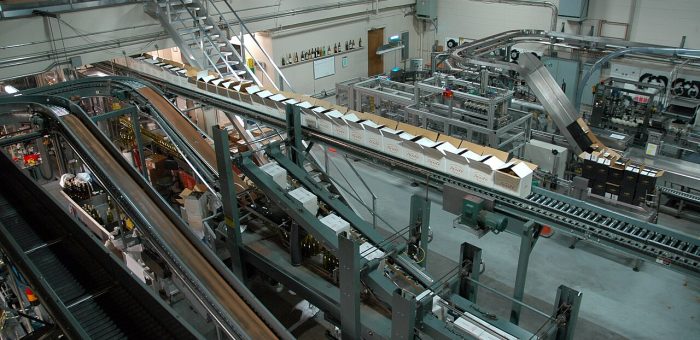
คำถามที่เราได้ยินบ่อยที่สุดในปี 2026: "โรงงานเรามีเครื่องจักรอยู่แล้ว เซ็นเซอร์ติดบ้างแล้ว จะเริ่ม Digital Twin จากตรงไหนดี" — คำตอบจากรายงานแนวโน้มอุตสาหกรรมปี 2026 หลายสำนักชี้ไปทางเดียวกัน: อย่าเริ่มจากเครื่องจักรเดี่ยว ให้เริ่มจากไลน์ผลิต (Production Line) ทั้งเส้น เพราะนั่นคือระดับที่ความล้มเหลวของ Digital Twin ส่วนใหญ่เกิดขึ้น และเป็นระดับที่ให้ผลตอบแทนชัดที่สุด บทวิเคราะห์จากสื่ออุตสาหกรรมการผลิตไทย (Manage & Manufacturing Thailand, ก.พ. 2026) สรุปภาพรวมไว้ว่า Digital Twin กำลังก้าวพ้นช่วงทดลอง (Pilot Phase) สู่การใช้งานจริงในระดับองค์กร โดยเฉพาะการผสานกับ CMMS (ระบบจัดการซ่อมบำรุง), ERP, Edge Computing และเครือข่าย 5G เพื่อลด Downtime และเพิ่มประสิทธิภาพสายการผลิตอย่างเป็นรูปธรรม ไลน์ผลิตจริงคือ "วัตถุดิบ" ของ Line-level Digital Twin — โมเดลที่ดีต้องสะท้อนทั้งจังหวะเครื่องจักร คอขวด และพฤติกรรมคนงาน (ที่มา: Tjeerd Wiersma, CC BY 2.0) ทำไมต้อง Line-level ไม่ใช่ Asset-level Digital Twin ระดับเครื่องจักรเดี่ยว (Asset Twin) เหมาะกับงานวิเคราะห์การสั่นสะเทือนหรืออายุการใช้งานแบริ่ง แต่คำถามที่แท้จริงของผู้จัดการโรงงานอยู่ในระดับที่สูงขึ้น: ถ้าเพิ่มกำลังผลิต 15% จะเกิดอะไรขึ้นกับคอขวด? ถ้าเปลี่ยนสูตรวัตถุดิบ จุดไหนของไลน์จะรับไม่ได้? คำถามเหล่านี้ตอบไม่ได้ด้วยการดูเครื่องจักรเดี่ยว — ต้องจำลอง ปฏิสัมพันธ์ระหว่างเครื่องจักรทุกตัวในไลน์รวมถึง Buffer และรอบเปลี่ยน Batch มิติ Asset Twin (เครื่องจักรเดี่ยว) Line-level Twin (ทั้งไลน์ผลิต) คำถามหลักที่ตอบได้ เครื่องนี้กำลังจะพังไหม? ควรเปลี่ยนอะไหล่เมื่อไร? เพิ่มกำลังผลิตแล้วคอขวดย้ายไปอยู่ตรงไหน? ไลน์รับสูตรใหม่ได้ไหม? ข้อมูลที่ต้องมี Vibration, Temperature, Motor Current ของเครื่องเป้าหมาย ข้อมูลทุกสถานี + อัตราการไหลชิ้นงาน + เวลา Changeover + OEE รายสถานี ผู้ใช้หลัก ทีมซ่อมบำรุง (Maintenance) ผู้จัดการผลิต + Process Engineer + ฝ่ายวางแผน ตัวอย่างการใช้งานเด่น คาดการณ์ความเสียหายแบริ่งล่วงหน้า 2-4 สัปดาห์ ทดสอบ What-if ก่อนเพิ่มกำลังผลิต /…
Read More
ตลาด SCADA โต CAGR 10% ถึงปี 2032: อ่านตัวเลข MarketsandMarkets ให้ขาด และสิ่งที่โรงงานไทยต้องทำตอนนี้

ตลาด SCADA โต CAGR 10% ถึงปี 2032: อ่านตัวเลข MarketsandMarkets ให้ขาด และสิ่งที่โรงงานไทยต้องทำตอนนี้

Article
ตลาด SCADA ทั่วโลกกำลังเข้าสู่ช่วงเร่งตัว — รายงานฉบับล่าสุดจาก MarketsandMarkets (ตีพิมพ์กันยายน 2026) คาดการณ์ว่ามูลค่าตลาดระบบควบคุมและเฝ้าระวังแบบรวมศูนย์จะเติบโตจาก 13.94 พันล้านดอลลาร์สหรัฐในปี 2026 สู่ 24.69 พันล้านดอลลาร์ในปี 2032 ด้วยอัตราเติบโตเฉลี่ยต่อปี (CAGR) 10.0% ตัวเลขนี้ไม่ได้แค่บอกว่า "มีคนซื้อ SCADA มากขึ้น" แต่สะท้อนการเปลี่ยนแปลงเชิงโครงสร้างว่าระบบ SCADA กำลังถูกมองใหม่จาก "ห้องควบคุมของฝ่ายวิศวกรรม" ไปเป็น "แพลตฟอร์มข้อมูลกลางของทั้งองค์กร" ทีมงาน Honey Corporation ติดตั้งระบบ SCADA และระบบเฝ้าระวังในโรงงานอุตสาหกรรมมากว่าหลายโครงการ และสิ่งที่เราเห็นชัดในรอบ 2-3 ปีคือ ลูกค้าไม่ได้ถามแค่ "จอภาพเก็บค่าจาก PLC ได้กี่จุด" อีกต่อไป แต่ถามว่า "ข้อมูลจาก SCADA จะเชื่อมไปยังระบบ MES, ERP และ Dashboard ผู้บริหารได้อย่างไร" — คำถามที่เปลี่ยนไปนี้แหละคือแรงขับเคลื่อนตัวจริงของตลาด 10.0% ที่รายงานบอก อ่านตัวเลขให้ขาด: SCADA 10.0% หมายความว่าอย่างไร เราลองแยกแยะว่า CAGR 10.0% ในช่วง 2026-2032 มาจากไหน โดยเทียบกับรายงานย่อยที่เกี่ยวข้องจากสำนักเดียวกัน: ตลาด ปีฐาน → ปีเป้า ขนาดตลาด CAGR สิ่งที่บอกเรา SCADA โดยรวม 2026 → 2032 USD 13.94B → 24.69B 10.0% โครงสร้างพื้นฐาน + ซอฟต์แวร์โตพร้อมกันทั้งไลน์ SCADA in BIM (อาคาร) → 2032 USD 16.60B 21.5% อาคารอัจฉริยะ + Digital Twin ดันส่วนผสม BIM Power SCADA (ไฟฟ้า) → 2028 USD 2.9B 7.1% กลุ่มพลังงานเติบโตสม่ำเสมอ ไม่ใช่ตัวขับหลัก ที่มา: MarketsandMarkets, SCADA Market Global Forecast to 2032 (ก.ย. 2026); Power SCADA Market (2024); SCADA in Building Information…
Read More
Case Study: ไม่มีข้อมูล เท่ากับ ไม่มีสินค้า — Cold Chain 2026 กับ IoT Temperature Monitoring ที่ช่วยกู้การส่งมอบ

Case Study: ไม่มีข้อมูล เท่ากับ ไม่มีสินค้า — Cold Chain 2026 กับ IoT Temperature Monitoring ที่ช่วยกู้การส่งมอบ

Article
กรณีศึกษาจากสนามจริง: ผู้ประกอบการคลังสินค้าควบคุมอุณหภูมิแห่งหนึ่งในภาคตะวันออกของไทยเคยเจอสถานการณ์ที่ผู้ประกอบการ Cold Chain ทั่วโลกกำลังเผชิญในปี 2026 — ลูกค้าต่างประเทศขอ evidence ว่าสินค้าอยู่ในช่วงอุณหภูมิที่กำหนด ตลอดทั้งการเดินทาง ไม่ใช่แค่ตอนรับ-ส่งของ และเมื่อระบบเก่าแสดง Temperature Log ไม่ได้เพราะข้อมูลถูกเก็บแยกในแต่ละรถ แต่ละคลัง ผลลัพธ์คือการส่งมอบถูกปฏิเสธ พร้อมความเสี่ยงเสียชื่อเสียงที่ใหญ่กว่ามูลค่าสินค้าเสียหายเองหลายเท่า นี่ไม่ใช่เรื่องเฉพาะราย บทวิเคราะห์จาก Cold Chain Exhibition 2026 ชี้ว่ากฎระเบียบด้านการตรวจสอบย้อนกลับ (Traceability) และเอกสารดิจิทัลที่เข้มงวดขึ้น กำลังเปลี่ยนโฉมอุตสาหกรรมทั้งหมด โดยสรุปสถานการณ์ไว้ตรงๆ ว่า "ในยุคนี้ ไม่มีข้อมูล เท่ากับ ไม่มีสินค้า" (No data means no product) คลังสินค้าควบคุมอุณหภูมิ — ศัตรูที่แท้จริงไม่ใช่แค่ความเย็นที่หลุด แต่คือข้อมูลที่พิสูจน์ไม่ได้ว่าความเย็นไม่เคยขาด (ที่มา: Danny Gershoni, CC BY-SA 4.0) Problem: จุดอ่อน 3 ด่านของ Cold Chain แบบเดิม ด่าน สิ่งที่เกิดขึ้นจริง ผลกระทบ ในคลัง อุณหภูมิวัดด้วยเทอร์โมมิเตอร์แบบกระดาษ/ดิจิทัลแยกชิ้น คนเดินจดบันทึกวันละ 2-3 รอบ ช่วงที่ไม่มีคนจด (กลางคืน/ช่วงพักกะ) ไร้หลักฐาน หากคอมเพรสเซอร์ขัดข้อง 30 นาที ไม่มีใครรู้ ระหว่างขนส่ง Data Logger แบบใช้แล้วทิ้ง อ่านค่าได้เฉพาะเมื่อถึงปลายทาง รู้ว่าสินค้าพังตอนรับมอบแล้ว แก้ไขไม่ได้ เรียกคืนไม่ได้ เอกสาร Temperature Report ทำมือจากไฟล์แยกหลายแหล่ง ตอบ Audit ไม่ทันการณ์ ลูกค้า/หน่วยงานกำกับขอเอกสารย้อนหลัง 6 เดือน ต้องใช้คนไล่ทีละไฟล์เป็นวัน Solution: สถาปัตยกรรม Real-Time Monitoring 4 ชั้น แนวทางที่ผู้นำตลาด Cold Chain ใช้ตามบทวิเคราะห์ปี 2026 คือการลงทุนใน 4 องค์ประกอบที่ทำงานร่วมกัน: IoT Sensors ต่อเนื่อง — เซ็นเซอร์อุณหภูมิ/ความชื้นส่งข้อมูลทุก 1-5 นาที ทั้งในคลังและบนรถขนส่ง แทนการจดบันทึกด้วยมือ Cloud Integration — ข้อมูลจากทุกจุดไหลรวมสู่แพลตฟอร์มกลาง เชื่อมกับ WMS (จัดการคลัง), TMS (จัดการขนส่ง) และ ERP ให้เป็นชุดเดียว Exception Alerts — ระบบแจ้งเตือนเฉพาะเมื่อค่าเบี่ยงเบนจากช่วงกำหนด…
Read More