Autonomous Factory ของโรงงานเซมิคอนดักเตอร์ Backend: ถอดบทเรียนจากโรงงานชิป Power Module มูลค่า 48,000 ล้านบาทที่เพิ่งเปิดในไทย

Autonomous Factory ของโรงงานเซมิคอนดักเตอร์ Backend: ถอดบทเรียนจากโรงงานชิป Power Module มูลค่า 48,000 ล้านบาทที่เพิ่งเปิดในไทย

Article
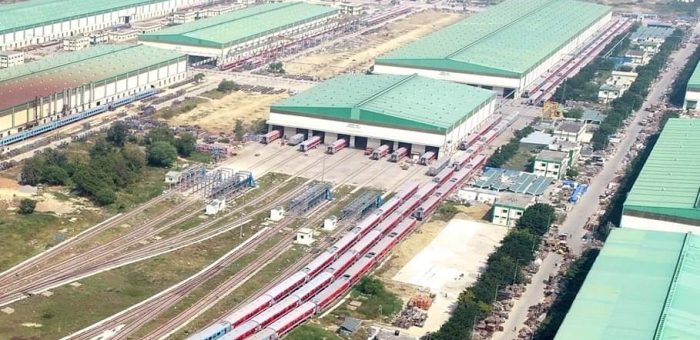
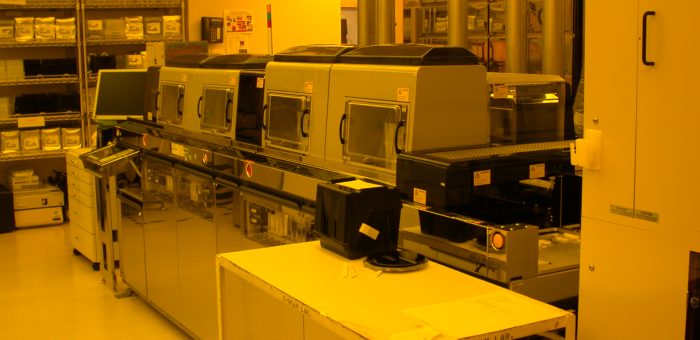
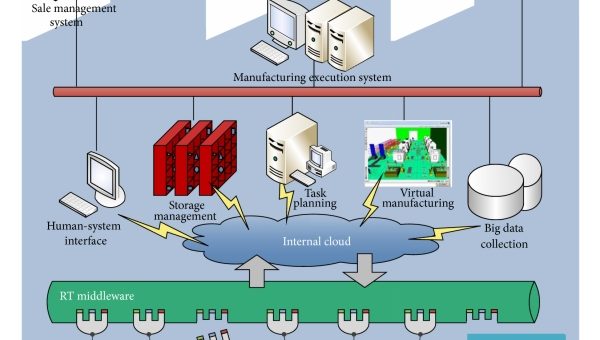
วันที่ 1 ตุลาคม 2569 ถือเป็นหมุดหมายสำคัญของอุตสาหกรรมการผลิตไทย — โรงงานผลิตเซมิคอนดักเตอร์ขั้นปลาย (Backend) แห่งใหม่มูลค่าการลงทุนกว่า 48,000 ล้านบาท ในจังหวัดสมุทรปราการเปิดตัวอย่างเป็นทางการ โดยมีนายกรัฐมนตรีเป็นประธานในพิธี นี่ไม่ใช่แค่ข่าวการลงทุนต่างชาติอีกหนึ่งชิ้น แต่คือ โรงงานอัตโนมัติ (Autonomous Factory) แห่งแรกของบริษัทเจ้าของโครงการที่รวมการทดสอบเวเฟอร์ (Wafer Testing) เข้ากับการประกอบโมดูลกำลัง (Power Module) และการทดสอบวงจรรวม (IC Final Test) ไว้ในสถานที่เดียวกัน บทความนี้ถอดรหัสว่า "Autonomous Factory" ในบริบท Backend Semiconductor หน้าตาเป็นอย่างไร ใช้เทคโนโลยีอะไรบ้าง และวิศวกรอุตสาหกรรมไทยจะเรียนอะไรได้จากโครงการระดับโลกที่มาตั้งอยู่ในประเทศเรา ความจำเพาะของโครงการที่ต้องรู้ก่อน ตัวเลขสำคัญของโครงการนี้อธิบายขนาดความทะเยอทะยานได้ดี: พื้นที่ห้องคลีนรูมเฟสแรก 30,000 ตารางเมตร ออกแบบให้ขยายได้สูงสุด 5 โมดูล รวม 150,000 ตร.ม. — มากกว่าโรงงานที่ใหญ่ที่สุดปัจจุบันของบริษัทราว 2 เท่า เป็นฐานผลิต Power Module แห่งที่ 3 ของโลก ต่อจากเยอรมนีและจีน และหากขยายครบทุกเฟส ไทยจะขึ้นเป็นฐาน Backend ที่ใหญ่ที่สุดในโลกของบริษัท ใช้พลังงานไฟฟ้าสีเขียว 100% พร้อมแผงโซลาร์เซลล์ ระบบหมุนเวียนน้ำ และระบบกักเก็บน้ำฝน คาดการณ์การจ้างงาน 5,000 ตำแหน่ง เมื่อครบทุกเฟส (ประมาณ 1,000 คนต่อเฟส) เน้นวิศวกรและช่างเทคนิค เงื่อไขถ่ายทอดเทคโนโลยี: พัฒนาบุคลากรไทยด้านวิทยาศาสตร์เทคโนโลยี 600 คน ส่งไปฝึกอบรมต่างประเทศ 130 คน ร่วมพัฒนาหลักสูตร 60 วิชา และวิจัยร่วม 680 โครงการ แผนภาพ: สถาปัตยกรรม Autonomous Backend Factory ที่รวม 3 กระบวนการหลักไว้ในโรงงานเดียว (ที่มา: Honey Corporation) ทำไม Backend ต้อง Autonomous มากกว่า Frontend? คนนอกวงการมักคิดว่าขั้นตอน Frontend (การผลิตเวเฟอร์) ซับซ้อนกว่า แต่ในมุมของวิศวกร Automation ขั้นตอน Backend กลับเป็นโจทย์ที่ท้าทายไม่แพ้กัน เพราะต้องจัดการกับ: ความหลากหลายของผลิตภัณฑ์ — โมดูลกำลังหนึ่งรุ่นอาจมี package หลายขนาด ทำให้ changeover บ่อยและต้องพึ่งระบบลำเลียงอัตโนมัติที่ยืดหยุ่น ความต้องการความสะอาดระดับสูงแต่ไม่สูงเท่า Frontend — โดยทั่วไปอยู่ในช่วง ISO…
Read More
บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

Article
โมเดล AI ทำนายความเสียหายของเครื่องจักร (Predictive Maintenance) ตัวหนึ่งในโรงงานสิ่งทอทำงานได้แม่นยำมากในปีแรก แต่ปีที่สองความแม่นยำเริ่มถดลง เพราะสภาพเครื่องจักรเปลี่ยน โหลดการผลิตเปลี่ยน และพฤติกรรม "ปกติ" ของเครื่องจักรเลื่อนไปจากเดิม นี่คือปัญหา Model Drift ที่ทุกโรงงานต้องเจอ และเป็นคำถามเปิดของวงการว่า Digital Twin จะช่วยแก้ได้จริงหรือไม่ บทวิเคราะห์นี้มองปัญหาจากมุมวิศวกรรม ไม่ใช่มุมการตลาด ปัญหา Model Drift ในโรงงาน: ทำไมโมเดลเก่าเร็วจนน่าใจหาย โมเดล Anomaly Detection ส่วนใหญ่เรียนรู้จากข้อมูลในอดีต แล้วตั้งสมมติฐานว่าอนาคตจะคล้ายอดีต แต่ในโรงงานจริง ไม่มีอะไรนิ่ง: ชิ้นส่วนสึกหรอ, สูตรผลิตเปลี่ยน, ผู้ปฏิบัติงานเปลี่ยนวิธีเดินเครื่อง, อุณหภูมิแวดล้อมตามฤดูกาล หรือแม้แต่การซ่อมบำรุงที่ "ปรับ" พฤติกรรมเครื่องจักรไปโดยสิ้นเชิง ผลคือเกิดการแจ้งเตือนเท็จ (False Alarm) เพิ่มขึ้นเรื่อยๆ จนทีมซ่อมบำรุงเริ่มกด "Dismiss" โดยไม่อ่าน — และวันหนึ่ง Alarm จริงก็ถูกกดไปพร้อมกับพวกเท็จ แนวทางแก้แบบดั้งเดิมคือ การเทรนซ้ำ (Retraining) ด้วยข้อมูลใหม่ แต่คำถามคือใครจะ Label ข้อมูลว่าอะไรคือ "ปกติ" ในสถานการณ์ใหม่ และต้องรอนานแค่ไหนจึงจะมีข้อมูลเพียงพอ เพราะความเสียหายจริงเกิดไม่บ่อยนัก แนวคิดใหม่: Fleet Learning ผ่าน Digital Twin แนวคิดที่กำลังได้รับความสนใจคือการใช้ Digital Twin เป็น "ผู้เรียนรู้ร่วมกัน" ของกลุ่มเครื่องจักรลักษณะเดียวกัน แทนที่จะปล่อยให้แต่ละเครื่องเรียนรู้ลำพัง: สถาปัตยกรรม Smart Factory ยุคใหม่เชื่อมทุกชั้นข้อมูลเข้าด้วยกัน — Fleet Learning เป็นการขยายแนวคิดนี้สู่กลุ่มเครื่องจักรข้ามไซต์ (ภาพ: Wikimedia Commons, CC BY 4.0) หลักการคือ เมื่อเครื่องจักร A ในไซต์ 1 เจอ Failure Mode ใหม่และถูกบันทึกไว้ใน Twin ของมัน ความรู้นั้นสามารถถ่ายทอด (Transfer) ไปยังโมเดลของเครื่องจักร B, C, D ที่อยู่คนละไซต์แต่มีลักษณะเดียวกันได้ทันที เครื่องจักรอื่นๆ จึง "รู้" ล่วงหน้าโดยไม่ต้องเจอเองก่อน นี่คือความต่างสำคัญจากการเทรนโมเดลแบบเก่าที่ต้องรอเครื่องเสียจริงทีละตัวเพื่อสะสมประสบการณ์ วิเคราะห์กลไกทางเทคนิค: Twin ช่วยแก้ Drift ได้อย่างไร กลไก วิธีการทำงาน ข้อดี ข้อจำกัดที่ต้องยอมรับ Simulation Augmentationใช้ Twin จำลองสถานการณ์ที่ยังไม่เคยเกิดจริง สร้างข้อมูล Synthetic สำหรับเทรนโมเดลได้ข้อมูล Failure…
Read More
บทวิเคราะห์: Gartner Hype Cycle for Agentic AI 2026 — องค์กรใช้ AI Agent จริงแค่ 17% และนี่คือสิ่งที่โรงงานต้องรู้ก่อนกระโดดขึ้นรถ

บทวิเคราะห์: Gartner Hype Cycle for Agentic AI 2026 — องค์กรใช้ AI Agent จริงแค่ 17% และนี่คือสิ่งที่โรงงานต้องรู้ก่อนกระโดดขึ้นรถ

Article
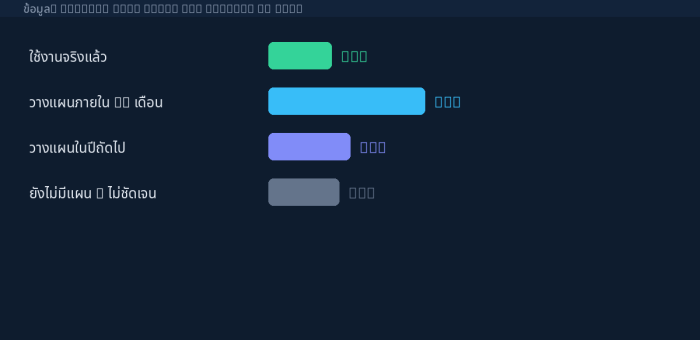
“AI Agent” คือคำที่ถูกพูดมากที่สุดในวงการเทคโนโลยีอุตสาหกรรมปี 2026 ทุกงานสัมมนามีประเด็นนี้ ทุกเวนเดอร์มีแพลตฟอร์มนี้ แต่ตัวเลขจริงจาก Gartner ฉายภาพที่ต่างออกไป: องค์กรที่ใช้ AI Agent ในการทำงานจริงมีเพียง 17% ในขณะที่ 42% วางแผนจะเริ่มภายใน 12 เดือน และอีก 22% มีแผนในปีถัดไป ช่องว่างระหว่าง “ความคาดหวัง” กับ “การใช้งานจริง” นี้แหละคือหัวใจของ Hype Cycle for Agentic AI 2026 ที่ Gartner เผยแพร่ล่าสุด และสำหรับโรงงานไทย นี่คือจังหวะที่ต้องตัดสินใจอย่างมีสติ ไม่ใช่ FOMO ตัวเลขบอกอะไร: 17% ที่เริ่มแล้วทำอะไรอยู่ กลุ่ม 17% ที่ใช้จริงส่วนใหญ่ยังโฟกัสที่ งานอัตโนมัติเฉพาะจุด (Automation เป็นหลัก) ยังไม่ใช่การเปลี่ยนแปลงกระบวนการทั้งองค์กร ซึ่งสอดคล้องกับสิ่งที่เห็นในโรงงานจริง: AI Agent ตัวแรกๆ ที่เวิร์กคือตัวที่ทำงานแคบและชัด เช่น อ่านค่าเซ็นเซอร์แล้วสรุปสรุปสถานะเครื่องจักร จัดลำดับงานซ่อมบำรุง หรือเตรียมรายงานกะกลางคืน 17% ใช้จริง / 42% จะเริ่มใน 12 เดือน / 22% ปีถัดไป — ความต่างขององค์กรจะเกิดในช่วง 12 เดือนข้างหน้า (ข้อมูล: Gartner, แผนภูมิ: Honey Corporation) 3 เทรนด์หลักที่ Gartner ระบุ — แปลเป็นภาษาโรงงาน เทรนด์ Gartner ความหมายต่อโรงงาน 1. AI Agent Adoption — 17% ใช้จริง, 42% ใน 12 เดือน หน้าต่างความได้เปรียบกำลังเปิด ผู้ที่เริ่มก่อนจะสะสมข้อมูลและบทเรียนก่อน แต่เริ่มผิดทางก็เสียเวลาเท่ากัน 2. Semi-Autonomous Deployment — มนุษย์ยังต้องควบคุม อย่ามองหา AI Agent ที่ “ตัดสินใจแทนทั้งหมด” ให้ออกแบบให้ Agent เสนอ + คนอนุมัติจุดวิกฤต เช่น การสั่งหยุดไลน์หรือเปลี่ยนแปลงพารามิเตอร์เครื่องจักร 3. Agent Washing — RPA เดิมแต่งตัวเป็น AI Agent ตรวจสอบให้ชัดว่าแพลตฟอร์มที่ซื้อ “คิดและปรับตัว” จริง หรือแค่รันสคริปต์เดิมที่เปลี่ยนชื่อ…
Read More
Case Study: โรงงานประภาคารแห่งแรกนอกจีนในอุตสาหกรรมเครื่องใช้ไฟฟ้าของไทย — ถอดสูตร 5G + AI + ESG จาก 208,000 ตร.ม. ในศรีราชา

Case Study: โรงงานประภาคารแห่งแรกนอกจีนในอุตสาหกรรมเครื่องใช้ไฟฟ้าของไทย — ถอดสูตร 5G + AI + ESG จาก 208,000 ตร.ม. ในศรีราชา

Article
ตุลาคม 2026 ที่ผ่านมา สภาอุตสาหกรรมโลก (World Economic Forum) ประกาศสถานะ "โรงงานประภาคาร" (Lighthouse Factory) ให้กับโรงงานผลิตเครื่องปรับอากาศแห่งหนึ่งในนิคมอุตสาหกรรมปิ่นทอง จังหวัดชลบุรี นี่คือครั้งแรกของอุตสาหกรรมเครื่องใช้ไฟฟ้าที่โรงงานตั้งอยู่นอกประเทศจีนได้รับการรับรองระดับนี้ และเป็นหมุดหมายสำคัญของภาคการผลิตไทยบนแผนที่โลก กรณีนี้น่าสนใจไม่ใช่แค่เกียรติยศ แต่เพราะมันพิสูจน์ว่าโรงงานขนาดใหญ่ในไทยสามารถทำผลลัพธ์ที่วัดได้จริงจากเทคโนโลยีที่พูดถึงกันมานาน — แล้วตัวเลขที่ออกมาคืออะไร และโรงงานไทยทั่วไปเรียนอะไรได้บ้าง วันนี้เราจะเจาะทีละชั้น ขนาดของสนาม: เคสนี้ใหญ่แค่ไหน โรงงานแห่งนี้ตั้งอยู่บนพื้นที่ 208,000 ตารางเมตร (ราว 130 สนามฟุตบอล) ในเขตพัฒนาพิเศษภาคตะวันออก (EEC) ด้วยงบลงทุนระดับ 5,000 ล้านบาท และกำหนดเป้ากำลังผลิตเครื่องปรับอากาศภายในบ้านถึง 6 ล้านเครื่องภายในปี 2569 — สายการผลิตเครื่องปรับอากาศใหญ่ที่สุดในไทยและอาเซียนของกลุ่มบริษัทแม่ โรงงานยุคใหม่ระดับ "ประภาคาร" ถูกออกแบบให้ข้อมูลไหลได้ทั้งเส้น — จากซัพพลายเออร์ยันคลังสินค้า (ภาพประกอบ: Wikimedia Commons, CC BY-SA 4.0) Problem: ปัญหาที่โรงงานระดับนี้ต้องแก้ การผลิตเครื่องปรับอากาศล้านเครื่องต่อปี คือการจัดการความซับซ้อนมหาศาล: หลายพัน SKU, ชิ้นส่วนจากหลายร้อยซัพพลายเออร์, ความต้องการตามฤดูกาลที่พีคสูงมากในหน้าร้อน และแรงกดดันด้านต้นทุนพลังงานที่สูงขึ้นทุกปี ปัญหาคลาสสิกของโรงงานสายการประกอบขนาดใหญ่คือ: ข้อมูลติดอยู่ในเกาะ — แต่ละสายการผลิตมีข้อมูลของตัวเอง แต่รวมกลางไม่ได้แบบเรียลไทม์ การตรวจสอบคุณภาพตามหลัง — พบของเสียตอนท้ายไลน์ ทั้งที่สัญญาณเตือนมีอยู่ก่อนแล้ว AGV/รถลำเลียงจำนวนมาก ต้องการเครือข่ายที่เสถียรและมีดีเลย์ต่ำสม่ำเสมอ ซึ่ง Wi-Fi แบบเดิมตามไม่ทัน Solution: 5G เครือข่ายเดียว เป็นกระดูกสันหลังของทุกกระบวนการ หัวใจของโรงงานแห่งนี้คือการเป็นโรงงานแรกในอาเซียนที่ประยุกต์ เครือข่าย 5G เข้ากับการผลิตอัจฉริยะอย่างเต็มรูปแบบ จนได้รับรางวัล Best Mobile Technology Breakthrough in Asia จาก Asia Mobile Awards ปี 2567 สิ่งที่ 5G ปลดล็อกได้จริงในโรงงานคือ: Use Case ทำไมต้อง 5G ผลลัพธ์ที่วัดได้ ตรวจสอบคุณภาพด้วย AI Visionส่งภาพความละเอียดสูงจากกล้องหลายสิบตัวขึ้นประมวลผลแบบเรียลไทม์ตรวจจับข้อบกพร่องแบบเรียลไทม์ ลดของเสียได้ 20% ควบคุม AGV และการขนส่งภายในโรงงานดีเลย์ต่ำและเสถียร ทำให้การหลบหลีกและจัดคิวอัจฉริยะปลอดภัยการขนส่งภายในรองรับกำลังผลิต 6 ล้านเครื่อง/ปี สนับสนุนงานที่มีความเสี่ยงสูงระบบเตือนและควบคุมตอบสนองทันที ลดการสัมผัสจุดเสี่ยงของคนงานความปลอดภัยของบุคลากรเพิ่มขึ้น ตัวเลขผลลัพธ์ ESG จากการรับรอง Lighthouse: พลังงาน −40.2%, ของเสีย −20%, น้ำ −23.5% (แผนภูมิ: Honey Corporation) Results:…
Read More
บทวิเคราะห์: Generative AI กับวิศวกร Automation ปี 2026 — ทำไม “วิศวกรที่ใช้ AI เป็น” คือความได้เปรียบถัดไปของโรงงานไทย

บทวิเคราะห์: Generative AI กับวิศวกร Automation ปี 2026 — ทำไม “วิศวกรที่ใช้ AI เป็น” คือความได้เปรียบถัดไปของโรงงานไทย

Article
ปี 2026 ความกังวลของโรงงานเปลี่ยนจาก "AI จะมาแย่งงานวิศวกรหรือเปล่า" ไปเป็น "ทำไมคู่แข่งที่ใช้ AI ทำงานเสร็จเร็วกว่าเรา" จากสถิติที่หาได้จากแพลตฟอร์มงาน ตำแหน่ง automation engineer ในไทยเริ่มเรียกร้องทักษะ Generative AI และ LLM อย่างเปิดเผย ขณะที่ตลาด generative AI ของไทยเติบโตเฉลี่ยกว่า 30% ต่อปี (อ้างอิงข้อมูล International Trade Administration) มุมมองของเราในบทวิเคราะห์นี้ชัดเจน: Generative AI จะไม่แทนที่วิศวกร automation แต่วิศวกรที่ใช้ GenAI เป็น จะแทนที่วิศวกรที่ไม่ใช้ สนามจริงปี 2026: GenAI ทำอะไรในงาน automation ได้แล้ว พ้นวง "ลองเล่น" ไปแล้ว วันนี้เราเห็นการใช้งานจริงจังใน 4 งานหลักของทีม automation และ system integration: เขียนและทบทวนโค้ด PLC/SCADA script — ใช้ LLM เป็นคู่คิดรีวิว ladder logic, แปลงโค้ดระหว่าง platform, หา race condition ที่มนุษย์มองข้าม และเขียน script จัดการข้อมูลจาก historian แปลงเอกสารเทคนิคให้เป็นความรู้ที่ค้นได้ — คู่มือเครื่องจักรภาษาอังกฤษหลายพันหน้า แปลงเป็นคลังความรู้ภาษาไทยที่ค้นหาด้วยภาษาพูดได้ ช่างถาม "ปั๊มตัวนี้ seal แบบไหน" แล้วได้คำตอบพร้อมอ้างอิงหน้าคู่มือ สร้าง documentation อัตโนมัติ — งานที่ไม่มีใครอยากทำแต่ทุกโครงการต้องทำ: IO list, cause & effect matrix, รายงาน commissioning จากข้อมูล raw ของโครงการ ช่วยวิเคราะห์ alarm log และ troubleshooting — โยน alarm flood ช่วงเวลา 2 ชั่วโมงให้ AI สรุปเป็น timeline เรียงเหตุการณ์ พร้อมตั้งสมมติฐาน root cause 3 ข้อให้ทีมตรวจ มุมมอง Honey Corporation: จุดแข็งที่แท้จริงอยู่ที่ "ความรู้ที่หลุดออกจากคน" จากประสบการณ์ของทีม Honey Corporation ที่ทำ system integration…
Read More
How-to: ทำ Explainable AI (SHAP/LIME) ให้โมเดล Predictive Maintenance — 5 ขั้นตอนทำให้ช่างเชื่อ AI จริงๆ

How-to: ทำ Explainable AI (SHAP/LIME) ให้โมเดล Predictive Maintenance — 5 ขั้นตอนทำให้ช่างเชื่อ AI จริงๆ

Article
โมเดล AI ทำนายความเสียหายของเครื่องจักรได้แม่นระดับ 90%+ แต่พอถูกถามว่า “ทำไมถึงบอกว่าเครื่องนี้เสี่ยง” กลับตอบไม่ได้ — นี่คือปัญหา black box ที่ทำให้ AI จำนวนมากติดอยู่ใน pilot ไม่มีวันถูกใช้จริงในสายการผลิต วิศวกรซ่อมบำรุงจะไม่มีวันเชื่อคำสั่งหยุดเครื่องที่ไม่มีเหตุผลรองรับ และผู้จัดการโรงงานก็ไม่กล้าเสี่ยงตัดสินใจตามตัวเลขที่อธิบายไม่ได้ บทความนี้เป็นคู่มือปฏิบัติ 5 ขั้นตอน สำหรับเพิ่มความโปร่งใสให้โมเดล predictive maintenance ด้วยเทคนิค Explainable AI (XAI) ปัญหา: ความแม่นยำไม่ใช่ข้ออ้างของความไว้วางใจ สถานการณ์มาตรฐานที่เราพบบ่อย: ทีม data scientist สร้างโมเดล gradient boosting ทำนายความเสี่ยงแบริ่งพังใน 14 วัน ได้ F1 สูงมากใน test set แต่พอ deploy จริง ช่างเทคนิคกลับแค่ “ดูเลข” แล้วเดินผ่าน เพราะโมเดลไม่เคยบอกว่าสัญญาณมาจากไหน — ความร้อน? การสั่น? หรือค่าไฟฟ้าที่ปนเปื้อน? ผลคือระบบถูกละเลยจนถูกถอดออกในที่สุด งานวิจัยด้าน XAI ในภาคอุตสาหกรรมชี้ตรงกันว่า การนำ AI ไปใช้กับงาน maintenance ล้มเหลวไม่ใช่เพราะโมเดลไม่แม่น แต่เพราะ คนในสายการผลิตไม่มีเครื่องมือตรวจสอบเหตุผลของโมเดลได้ ซึ่ง XAI แก้ปัญหานี้ตรงจุด 2 เทคนิคหลัก: LIME และ SHAP โมเดล gradient boosting หรือ neural network รุ่นใหม่แม่นกว่า linear model มาก แต่แลกมาด้วยความอธิบายไม่ได้ XAI จึงเข้ามาเป็น “สะพาน” ระหว่างความแม่นกับความเข้าใจ: LIME (Local Interpretable Model-agnostic Explanations) — สร้างโมเดลลินแมร์ตัวจิ๋วมาลอกเลียนพฤติกรรมของโมเดลใหญ่ “ในบริเวณใกล้” การทำนายหนึ่งๆ แล้วอ่านค่าสัมประสิทธิ์ จะรู้ทันทีว่า feature ไหนดันความน่าจะเป็นขึ้น ตัวไหนฉุดไว้ SHAP (SHapley Additive exPlanations) — ยืมแนวคิด Shapley value จากทฤษฎีเกม คำนวณ “ส่วนแบ่งความดีความชั่ว” ของ feature แต่ละตัวอย่างเป็นธรรม โดยเฉลี่ยผลจากทุก combination ที่เป็นไปได้ ให้ค่าที่ consistent และมีหลักทฤษฎีรองรับ โครงสร้าง hidden layer ของ neural network…
Read More
Reinforcement Learning ในโรงงาน: เมื่อ AI ไม่ใช่ทำนาย แต่ลงมือควบคุมระบบจริง — จาก Reward Function ถึง Safety Layer

Reinforcement Learning ในโรงงาน: เมื่อ AI ไม่ใช่ทำนาย แต่ลงมือควบคุมระบบจริง — จาก Reward Function ถึง Safety Layer

Article
หลายโรงงานที่เราเจอในประเทศไทยมีปัญหาเดียวกัน — ระบบทำความเย็น ระบบปรับอากาศ หรือชุดหม้อไอน้ำ ถูกตั้งค่าพารามิเตอร์ไว้ตั้งแต่วัน commissioning แล้วก็ไม่เคยถูกปรับอีกเลย ทั้งที่โหลดจริงเปลี่ยนไปตลอดเวลา ทั้งจากฤดูกาล สูตรการผลิต และปริมาณคำสั่งผลิต บทความนี้เราจะเจาะลึกว่า Reinforcement Learning (RL) จะเข้ามา "เรียนรู้" วิธีควบคุมที่ดีที่สุดจากข้อมูลจริงของโรงงานคุณเองได้อย่างไร และทำไมมันถึงไม่ใช่แค่ hype แต่เป็นเทคโนโลยีที่ถูกพิสูจน์แล้วในงานจริงมานานกว่า 8 ปี RL ต่างจาก AI แบบที่โรงงานเคยใช้อย่างไร งาน AI ส่วนใหญ่ในโรงงานตอนนี้คือการ "ทำนาย" — ทำนายว่าแบริ่งจะพังเมื่อไหร่ ทำนายว่าชิ้นงานจะเสียหรือไม่ แต่ RL ไม่ได้ทำนาย RL ทำหน้าที่ ตัดสินใจลงมือทำ โดยตอบคำถามว่า "ถ้าสถานการณ์เป็นแบบนี้ ควรตั้งค่าอะไรเท่าไหร่ถึงจะดีที่สุดในระยะยาว" กลไกหลักของ RL คือการเรียนรู้ผ่านการลองผิดลองถูกภายใต้กรอบที่เรียกว่า Markov Decision Process (MDP) — ตัวควบคุม (agent) สังเกตสถานะปัจจุบัน เช่น อุณหภูมิน้ำเย็น โหลด แรงดัน แล้วเลือก action เช่น ปรับความถี่ปั๊ม เปิด-ปิด chiller จากนั้นระบบให้ reward กลับมา (เช่น พลังงานที่ประหยัดได้ในชั่วโมงนั้น) และวนซ้ำแบบนี้หลายล้านครั้งจนโมเดลเรียนรู้นโยบาย (policy) ที่ดีที่สุด แผนภาพวงจรการเรียนรู้ของ RL: agent สังเกต state → เลือก action → รับ reward → ปรับ policy (ภาพ: Wikimedia Commons, CC) กรณีศึกษาที่เปลี่ยนเกม: ระบบทำความเย็น Data Center ตัวอย่างที่ถูกอ้างถึงมากที่สุดคือโครงการนำร่องปี 2016 ของบริษัทเทคโนโลยีระดับโลกที่นำ Deep RL มาควบคุมระบบทำความเย็นของ data center ของตัวเอง ผลลัพธ์คือพลังงานที่ใช้ในส่วน cooling (PUE ลดลงจาก 1.12 เหลือ 1.10) โดยระบบปรับพารามิเตอร์หลายสิบตัวพร้อมกันที่มนุษย์ทำได้ยาก เพราะตัวแปรทั้งหมด interlock กันหมด ต่อมาปี 2018 มีการต่อยอดให้ระบบส่งคำสั่งควบคุมโดยตรงสู่ระบบจริงทุก 5 นาทีอัตโนมัติ กลายเป็น "operator ที่ไม่มีวันเหนื่อย" ที่คอยหาจุด sweet spot ของระบบตลอด 24 ชั่วโมง ระบบทำความเย็นคือ…
Read More
Supply Chain Control Tower ยุค Agentic AI: จาก Dashboard เฝ้าดู สู่ศูนย์บัญชาการที่ตัดสินใจแทนคุณในไม่กี่นาที

Supply Chain Control Tower ยุค Agentic AI: จาก Dashboard เฝ้าดู สู่ศูนย์บัญชาการที่ตัดสินใจแทนคุณในไม่กี่นาที

Article
จาก Dashboard บอกเล่าเหตุการณ์ สู่ศูนย์บัญชาการที่ตัดสินใจเอง หลายโรงงานที่ลงทุน "Control Tower" ไปเมื่อ 3-4 ปีก่อน กำลังพบปัญหาเดียวกัน คือระบบสวยงาม ข้อมูลครบ แต่สุดท้ายคนยังต้องนั่งเฝ้าจอ ไล่ดูสถานะรถทุกคัน แล้วโทรไปถามทีมปฏิบัติการเองว่าจะทำอย่างไรต่อ Control Tower รุ่นแรกคือ ชั้นรวบรวมข้อมูล (Data Aggregation Layer) ที่ดึงข้อมูลจาก TMS (ระบบบริหารการขนส่ง) WMS (ระบบบริหารคลังสินค้า) และข้อมูลจากผู้ขนส่งภายนอก มาแสดงบนจอเดียวให้คนตัดสินใจเอง ปี 2026 หน้าที่ของมันกำลังเปลี่ยนไปสู่ AI Control Tower ที่ไม่ใช่แค่รายงานว่าเกิดอะไรขึ้น แต่ประเมินสถานการณ์หลายแบบพร้อมกัน คาดการณ์ผลกระทบ และเสนอหรือลงมือแก้ปัญหาเองภายในไม่กี่นาที แรงผลักดันหลักคือความผันผวนทางภูมิรัฐศาสตร์ การขาดแคลนแรงงาน และต้นทุนที่สูงขึ้น จนองค์กรไม่มีเวลาให้ทีมงานนั่งวิเคราะห์ทุกเหตุการณ์ทีละเคสอีกต่อไป ท่าเรือคอนเทนเนอร์คือจุดที่ความล่าช้าเล็กน้อยถูกขยายเป็นผลกระทบทั้งห่วงโซ่ — AI Control Tower ถูกออกแบบมาเพื่อตัดสินใจ ณ จุดพวกนี้ให้เร็วกว่ามนุษย์ (ภาพ: Wikimedia Commons) ตัวเลขที่อธิบายว่าทำไมทุกคนเร่งตัดสินใจในปี 2026 ข้อมูลจากรายงานอุตสาหกรรมหลายฉบับในปี 2026 ชี้ตรงกันว่า ความไม่แน่นอนทางเศรษฐกิจและภูมิรัฐศาสตร์ เป็นปัจจัยสำคัญที่สุดที่กดดันการตัดสินใจด้าน supply chain ในปีนี้ ขณะที่สัดส่วนองค์กรที่ใช้ AI ในกิจกรรม supply chain เพิ่มจากราว 30% เป็นราว 40% ภายในเวลาเพียงหนึ่งปี — นั่นแปลว่าเกือบครึ่งของคู่แข่งของคุณอาจกำลังให้ AI ช่วยวางแผนสินค้าคงคลังและจัดเส้นทางขนส่งอยู่แล้ว มิติ Control Tower แบบดั้งเดิม AI Control Tower บทบาทหลักรวมข้อมูล แสดงสถานะ (Monitoring)ตัดสินใจและลงมือแก้ปัญหา (Decision + Action) เมื่อรถส่งสินค้าล่าช้าแจ้งเตือนสีแดง รอคนโทรประสานงานระบุเส้นทางทางเลือก จัดสรรสต๊อกระหว่าง DC ใกล้เคียง และจัดลำดับออเดอร์ตาม SLA อัตโนมัติ การตอบสนองชั่วโมงถึงวัน (ผู้เชี่ยวชาญต้องวิเคราะห์)นาที (ระบบประเมินหลายสถานการณ์พร้อมกัน) ข้อมูลที่ใช้TMS + WMS + ผู้ขนส่งเพิ่ม IoT telemetry, สภาพอากาศ, ข่าวภูมิรัฐศาสตร์, ข้อจำกัดท่าเรือแบบ real-time Human-in-the-loopคนตัดสินใจทุกขั้นAI ตัดสินใจชั้นปฏิบัติการ คนกำกับดูแลและยับยั้งได้ คอนเทนเนอร์หลายหมื่นใบในท่าเรือใหญ่ แต่ละใบคือเหตุการณ์ที่ AI Control Tower ต้องติดตามพร้อมกัน — งานที่เกินพิกัดการไล่ด้วยสายตามนุษย์ (ภาพ: Wikimedia Commons) สถาปัตยกรรม 5…
Read More
How-to: รับมือ TH-AI Passport ยุคพนักงานใช้ AI ทุกคน — วาง AI Policy โรงงาน 5 ขั้นตอน

How-to: รับมือ TH-AI Passport ยุคพนักงานใช้ AI ทุกคน — วาง AI Policy โรงงาน 5 ขั้นตอน

Article
ปลายเดือนสิงหาคม 2026 ประเทศไทยเปิดตัว TH-AI Passport โครงการระดับชาติที่ให้ประชาชนเข้าถึงโมเดล AI ชั้นนำได้ และภายในเดือนแรกมีผู้ใช้แล้ว 500,000 ราย (ที่มา: Thai PBS World, 3 ก.ย. 2026) ขณะที่หน่วยงานภาครัฐเปิดเผยเป้าหมายผลักดันอัตราการใช้ AI ของคนไทยให้ถึง อย่างน้อย 20% ภายในปีหน้า สำหรับคนทำโรงงาน ข่าวนี้ไม่ใช่แค่นโยบายรัฐที่อ่านผ่าน — มันคือสัญญาณว่า พนักงานของคุณจะเริ่มใช้ AI ในงานจริงเร็วกว่าที่ระบบและกฎเกณฑ์ของโรงงานจะพร้อมรับ คำถามจึงไม่ใช่ว่าควรอนุญาตหรือไม่ แต่คือจะเปลี่ยนพนักงานที่ใช้ AI ให้เป็นความได้เปรียบได้อย่างไร บริบท: ทำไมรัฐต้องผลักดันเป้าหมาย 20% เหตุผลมาจากตัวเลขในรายงาน Global AI Adoption in 2025 — อัตราการใช้ AI ของไทยอยู่ที่เพียง 10.7% ต่ำกว่าค่าเฉลี่ยโลก 16.3% และติดอันดับ 89 ของโลก ขณะที่เวียดนามอยู่ที่ 23.5% (อันดับ 38) มาเลเซีย 19.7% ฟิลิปปินส์ 18.3% และสิงคโปร์สูงถึง 60.9% (อันดับ 2 ของโลก) ภาพประกอบ: เมื่อการเข้าถึง AI กลายเป็นโครงสร้างพื้นฐานสาธารณะใหม่ โรงงานไทยต้องปรับตัวรับพนักงานยุคใหม่ที่ใช้ AI เป็นประจำ (ที่มา: Unsplash) เป้าหมาย 20% จึงหมายถึงการเพิ่มเกือบเท่าตัวจากระดับปัจจุบัน และ TH-AI Passport คือเครื่องมือหลักเพื่อไปให้ถึงเป้าหมาย โดยลดอุปสรรคด้านการเข้าถึงเทคโนโลยี ซึ่งรายงานฉบับเดียวกันระบุว่าเป็นหนึ่งในสามช่องว่างหลักของไทย (อีกสองคือทักษะ และการนำไปใช้จริงในภาคเศรษฐกิจ) ตาราง: โอกาสและความเสี่ยงเมื่อพนักงานโรงงานใช้ AI สาธารณะ มิติงาน โอกาส ความเสี่ยง การผลิตช่วยเรียบเรียง work instruction สรุป log เครื่องจักร และแปลคู่มือเทคนิคคำแนะนำที่ผิดโดยไม่มีใครตรวจ นำไปสู่การตัดสินใจผิดหน้างาน คุณภาพร่างรายงาน 8D รายงาน CAPA และสรุปผล auditผลลัพธ์ที่ดูน่าเชื่อถือแต่ผิด (hallucination) ปนเข้าเอกสารคุณภาพ ซ่อมบำรุงวิเคราะห์แนวโน้มการเสียของเครื่องจักร และช่วย troubleshooting ขั้นต้นข้อมูลที่ควรเป็นความลับถูกส่งเข้าโมเดลสาธารณะ (data leakage) ความปลอดภัยสร้างแบบประเมิน JSA และร่าง permit-to-worknetwork diagram หรือ IP ภายในองค์กรถูกวางเข้าโมเดลภายนอก ฝึกอบรมสร้างสื่ออบรมสั้นตามสถานการณ์หน้างานจริงเนื้อหาต้องผ่านการตรวจทานของผู้เชี่ยวชาญก่อนนำไปใช้จริง ที่มา: วิเคราะห์โดย Honey Corporation จากกรณีการใช้งานจริงในโรงงานอุตสาหกรรม…
Read More
บทวิเคราะห์: ไทยอันดับ 89 ของโลกด้าน AI Adoption (10.7%) — สัญญาณเตือนที่โรงงานไทยต้องอ่านให้ขาด

บทวิเคราะห์: ไทยอันดับ 89 ของโลกด้าน AI Adoption (10.7%) — สัญญาณเตือนที่โรงงานไทยต้องอ่านให้ขาด

Article
รายงาน "Global AI Adoption in 2025: A Widening Digital Divide" ที่ถูกรายงานโดย The Nation Thailand เมื่อปลายเดือนพฤษภาคม 2026 ชี้ตัวเลขที่หลายคนในวงการอุตสาหกรรมไทยควรหยุดอ่านสักครู่ — อัตราการใช้ AI ของคนไทยอยู่ที่เพียง 10.7% ของประชากรทั้งหมด ต่ำกว่าค่าเฉลี่ยโลกที่ 16.3% และส่งผลให้ไทยติดอันดับ 89 ของโลก ในครึ่งหลังของปี 2025 ตัวเลขนี้ไม่ใช่แค่สถิติ แต่คือ "สัญญาณเตือน" สำหรับภาคการผลิตของไทย เมื่อเพื่อนบ้านใน ASEAN กำลังวิ่งไปข้างหน้าเร็วกว่าที่คิด ตารางเปรียบเทียบ: ไทยอยู่ตรงไหนในสนาม AI ของภูมิภาค? ประเทศ อัตราการใช้ AI อันดับโลก เทียบกับไทย (10.7%) สิงคโปร์60.9%2สูงกว่าไทยเกือบ 6 เท่า เวียดนาม23.5%38สูงกว่าไทย 2.2 เท่า มาเลเซีย19.7%–สูงกว่าไทย 1.8 เท่า ฟิลิปปินส์18.3%–สูงกว่าไทย 1.7 เท่า อินโดนีเซีย12.7%–สูงกว่าไทยเล็กน้อย ไทย10.7%89— ที่มา: รายงาน "Global AI Adoption in 2025: A Widening Digital Divide" รายงานโดย The Nation Thailand (พ.ค. 2026) ภาพประกอบ: ช่องว่างการใช้ AI ในภูมิภาค ASEAN — เมื่อข้อมูลกลายเป็นเส้นทางแข่งขันใหม่ของภาคการผลิต ทำไมตัวเลข 10.7% ถึงสำคัญกับโรงงานไทยมากกว่าที่คิด หลายฝ่ายอามแย้งว่า "AI adoption" ที่รายงานวัดจากประชากรทั้งหมด ไม่ได้วัดที่ระดับองค์กร แต่ประเด็นสำคัญอยู่ที่ว่า คนที่จะใช้ AI ในโรงงาน ก็มาจากกลุ่มประชากรนี้แหละ เมื่อฐานคนใช้ AI ทั้งประเทศเล็ก ย่อมหมายความว่า: พนักงานสายเทคนิคที่คุ้นเคย AI หายากขึ้น — โรงงานที่ต้องการเริ่มใช้ machine learning ตรวจสอบคุณภาพ หรือ predictive maintenance จะพบว่า talent pool ในตลาดแคบกว่าที่คาด ช่องว่างระหว่างพูดถึงกับใช้จริงกว้างขึ้น — รายงานระบุชัดว่า ขณะที่ AI ถูกพูดถึงมากขึ้นทั่วประเทศ การใช้งานจริงของประชาชนยังจำกัด เกือบ 90% ของคนไทยยังไม่ใช้ AI หรือไม่มีโอกาสเข้าถึง —…
Read More