How-to: ทำ Explainable AI (SHAP/LIME) ให้โมเดล Predictive Maintenance — 5 ขั้นตอนทำให้ช่างเชื่อ AI จริงๆ

How-to: ทำ Explainable AI (SHAP/LIME) ให้โมเดล Predictive Maintenance — 5 ขั้นตอนทำให้ช่างเชื่อ AI จริงๆ

Article
โมเดล AI ทำนายความเสียหายของเครื่องจักรได้แม่นระดับ 90%+ แต่พอถูกถามว่า “ทำไมถึงบอกว่าเครื่องนี้เสี่ยง” กลับตอบไม่ได้ — นี่คือปัญหา black box ที่ทำให้ AI จำนวนมากติดอยู่ใน pilot ไม่มีวันถูกใช้จริงในสายการผลิต วิศวกรซ่อมบำรุงจะไม่มีวันเชื่อคำสั่งหยุดเครื่องที่ไม่มีเหตุผลรองรับ และผู้จัดการโรงงานก็ไม่กล้าเสี่ยงตัดสินใจตามตัวเลขที่อธิบายไม่ได้ บทความนี้เป็นคู่มือปฏิบัติ 5 ขั้นตอน สำหรับเพิ่มความโปร่งใสให้โมเดล predictive maintenance ด้วยเทคนิค Explainable AI (XAI) ปัญหา: ความแม่นยำไม่ใช่ข้ออ้างของความไว้วางใจ สถานการณ์มาตรฐานที่เราพบบ่อย: ทีม data scientist สร้างโมเดล gradient boosting ทำนายความเสี่ยงแบริ่งพังใน 14 วัน ได้ F1 สูงมากใน test set แต่พอ deploy จริง ช่างเทคนิคกลับแค่ “ดูเลข” แล้วเดินผ่าน เพราะโมเดลไม่เคยบอกว่าสัญญาณมาจากไหน — ความร้อน? การสั่น? หรือค่าไฟฟ้าที่ปนเปื้อน? ผลคือระบบถูกละเลยจนถูกถอดออกในที่สุด งานวิจัยด้าน XAI ในภาคอุตสาหกรรมชี้ตรงกันว่า การนำ AI ไปใช้กับงาน maintenance ล้มเหลวไม่ใช่เพราะโมเดลไม่แม่น แต่เพราะ คนในสายการผลิตไม่มีเครื่องมือตรวจสอบเหตุผลของโมเดลได้ ซึ่ง XAI แก้ปัญหานี้ตรงจุด 2 เทคนิคหลัก: LIME และ SHAP โมเดล gradient boosting หรือ neural network รุ่นใหม่แม่นกว่า linear model มาก แต่แลกมาด้วยความอธิบายไม่ได้ XAI จึงเข้ามาเป็น “สะพาน” ระหว่างความแม่นกับความเข้าใจ: LIME (Local Interpretable Model-agnostic Explanations) — สร้างโมเดลลินแมร์ตัวจิ๋วมาลอกเลียนพฤติกรรมของโมเดลใหญ่ “ในบริเวณใกล้” การทำนายหนึ่งๆ แล้วอ่านค่าสัมประสิทธิ์ จะรู้ทันทีว่า feature ไหนดันความน่าจะเป็นขึ้น ตัวไหนฉุดไว้ SHAP (SHapley Additive exPlanations) — ยืมแนวคิด Shapley value จากทฤษฎีเกม คำนวณ “ส่วนแบ่งความดีความชั่ว” ของ feature แต่ละตัวอย่างเป็นธรรม โดยเฉลี่ยผลจากทุก combination ที่เป็นไปได้ ให้ค่าที่ consistent และมีหลักทฤษฎีรองรับ โครงสร้าง hidden layer ของ neural network…
Read More
บทวิเคราะห์ Over-Optimization Trap: ทำไมระบบที่ Efficient ที่สุดคือระบบที่เปราะบางที่สุด — บทเรียน Resilience ยุค Industry 5.0

บทวิเคราะห์ Over-Optimization Trap: ทำไมระบบที่ Efficient ที่สุดคือระบบที่เปราะบางที่สุด — บทเรียน Resilience ยุค Industry 5.0

Article
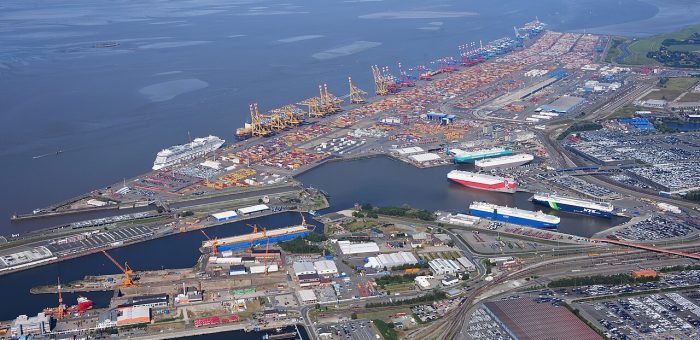
ยี่สิบปีที่แล้ว คำว่า "Lean" และ "Just-in-Time" คือคำตอบสุดท้ายของวงการผลิต — ตัดสต๊อกให้เหลือน้อยที่สุด ตัด Waste ให้หมด บีบ Supplier ให้ส่งของถี่ขึ้นเรื่อยๆ แล้ว COVID-19 ก็มาถึง ตามด้วยสงครามการค้า ความขัดแย้งภูมิรัฐศาสตร์ และวิกฤตพลังงาน โลกของปี 2026 ค้นพบความจริงข้อหนึ่ง: ระบบที่ Optimize สูงสุดคือระบบที่เปราะบางสูงสุด นี่คือบทวิเคราะห์ปรากฏการณ์ที่เราเรียกว่า "กับดักการ Optimize เกินพอดี" (Over-Optimization Trap) — และเหตุใด Industry 5.0 จึงยกเรื่อง Resilience ขึ้นเป็นเสาหลักเทียบเท่าประสิทธิภาพ ท่าเรือคอนเทนเนอร์คือภาพจำของ Global Value Chains — ระบบที่มีประสิทธิภาพสูงที่สุดในประวัติศาสตร์ และก็เปราะบางที่สุดเมื่อโลกหยุดหมุน (ภาพ: Wikimedia Commons, Public Domain) กับดักทำงานอย่างไร — 3 กลไกที่มองไม่เห็นในตาราง Excel 1. Efficiency กับ Resilience คือ Trade-off ที่ซ่อนอยู่ ทุกครั้งที่เราตัดสต๊อก Buffer ลง รวม Supplier จาก 5 รายเหลือ 1 ราย (เพื่อราคาดีกว่า) หรือรวมโรงงานจาก 3 แห่งเหลือ 1 แห่ง (เพื่อ Economies of Scale) — เรากำลังแลก "ความเปราะบาง" ซื้อ "ประสิทธิภาพ" โดยที่ตัวเลขในงบการเงินแสดงเฉพาะครึ่งหลัง เอกสารวิเคราะห์ของสภาอุตสาหกรรมแห่งประเทศไทย (FTPI) ปี 2026 ชี้ตรงว่าแนวทาง Just-in-Time ที่เน้นประสิทธิภาพสูงสุดของ Industry 4.0 กลายเป็น "ความเปราะบางเมื่อเผชิญเหตุการณ์ไม่ปกติ" — วิกฤตด้านสาธารณสุข เศรษฐกิจ ภูมิรัฐศาสตร์ และการหยุดชะงักของห่วงโซ่อุปทาน 2. Rebound Effect — เทคโนโลยีประหยัดทรัพยากรที่ทำให้ใช้ทรัพยาศเพิ่ม เอกสารเดียวกันอธิบายปรากฏการณ์ที่ถูกมองข้าม: เมื่อเทคโนโลยีทำให้ต้นทุนการผลิตลดลง ความต้องการก็เพิ่มขึ้นจน "หักล้างประสิทธิภาพที่ทำไว้" — โรงงานที่ประหยัดพลังงานต่อหน่วยได้ 20% อาจผลิตเพิ่ม 30% สุทธิคือใช้พลังงานมากขึ้น นี่คือเหตุผลที่เป้าหมาย Sustainability ของ Industry 5.0 ต้องมาพร้อมระบบวัดผลจริง (Carbon Accounting, Energy Submetering…
Read More
บทวิเคราะห์ Motor Current Signature Analysis (MCSA): เมื่อมอเตอร์คือเซ็นเซอร์ของตัวเอง — Pole Pass Frequency และ Sideband dB

บทวิเคราะห์ Motor Current Signature Analysis (MCSA): เมื่อมอเตอร์คือเซ็นเซอร์ของตัวเอง — Pole Pass Frequency และ Sideband dB

Article
บทวิเคราะห์: ทำไมสัญญาณที่ "พร้อมใช้" ที่สุดในโรงงาน กลับถูกมองข้ามมานานที่สุด ในโลกของ Condition Monitoring เราคุ้นเคยกับการติดเซ็นเซอร์วัดการสั่นสะเทือนบนตัวมอเตอร์ ติดเทอร์มอคัปเปิลวัดอุณหภูมิ หรือส่งน้ำมันเข้าห้องแล็บ แต่มีสัญญาณหนึ่งที่พร้อมใช้งานอยู่แล้วในทุกมอเตอร์ไฟฟ้า โดยไม่ต้องติดอะไรเพิ่มเลย — กระแสไฟฟ้าที่ไหลเข้าสู่ขดลวดสเตเตอร์ นี่คือจุดเริ่มต้นของเทคนิคที่ชื่อว่า Motor Current Signature Analysis (MCSA) หลักการง่ายๆ คือแรงบิดของมอเตอร์เหนี่ยวนำสัมพันธ์โดยตรงกับกระแสโรเตอร์ เมื่อชิ้นส่วนกลไกภายในเริ่มผิดปกติ ไม่ว่าจะเป็นแท่งนำของโรเตอร์หลุด ความไม่สมดุลของช่องอากาศ (Airgap Eccentricity) หรือแม้แต่โหลดกลไกที่กระตุก เฟร์ชชูเรชันของความเร็วรอบนั้นจะถูกสะท้อนกลับมาปรากฏเป็น Sideband รอบๆ ความถี่ไฟฟ้าในสเปกตรัมของกระแส นั่นคือเหตุผลที่นักวิเคราะห์บอกว่า "มอเตอร์คือเซ็นเซอร์ของตัวเอง" ขดลวดสเตเตอร์ — จุดที่สัญญาณกลไกทั้งหมดของมอเตอร์และโหลดถูก "มอดูเลต" ลงบนกระแสไฟฟ้า กลายเป็นข้อมูลวินิจฉัยที่เข้าถึงได้จากหน้าปัดเดียว | ภาพ: public domain คณิตศาสตร์ที่โรงงานควรรู้: Pole Pass Frequency สูตรสำคัญที่สุดของ MCSA คือการหา Pole Pass Frequency (PPF) ซึ่งกำหนดโดย: Slip (s) = (Ns - Nr) / Ns # Ns = synchronous speed, Nr = rated speed PPF = Slip × P × f_line # P = number of pole pairs Sideband = f_line ± n x PPF # n = 1, 2, 3, ... ตัวอย่างเชิงตัวเลข: มอเตอร์ 4 โพล (2 pole pairs) ความถี่ไฟฟ้า 50 Hz ความเร็วพร้อมนามมาตรฐาน 1,470 rpm จะมี Synchronous Speed 1,500 rpm คำนวณ Slip = 2% ดังนั้น PPF = 0.02 × 2…
Read More
Case Study: Oil Analysis กับระบบไฮดรอลิคที่ ISO 4406 เกินเกณฑ์ — จาก 21/19/16 สู่ 17/15/12 ใน 6 เดือน

Case Study: Oil Analysis กับระบบไฮดรอลิคที่ ISO 4406 เกินเกณฑ์ — จาก 21/19/16 สู่ 17/15/12 ใน 6 เดือน

Article
บทนำ: เมื่อ "เดือนดาว" เริ่มจากขวดน้ำมันเพียงขวดเดียว โรงงานผลิตชิ้นส่วนยนต์แห่งหนึ่งใน ระยะคุมภัย 1 ปี พบว่าเครื่องจักรไฮดรอลิคหยุดกะทันหันบ่อยครั้งขึ้นเรื่อยๆ จนกระทั่งช่างเทคนิคเริ่มชินกับคำว่า "อีกแล้ว" ทุกครั้งที่ไฟสัญญาณเตือนเครื่องตัดกำลังบนเครื่อง Press ขนาดใหญ่กะพริบ ฝ่ายบำรุงรักษาใช้แนวทาง Run-to-Failure มาตลอด เพราะ "เครื่องอื่นก็เป็นแบบนี้" และการหยุดเพื่อตรวจสภาพถือเป็นการรบกวนสายการผลิต จุดเปลี่ยนมาถึงเมื่อทีมวิศวกรเสนอแผนนำร่องที่แทบไม่ต้องลงทุนอะไรเลย: เก็บตัวอย่างน้ำมันส่งตรวจแล็บ ตามรอบเวลาที่กำหนด และติดตามผลเป็นตัวเลข ไม่ใช่ความรู้สึก ห้องแล็บวิเคราะห์น้ำมันอุตสาหกรรม — ผลวิเคราะห์จากที่นี่คือ "ผลตรวจเลือด" ของเครื่องจักร ที่บอกทั้งสุขภาพน้ำมันและสุขภาพชิ้นส่วนภายใน | ภาพ: U.S. Army, public domain ปัญหา: ทำไมการเปลี่ยนน้ำมันตามเวลาจึงไม่พอ โรงงานส่วนใหญ่เปลี่ยนน้ำมันตามรอบเวลา (Time-Based) เช่น ทุก 4,000 ชั่วโมงการทำงาน ซึ่งเป็นวิธีที่ง่ายและถูกต้องตามคู่มือ แต่มีข้อจำกัดสองด้าน ด้านแรกคือน้ำมันที่ยังใช้งานได้ดีถูกทิ้งก่อนวัยอันควร ด้านที่สองและอันตรายกว่าคือน้ำมันที่ "เสียก่อนเวลา" จากการปนเปื้อนน้ำ ความร้อนสูง หรืออนุภาคโลหะ ไม่ได้ถูกพบจนกว่าความเสียหายจะเกิดขึ้นแล้ว ในกรณีของโรงงานชิ้นส่วนยนต์นี้ ผลวิเคราะห์รอบแรกจากเครื่อง Press ตัวหลักพบค่าความสะอาดตามมาตรฐาน ISO 4406 อยู่ที่ 21/19/16 ในขณะที่ค่าเป้าหมายของระบบไฮดรอลิคแรงดันสูงควรอยู่ที่ 18/16/13 หรือดีกว่า ตัวเลขสามชั้นนี้แทนจำนวนอนุภาคต่อมิลลิลิตร ที่ขนาดมากกว่า 4 ไมครอน, 6 ไมครอน และ 14 ไมครอนตามลำดับ — โดยแต่ละเลขคือลอการิทึมของจำนวนอนุภาค (เลขเพิ่ม 1 = อนุภาคเพิ่มประมาณ 2 เท่า) น้ำมันไฮดรอลิค — ตัวกลางถ่ายทอดพลังงานที่ต้องการ "ความสะอาด" มากกว่าที่หลายโรงงานคิด เพราะอนุภาคแข็งขนาด 1–5 ไมครอนเข้าไปเกาะในช่องว่างภายในวาล์ว | ภาพ: public domain ทางแก้: โปรแกรม Oil Analysis 4 ขั้นตอน ทีมวิศวกรร่วมกับห้องแล็บออกแบบโปรแกรมตรวจสอบน้ำมันเชิงรุก 4 ขั้นตอน: จัดทำรายการเครื่องจักรและ Baseline — เก็บตัวอย่างน้ำมันจากทุกถังสำคัญ พร้อมระบุจุดเก็บตัวอย่างมาตรฐานให้ช่างทุกคนใช้จุดเดียวกันเพื่อความเปรียบเทียบได้ กำหนดเกณฑ์เป้าหมาย (Target Cleanliness) — ระบบไฮดรอลิคแรงดันสูงกำหนดที่ 18/16/13, Gearbox ที่ 17/15/12, น้ำมันหล่อลื่นแบริ่งที่ 16/14/11 เก็บตัวอย่างตามรอบสม่ำเสมอ — เครื่องวิกฤตทุกเดือน, เครื่องสำคัญทุก 3 เดือน โดยเก็บขณะเครื่องกำลังทำงานหรือหลังหยุดไม่เกิน 15 นาที ปฏิบัติตามผล (Act…
Read More
Vibration Analysis: อ่านลายเซ็นความถี่จากเครื่องจักรก่อนที่มันจะพัง — Deep Dive จาก FFT ถึง ISO 20816

Vibration Analysis: อ่านลายเซ็นความถี่จากเครื่องจักรก่อนที่มันจะพัง — Deep Dive จาก FFT ถึง ISO 20816

Article
ทำไม "เสียงเครื่องจักร" จึงโกหกคุณได้ แต่ "ค่าการสั่นสะเทือน" โกหกไม่ได้ ช่างเทคนิคที่เก่งที่สุดในโรงงานมักบอกได้ว่าเครื่องจักรกำลังจะพัง "จากเสียง" — แต่หูมนุษย์มีข้อจำกัดสองข้อที่ยอมรับกันในวงวิศวกรรมเครื่องกล ข้อแรกคือหูคนได้ยินตั้งแต่ 20 Hz ถึงราว 20,000 Hz ในขณะที่สัญญาณบ่งชี้ความเสียหายระยะแรกของลูกสูบมักเกิดที่ความถี่ต่ำกว่านั้น ข้อสองคือสมองมนุษย์ "ชิน" กับเสียงที่เพิ่มขึ้นอย่างค่อยเป็นค่อยไปในแต่ละวัน จนกระทั่งวันหนึ่งเครื่องหยุดกลางคัน Vibration Analysis คือการเปลี่ยนสัญญาณการสั่นสะเทือนให้กลายเป็นตัวเลขที่วัดได้ ตรวจสอบซ้ำได้ และเปรียบเทียบข้ามเวลาได้ ด้วยหลักการง่ายๆ ว่า ทุกความผิดปกติเชิงกล มีลายเซ็นความถี่เป็นของตัวเอง ลูกสูบ (Rolling Element Bearing) — แหล่งกำเนิดความถี่บกพร่องที่นำไปคำนวณเป็น BPFO, BPFI, BSF และ FTF ได้ | ภาพ: public domain หลักการ 4 ขั้น: จากคลื่นสั่นสะเทือนสู่การวินิจฉัย ขั้นตอนการวิเคราะห์มาตรฐานในอุตสาหกรรมคือ (1) เก็บสัญญาณด้วยเซ็นเซอร์วัดความเร่ง (Accelerometer) ที่ติดตั้งบนตัวเครื่องจักรใกล้จุดรับน้ำหนัก (2) แปลงสัญญาณแรงดันไฟฟ้าให้เป็นหน่วยความเร่ง g ผ่านตัวเก็บประจุภายในเซ็นเซอร์แบบ Piezoelectric (3) นำข้อมูลดิบผ่านการแปลงฟูเรียร์ (FFT) เพื่อแยกสัญญาณออกเป็นแต่ละความถี่ และ (4) ตีความความถี่ที่โดดออกมาเทียบกับความถี่บกพร่องทางทฤษฎีของเครื่องจักร เซ็นเซอร์ 100 mV/g เป็นสเปกที่พบมากที่สุดในโรงงานอุตสาหกรรม ส่วนความถี่ในการเก็บข้อมูล (Sampling Rate) ต้องเป็นอย่างน้อย 2.56 เท่าของความถี่สูงสุดที่สนใจตามทฤษฎีบทของไนควิสต์ เช่น ต้องการวิเคราะห์ถึง 10 kHz ต้องเก็บข้อมูลที่ 25.6 kHz การติดตั้งเซ็นเซอร์วัดค่าที่จุดสำคัญ ตำแหน่งและวิธีติดตั้ง (แม่เหล็ก/สติ๊ก/ยึดสกรู) มีผลต่อความถี่สูงสุดที่วัดได้จริง | ภาพ: NASA, public domain ตารางลายเซ็นความถี่: อ่านตัวโรคเครื่องจักรให้เป็น ความถี่ที่พบ สาเหตุที่พบบ่อย สิ่งที่ควรตรวจสอบต่อ 1×RPMความไม่สมดุล (Unbalance)น้ำหนักเพิ่มจากเศษวัสดุหรือฝุ่นเป็นก้อนบนใบพัด หรือโรเตอร์โค้งงอ โดยเฟสของสัญญาณจะนิ่งไม่เปลี่ยน 2×RPMเพลาไม่ได้แนว (Misalignment)ตรวจการจัดแนวเพลาด้วยเลเซอร์ ทั้งแนวออฟเซ็ตและแนวมุม BPFO / BPFIลูกสูบเสียหาย (แหวนนอก/ใน)โดยเฉพาะเมื่อมี Sideband ของ FTF ปรากฏร่วมด้วย หมายถึงการสึกหรอลุกลาม ราว 0.42–0.48×RPMฟิล์มน้ำมันไม่เสถียร (Oil Whirl)ตรวจระดับความหนืดน้ำมัน แรงดันน้ำมันหล่อลื่น และ Load ของ Sleeve Bearing — มักพบในเครื่องจักรความเร็วสูง ความถี่ลูกผสม (Line Frequency ×…
Read More
Case Study: Store-and-Forward กู้ข้อมูลหายช่วงเน็ตหลุด — เมื่อ Edge Gateway ของโรงงานอาหารต้องเก็บข้อมูล HACCP ให้ครบ

Case Study: Store-and-Forward กู้ข้อมูลหายช่วงเน็ตหลุด — เมื่อ Edge Gateway ของโรงงานอาหารต้องเก็บข้อมูล HACCP ให้ครบ

Article
สถานการณ์: เมื่ออินเทอร์เน็ตโรงงานหลุดทุกเดือน ข้อมูลหายทุกครั้ง โรงงานแปรรูปอาหารแห่งหนึ่งในภาคกลางติดตั้งระบบเฝ้าระวังอุณหภูมิตู้แช่ด้วย IIoT Gateway ส่งข้อมูลขึ้นคลาวด์ทุก 30 วินาที เพื่อใช้ตรวจสอบย้อนหลังตามข้อกำหนด HACCP ปัญหาเกิดขึ้นเมื่อลิงก์อินเทอร์เน็ตของโรงงาน (ทั้ง fiber หลักและ 4G backup) ล่มพร้อมกันในช่วงพายุฤดูฝน เป็นเวลาราว 4 ชั่วโมง ข้อมูลช่วงนั้นหายไปทั้งหมด และทีมคุณภาพต้องเขียนรายงานอธิบายช่องว่างข้อมูลให้ผู้ตรวจสอบฟังทุกครั้ง ช่องว่างข้อมูลระหว่าง edge กับคลาวด์คือจุดที่พบปัญหาบ่อยที่สุดของระบบ IIoT (ภาพ: Honey Corporation) วินิจฉัยต้นตอ: สถาปัตยกรรมสมมติว่าเครือข่ายไม่มีวันล่ม การวิเคราะห์พบว่า gateway เดิมออกแบบแบบ "fire-and-forget" คืออ่านค่าเซ็นเซอร์แล้วส่งขึ้นคลาวด์ทันที หากส่งไม่สำเร็จก็ปล่อยข้อมูลนั้นหายไป ไม่มีการเก็บสำรองใดๆ บนตัวเครื่อง สถาปัตยกรรมลักษณะนี้ยอมรับได้กับ dashboard ดูสภาพแวดล้อมทั่วไป แต่ไม่เกิดผลกับงานที่ต้องมีหลักฐานข้อมูลต่อเนื่องตามกฎระเบียบ ทางแก้: Store-and-Forward บน Edge Gateway หลักการคือข้อมูลต้อง "เขียนลงดิสก์สำเร็จก่อน" แล้วจึงส่ง หากส่งไม่ได้ให้เก็บต่อในคิวจนกว่าเครือข่ายกลับมา ส่วนประกอบสำคัญมี 4 อย่าง Local persistent queue เก็บข้อมูลเป็นไฟล์บนดิสก์ gateway (เช่น embedded database หรือ log-structured storage) แยกจาก RAM เพื่อรอดจากไฟฟ้าดับ Send-then-acknowledge ข้อมูลถูกลบออกจากคิวเมื่อ server ปลายทางตอบรับสำเร็จเท่านั้น ไม่ใช่แค่ส่งออกไปแล้ว Circular buffer policy กำหนดขนาดคิวสูงสุดและนโยบายเมื่อเต็ม เช่น เขียนทับข้อมูลเก่าที่สุด หรือหยุดรับและเปิด alarm Timestamp ที่ต้นทาง ประทับเวลา ณ จุดอ่านค่าเซ็นเซอร์ ไม่ใช่เวลาที่ส่งสำเร็จ เพื่อให้ข้อมูลย้อนหลังยังถูกต้อง MQTT QoS 1 ร่วมกับ persistent session ช่วยให้ broker และ client จัดการข้อความค้างส่งได้อย่างเป็นระบบ (ภาพ: Honey Corporation) ในทางโปรโตคอล การเลือกใช้ MQTT ระดับ QoS 1 ร่วมกับ persistent session และการตั้งค่า message expiry interval ช่วยให้ broker ทำหน้าที่คล้ายกันในระดับหนึ่ง แต่สำหรับ outage ยาวหลายชั่วโมง การมีคิวบนดิสก์ของ gateway เองยังจำเป็น เพราะไม่ต้องพึ่ง TCP connection ที่ต้องเชื่อมต่อใหม่ทั้งหมด…
Read More
Smart Materials ในโรงงานอุตสาหกรรม: เมื่อวัสดุกลายเป็นเซ็นเซอร์และ Actuator ไปพร้อมกัน

Smart Materials ในโรงงานอุตสาหกรรม: เมื่อวัสดุกลายเป็นเซ็นเซอร์และ Actuator ไปพร้อมกัน

Article
ถ้ามองย้อนไปสิบปีที่แล้ว "วัสดุ" ในโรงงานคือสิ่งที่ถูกซื้อมา ถูกใช้ และถูกเปลี่ยนเมื่อเสีย — ไม่มีส่วนร่วมในระบบดิจิทัลเลย แต่ในปี 2026 แนวคิดกำลังพลิกไปจากเดิม: วัสดุอัจฉริยะ (Smart Materials) กลายเป็น "โหนดข้อมูลชิ้นหนึ่งของระบบ IIoT" ที่รู้สภาพตัวเอง สื่อสารได้ และตอบสนองต่อสภาพแวดล้อมโดยไม่ต้องรอคำสั่งจากภายนอก รายงานเทรนด์อุตสาหกรรมล่าสุดถึงกับจัดให้ Smart Materials เป็นหนึ่งใน 6 เทรนด์หลักของการผลิตปี 2026 พร้อมคาดการณ์มูลค่าตลาดระดับ 1.33 แสนล้านดอลลาร์ภายในปี 2030 บทความนี้เจาะลึกกลไกทางฟิสิกส์ของวัสดุอัจฉริยะ 4 ตระกูลหลักที่เริ่มใช้งานจริงในภาคอุตสาหกรรม พร้อมชี้จุดที่วิศวกรโรงงานควรประเมินก่อนตัดสินใจนำไปใช้ วัสดุอัจฉริยะต่างจากวัสดุทั่วไปอย่างไร วัสดุทั่วไปมีสมบัติคงที่ (Passive) — แข็งแรงเท่าเดิม นำความร้อนเท่าเดิมไม่ว่าสภาวะรอบตัวจะเปลี่ยนไปแค่ไหน วัสดุอัจฉริยะต่างออกไปตรงที่มีสมบัติที่ ตอบสนองต่อสิ่งเร้า (Stimuli-Responsive) อย่างตั้งใจ ไม่ว่าจะเป็นความร้อน แรงสั่น สนามไฟฟ้า หรือความชื้น เมื่อสิ่งเร้าเปลี่ยน โครงสร้างระดับโมเลกุลของวัสดุจัดตัวใหม่ ทำให้เกิดการเปลี่ยนรูป สร้างประจุไฟฟ้า หรือเปลี่ยนสีอย่างย้อนกลับได้ จุดที่ทำให้เรื่องนี้สำคัญกับคนทำ IIoT คือ เมื่อวัสดุ "ตอบสนอง" ได้เอง เราสามารถอ่านค่าการตอบสนองนั้นออกมาเป็นข้อมูล หรือใช้มันเป็นตัวขับ (Actuator) ได้โดยตรง — วัสดุจึงกลายเป็นทั้งเซ็นเซอร์และอินสตรูเมนต์ในชิ้นเดียว ลดจำนวนอุปกรณ์เสริมที่ต้องติดตั้งบนเครื่องจักร เซ็นเซอร์เพียโซอิเล็กทริกแบบแผ่น — หนึ่งในรูปแบบที่พบมากที่สุดของวัสดุอัจฉริยะในงาน Monitor แรงสั่นสะเทือนเครื่องจักร (ภาพ: Wikimedia Commons) 4 ตระกูลวัสดุอัจฉริยะที่ใช้งานจริงในโรงงาน 1. Piezoelectric — วัสดุที่แปลงแรงกดเป็นไฟฟ้า ผลึกเพียโซอิเล็กทริกเช่น PZT (Lead Zirconate Titanate) จะเกิดประจุไฟฟ้าบนผิวเมื่อถูกกดหรือสั่น หลักการนี้ถูกใช้สองทางคู่ขนานกัน: ทางแรกคือเป็นเซ็นเซอร์วัดแรงสั่นความถี่สูง (เหมาะกับงาน Vibration Analysis ของลูกสูบ ปั๊ม และแบริ่งความเร็วสูงที่สัญญาณอยู่ในย่าน kHz) ทางที่สองคือ Energy Harvesting — ใช้แรงสั่นเหลือทิ้งจากเครื่องจักรสร้างไฟฟ้าระดับมิลลิวัตต์เลี้ยงเซ็นเซอร์ไร้สายแบบไม่ต้องเปลี่ยนแบตเตอรี่ ซึ่งเปลี่ยนเกมการติดตั้งเซ็นเซอร์บนเครื่องจักรหมุนที่เดิมต้องวางสายไฟข้ามจุดหมุน 2. Shape Memory Alloy (SMA) — โลหะที่จำรูปและกลับตัวเองได้ โลหะผสมนิกเกิล-ไทเทเนียม (NiTi) สามารถ "จำ" รูปร่างที่ตั้งโปรแกรมไว้ แล้วกลับไปหารูปนั้นเมื่อได้รับความร้อนหรือกระแสไฟฟ้า ในโรงงาน SMA ถูกใช้ทำ Actuator ขนาดเล็กที่มีอัตราส่วนแรงต่อน้ำหนักสูงและกลไกน้อยชิ้นกว่า ตั้งแต่วาล์วนิวแมติกทดแทน คลัตช์แบบอ่อนตัวเมื่อร้อน (ป้องกัน Overload) ไปจนถึงข้อต่อกันสั่นสะเทือนในโครงสร้างอาคารและงานยานยนต์ กลไก Shape Memory Effect: โครงผลึกเปลี่ยนเฟสระหว่างมาร์เทนไซต์ (เย็น)…
Read More
Case Study: Smart Earplugs กับ Noise Dosimetry — เมื่อโรงงานย้ายจุดวัดเสียงจากอากาศเข้าไปในหูของคนงาน

Case Study: Smart Earplugs กับ Noise Dosimetry — เมื่อโรงงานย้ายจุดวัดเสียงจากอากาศเข้าไปในหูของคนงาน

Article
โรคประสาทหูเสียจากเสียงดัง (Noise-Induced Hearing Loss) เป็นโรคจากการทำงานที่พบมากที่สุดโรคหนึ่งของโลก แต่กลับเป็นโรคที่ ป้องกันได้เกือบทั้งหมด ถ้าจัดการถูกวิธี ปัญหาคือ "ถูกวิธี" นั้นยากกว่าที่คิด เพราะที่ดังในโรงงานไม่คงที่ ที่อุดหูที่แจกให้คนงานมักใส่ไม่แนบพอ และผู้ดูแลความปลอดภัยไม่มีข้อมูลว่าแต่ละคนสัมผัสเสียงเท่าไรจริง ๆ ในแต่ละวัน บทความนี้เป็น case study เชิงกระบวนการ — ถอดรหัสว่าโรงงานหนึ่งแก้ปัญหานี้ด้วยการผสาน Smart Earplugs แบบวัดโดสเสียง (Noise Dosimetry) เข้ากับโปรแกรมอนุรักษ์การได้ยิน (Hearing Conservation Program) ตั้งแต่วินิจฉัยปัญหา ไปจนถึงผลลัพธ์ที่วัดได้ การใส่ที่อุดหูให้แนบสนิทคือขั้นตอนที่มักทำผิด — งานวิจัยด้านอนุรักษ์การได้ยินพบว่าที่อุดหูที่ใส่ไม่พอดีให้การลดเสียงจริงน้อยกว่าค่า NRR บนฉลากอย่างมาก (ภาพ: Wikimedia Commons, Public Domain) ปัญหา: ฉลากบอกอย่าง ความจริงอย่าง จุดเริ่มของ case นี้คือคำถามสั้น ๆ ที่ผู้จัดการโรงงานตั้งขึ้นหลังได้รับผลตรวจการได้ยินประจำปี: "เราแจกที่อุดหู NRR อย่างดีทุกคน ทำไม % การได้ยินผิดปกติยังเพิ่มขึ้นทุกปี?" เมื่อไล่หาสาเหตุ พบปัญหา 3 ชั้นที่ซ้อนกัน: ค่า NRR บนฉลากไม่ใช่ค่าที่ได้จริง — NRR (Noise Reduction Rating) วัดในห้องทดลองกับผู้ทดสอบที่ใส่อย่างสมบูรณ์แบบ แต่งานวิจัยสาธารณะด้าน fit testing พบว่าคนงานทั่วไปได้การลดเสียงจริงเพียงบางส่วนของค่าฉลาก บางกรณีต่ำกว่าครึ่ง เพราะใส่หลวม ไม่บีบยางก่อนสอด หรือถอดออกคุยโทรศัพท์ระหว่างกะ ค่าเฉลี่ยพื้นที่ปกปิดช่วงพีค — การวัดด้วย sound level meter จุดลอยให้ค่าเฉลี่ย 8 ชั่วโมง แต่งานจริงมีช่วงพีคสั้น ๆ ที่ดังกว่ามาก เช่น การเป่าลมแรง การเคาะตะแกรง หรือช่วงเปลี่ยนดรัมเจียร ซึ่งไม่ปรากฏในค่าเฉลี่ย ไม่มีข้อมูลรายบุคคล — สองคนทำงานแผนกเดียวกันอาจสัมผัสเสียงต่างกัน 3 เท่า ขึ้นกับตำแหน่งจริงและงานที่ได้รับมอบหมายวันนั้น การออกแบบมาตรการด้วยค่าเฉลี่ยจึงปกป้องบางคนเกิน บางคนไม่พอ โซลูชัน: ย้ายจุดวัดเข้าไปในหูของคนงาน แนวทางที่เลือกคือการติดตั้ง Smart Earplugs ที่มีไมโครโฟนวัดโดสติดตัว ในกลุ่มตัวอย่างแรก 30 คนจากแผนกเสียงดังสุด อุปกรณ์ประเภทนี้ทำงาน 3 หน้าที่พร้อมกัน: ป้องกัน — ตัวปิดหูแบบ passive ลดเสียงระดับ 20–27 dB ตามดีไซน์ (ค่า SNR อ้างอิงมาตรฐาน ISO 4869-2) วัด —…
Read More
Case Study: Twin Decay — เมื่อ Digital Twin คลาดเคลื่อนเงียบๆ จนคนหยุดเชื่อ และวิธีฟื้นความเชื่อมั่นด้วย VVUQ

Case Study: Twin Decay — เมื่อ Digital Twin คลาดเคลื่อนเงียบๆ จนคนหยุดเชื่อ และวิธีฟื้นความเชื่อมั่นด้วย VVUQ

Article
Case Study: ดิจิทัลทวินที่ "เงียบๆ คลาดเคลื่อน" — บทเรียนจากโครงการจำลองระบบทำความเย็น โครงการดิจิทัลทวินจำนวนมากไม่ได้ตายด้วยการพังเด่นตัว แต่ตายอย่างเงียบๆ — ระบบยังเดินอยู่ dashboard ยังสวย ค่าทำนายยังออกมา แต่ไม่มีใครเชื่อมันอีกแล้ว เพราะตัวเลขคลาดเคลื่อนจากความจริงมากขึ้นเรื่อยๆ จนทีมผลิตกลับไปใช้สมุดบันทึกและประสบการณ์ กรณีศึกษาสมมติข้างนี้รวบรวมจากรูปแบบความล้มเหลวที่พบบ่อยในโครงการจำลองระบบอุตสาหกรรม เพื่อเป็นแผนที่ป้องกันสำหรับทีมที่กำลังจะเริ่ม ห้องควบคุม SCADA — จุดที่ทีมผลิตใช้ตัดสินใจทุกวัน ถ้าค่าทำนายของดิจิทัลทวินเริ่มเบี่ยงจากค่าจริง ความเชื่อมั่นจะหายไปเร็วกว่าที่คิด (ที่มา: Wikimedia Commons, CC BY-SA 4.0) สถานการณ์: โครงการที่เริ่มด้วยดี โรงงานผลิตอาหารแห่งหนึ่งลงทุนสร้างดิจิทัลทวินของระบบทำความเย็น (chiller plant) ที่หล่อเย็นถังหมัก โดยเชื่อมข้อมูลอุณหภูมิ ความดัน และอัตราการไหลจาก SCADA มาป้อนโมเดลทางกายภาพ (physics-based model) ที่จำลองสมการถ่ายเทความร้อน เป้าหมายคือทำนายอุณหภูมิน้ำเย็นที่ตัวถังล่วงหน้า 30 นาที เพื่อปรับตารางเดินเครื่องคอมเพรสเซอร์ให้เหมาะกับช่วงโหลดสูง ช่วง 3 เดือนแรกเป็นเรื่องราวความสำเร็จ: ค่าทำนายตรงกับเซ็นเซอร์จริง คลาดเคลื่อนเฉลี่ยไม่ถึง 0.5°C ทีมงานตื่นเต้นกับ dashboard ที่มองเห็นอนาคตล่วงหน้า แล้วความเชื่อมั่นก็เริ่มถดถอยโดยไม่มีใครทันรู้ตัว อาการ: ความเบี่ยงเบนที่โตขึ้นทีละน้อย หลังเดินระบบ 6 เดือน ค่าทำนายเริ่มเบี่ยงจากค่าจริงเป็น 1.2°C เฉลี่ย และบางช่วงโหลดสูงพุ่งถึง 2.5°C ซึ่งทีมยังอธิบายไม่ได้ว่า "โมเดลผิด" หรือ "เครื่องจักรเปลี่ยน" ปัญหานี้คือสิ่งที่วงวิชาการเรียกว่า twin decay — สภาวะที่โมเดลเสื่อมสภาพเรื่อยๆ เมื่อระบบกายภาพเปลี่ยนไปจากวันที่โมเดลถูกสร้างและพิสูจน์ สาเหตุที่สืบค้นได้จากบันทึกโครงการ ฟิล์มตะกอนในหม้อต้ม (fouling) เปลี่ยนสัมประสิทธิ์ถ่ายเทความร้อน — โมเดลใช้ค่าสัมประสิทธิ์จากข้อมูลตอน commissioning แต่หลอดความร้อนสะสมตะกอนขึ้นเรื่อยๆ ทำให้พฤติกรรมจริงเบี่ยงจากสมการเดิม เซ็นเซอร์ 2 ตัวถูกสอบเทียบใหม่ (recalibration) — ค่าที่เข้าโมเดลเปลี่ยนกระโดด แต่ไม่มีใครบันทึกว่า "input ของโมเดลเปลี่ยนนิยาม" ทำให้การเทียบกับข้อมูลเก่าเสีย โหลดโรงงานเปลี่ยนตามผลิตภัณฑ์ใหม่ — สูตรใหม่ที่หนืดกว่าทำให้ภาระความร้อนที่ถังหมักต่างจากช่วงที่ใช้เทรนและ validate โมเดล (data distribution shift) ไม่มีกระบวนการ revalidation ตามรอบ — ทีมตั้งสมมติฐานว่า "โมเดลถูกแล้วตลอดไป" จึงไม่มีตัวชี้วัดความสดของโมเดล และไม่มีใครรู้ตัวว่าความเชื่อมั่นกำลังไหลออก แนวคิด Control Chart ที่วิศวกรคุ้นเคยนำมาใช้กับ "ความเสื่อมของโมเดล" ได้ — ติดตาม error ระหว่างค่าทำนายกับค่าจริงเหมือนติดตามคุณภาพกระบวนการ แล้วตั้ง control limit ให้แจ้งเตือนเมื่อโมเดลเริ่มเบี่ยง (ที่มา: Wikimedia…
Read More
บทวิเคราะห์: Prescriptive Maintenance (RxM) — เมื่อระบบบำรุงรักษาไม่ใช่แค่ทำนาย แต่บอกว่าควรทำอะไร

บทวิเคราะห์: Prescriptive Maintenance (RxM) — เมื่อระบบบำรุงรักษาไม่ใช่แค่ทำนาย แต่บอกว่าควรทำอะไร

Article
ทุกสายการผลิตเคยเจอคำถามนี้: ระบบแจ้งเตือนว่า "สัญญาณสั่นสะเทือนผิดปกติ" แล้วต่อไปล่ะ? ใครต้องไปดู ต้องซ่อมตอนไหน ถ้ารอก่อนจะเสียผลผลิตเท่าไร ถ้าหยุดเครื่องตอนนี้จะกระทบออร์เดอร์คือไหน — Prescriptive Maintenance (RxM) คือคำตอบที่อุตสาหกรรมกำลังเปลี่ยนไปหาในปี 2026 โดยมีรายงานจาก Hannover Messe ปีนี้ระบุว่า "Predictive Maintenance กำลังกลายเป็น Prescriptive" เป็นหนึ่งใน 12 เทรนด์หลักของปี ห้องควบคุมกลาง — จุดที่การแจ้งเตือนจาก predictive system ต้องถูกแปลงเป็นการตัดสินใจ ซึ่งยังเป็นงานของมนุษย์เต็มตัว (ภาพ: Z22 / Wikimedia Commons, CC BY-SA 4.0) ปัญหาของ Predictive: บอกว่า "จะเกิดอะไร" แต่ไม่บอกว่า "ควรทำอะไร" Predictive Maintenance ที่แข็งแรงแล้วหลายโรงงานยังคงเจอระยะสุดท้ายที่ติดอยู่ที่คน: โมเดลทำนายเก่ง แต่การแปลง prediction ให้เป็นการตัดสินใจยังต้องพึ่งประสบการณ์วิศวกร วิศวกรต้องชั่งน้ำหนักสภาพเครื่องจักรกับตารางผลิต อะไหล่พร้อมหรือไม่ และความสำคัญของสินทรัพย์แต่ละตัว ช่องว่างนี้คือสิ่งที่ RxM มาปิด — จากงานวิเคราะห์เชิงลึกของผู้ให้บริการ CMMS ระดับโลก: "ช่องว่างระหว่างสองกลยุทธ์นี้ไม่ใช่เซ็นเซอร์เพิ่มหรือ dashboard ที่สวยขึ้น แต่คือทีมของคุณได้รับข้อมูลที่ยังต้องตีความ หรือได้รับการตัดสินใจที่ปฏิบัติได้ทันที" RxM ทำงานอย่างไร: 3 ชั้นโครงสร้าง เพื่อให้คำแนะนำที่ "ตัดสินใจแทนได้" ระบบ RxM ต้องมี 3 ชั้นทำงานร่วมกัน ตามการวิเคราะห์ของผู้ให้บริการ CMMS ชั้นนำ: Condition Monitoring หลายโหมดต่อเนื่อง — เก็บสัญญาณ vibration, ultrasound, temperature และ magnetic field ด้วยความละเอียดพอจะเห็น failure signature ระยะต้นทั่วทั้ง fleet เครื่องจักร Automated Diagnostics — ระบุ failure mode เฉพาะเจาะจง ไม่ใช่แค่ "มีบางอย่างเปลี่ยน" การรู้ว่า vibration เพิ่มคือข้อมูล แต่การรู้ว่าแพทเทิร์นนั้นตรงกับ stage-two inner race bearing defect คือจุดเริ่มของการตัดสินใจ Prescription Layer — นำการวินิจฉัยไปชั่งน้ำหนักกับตัวแปรเชิงปฏิบัติการ (ตารางผลิต อะไหล่ในคลัง ความสำคัญของสินทรัพย์ แรงงาน ต้นทุนพลังงาน) แล้วส่งคืนเป็นคำแนะนำเฉพาะพร้อมผลลัพธ์ที่คาดหวัง หลายระบบใช้ digital…
Read More