WebAssembly (Wasm) ที่ Edge ของโรงงาน: บทวิเคราะห์ Container Alternative ที่ Cold Start ต่ำกว่า 1 ms

WebAssembly (Wasm) ที่ Edge ของโรงงาน: บทวิเคราะห์ Container Alternative ที่ Cold Start ต่ำกว่า 1 ms

Article
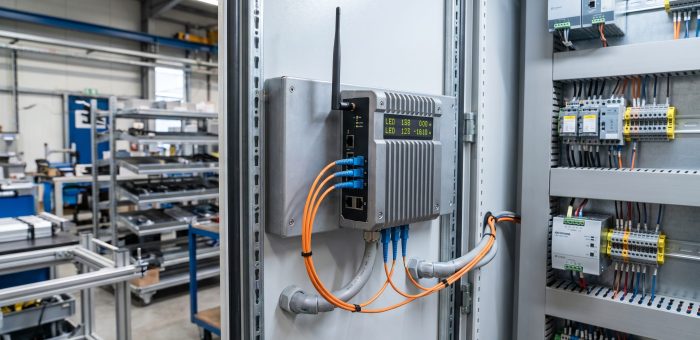
ทำไมโรงงานปี 2026 ถึงพูดถึง Wasm ที่ Edge หลายทีมที่ดูแลระบบ IIoT คุ้นเคยกับการ deploy โค้ดลง Edge Gateway ด้วยสองทางเลือกคลาสสิก คือคอมไพล์โปรแกรมลง OS ตรงๆ หรือห่อด้วย Linux Container แต่ทั้งสองวิธีมีข้อจำกัดที่เจ็บปวดเมื่อเครื่อข่าย Edge โตขึ้น โค้ดที่คอมไพล์ตรงๆ ย้ายระหว่างสถาปัตยกรรม CPU ไม่ได้ ส่วน Container กินทรัพยากรเริ่มต้นค่อนข้างมากและมีพื้นที่โจมตี (attack surface) กว้าง WebAssembly หรือ Wasm คือ binary format มาตรฐานเปิดที่แก้ปัญหาเหล่านี้ได้พร้อมกัน ตัวเลขจาก State of WebAssembly Survey ปี 2026 ชี้ว่าผู้ใช้งานจริงใน production ขึ้นไปถึง 67% เพิ่มจาก 47% ในปี 2024 และเป็นครั้งแรกที่การใช้งานฝั่ง server-side แซงการใช้ในเบราว์เซอร์ โดย 52% ของ deployment ใช้งานในสภาพแวดล้อมที่ไม่ใช่เบราว์เซอร์ Edge Gateway คือจุดที่เหมาะที่สุดในการรัน Wasm module เพราะเป็นชั้นที่ต้องการทั้งความปลอดภัยและการจัดการโค้ดหลากหลายสถาปัตยกรรม CPU (ภาพ: Honey Corporation) Wasm แตกต่างจาก Container ตรงไหน หัวใจของ Wasm คือ sandbox ระดับสถาปัตยกรรมที่ออกแบบมาตั้งแต่แรก โมดูล Wasm แต่ละตัวทำงานแยกจากกันโดยสิ้นเชิง และไม่สามารถเข้าถึงไฟล์ เครือข่าย หรือ hardware ใดๆ ได้เลยจนกว่า host จะมอบสิทธิ์ (capability) ให้อย่างชัดเจน ลักษณะเช่นนี้ต่างจาก Container ที่ process ภายในแชร์ kernel ของ host และเคยมีช่องโหว่ container escape หลายครั้งในอดีต มิติเปรียบเทียบ Linux Container Wasm Module Cold Start500 ms ถึง 2 วินาทีต่ำกว่า 1 ms Memory ขั้นต่ำ100 MB ขึ้นไป1–10 MB ความสามารถพอร์ตตาบิลิตี้ผูกกับ OS และ CPU archbinary…
Read More
ตลาด Smart Manufacturing 2026–2030: วิเคราะห์ตัวเลข 1.75 แสนล้านดอลลาร์ สู่ 2.74 แสนล้านดอลลาร์ และ 5 แรงขับเคลื่อนที่โรงงานไทยต้องรู้

ตลาด Smart Manufacturing 2026–2030: วิเคราะห์ตัวเลข 1.75 แสนล้านดอลลาร์ สู่ 2.74 แสนล้านดอลลาร์ และ 5 แรงขับเคลื่อนที่โรงงานไทยต้องรู้

Article
ปี 2026 ตลาดเทคโนโลยีการผลิตอัจฉริยะกำลังเปลี่ยนจาก "ความน่าตื่นเต้น" ไปเป็น "การแข่งขันจริง" รายงาน "Industry 4.0 & Smart Manufacturing Market Report 2026–2030" ฉบับล่าสุดจากสำนักวิเคราะห์ IoT Analytics ระบุว่า ตลาด Smart Manufacturing ทั่วโลกในปี 2025 มีมูลค่า 1.75 แสนล้านดอลลาร์สหรัฐ และจะเติบโตต่อด้วย CAGR 9.3% จนแตะ 2.74 แสนล้านดอลลาร์ภายในปี 2030 — เกือบ 1 แสนล้านดอลลาร์ของตลาดใหม่ที่จะเกิดขึ้นใน 5 ปี ตัวเลขนี้ไม่ใช่แค่สถิติ แต่สะท้อนการตัดสินใจลงทุนของโรงงานนับหมื่นแห่งทั่วโลก รวมถึงโรงงานไทยที่กำลังยืนอยู่ที่จุดเลือกทาง ระหว่างการเปลี่ยนผ่านที่เลือกเอง กับการถูกคู่ค้าและคู่แข่งบังคับให้เปลี่ยนในภายหลัง สายการผลิตอัตโนมัติในโรงงานสมัยใหม่ — สนามแข่งขันหลักของตลาด Smart Manufacturing มูลค่า 1.75 แสนล้านดอลลาร์ (ภาพ: Wikimedia Commons) 5 แรงขับเคลื่อนที่ทำให้ตลาดโตแบบ "หยุดไม่ได้" การเติบโต 9.3% ต่อปีไม่ได้มาจากเทคโนโลยีเพียงอย่างเดียว แต่มาจากแรงกดดัน 5 ด้านที่เข้ามาพร้อมกัน: แรงกดดันด้านต้นทุน — ค่าแรง พลังงาน และวัตถุดิบที่สูงขึ้นต่อเนื่อง บีบให้ผู้ผลิตต้องหาเทคโนโลยีมาลดความสูญเสียและเพิ่มประสิทธิภาพ ภูมิรัฐศาสตร์และ Supply Chain — กระแสย้ายฐานผลิตกลับ (Reshoring) ไปยังประเทศต้นทุนสูง ทำให้ระบบอัตโนมัติกลายเป็นเงื่อนไขของการอยู่รอด ไม่ใช่ทางเลือก วิกฤตแรงงาน — การขาดแคลนแรงงานฝีมือและโครงสร้างประชากรที่เปลี่ยน บังคับให้เครื่องจักรทำงานร่วมกับคนหรือทดแทนตำแหน่งที่หาคนไม่ได้ เทคโนโลยีพร้อมแล้ว — Edge Computing และ Cloud เสถียรพอที่จะเชื่อมโลก OT เข้ากับ IT ได้จริง ไม่ใช่แค่หน้ากระดาษ บอร์ดบริหารเร่ง AI — ผู้บริหารระดับสูงเร่งรัดให้นำ AI ลงสู่โรงงาน โดยเฉพาะกระแส Physical AI ที่เปลี่ยน AI จาก "ตัววิเคราะห์ข้อมูล" เป็น "ระบบที่ลงมือทำงานจริงบนพื้นโรงงาน" เมื่อผู้ขายเทคโนโลยีรายใหญ่เปลี่ยนสายพันธุ์: จากฮาร์ดแวร์สู่ซอฟต์แวร์ หนึ่งในสัญญาณที่สำคัญที่สุดของปี 2026 คือการเปลี่ยนยุทธศาสตร์ของผู้จำหน่ายเทคโนโลยีชั้นนำกว่า 750 รายในตลาดนี้ บริษัทยักษ์ใหญ่ 10 อันดับแรกต่างมีจุดยืนตรงกันคือ เปลี่ยนจากบริษัทฮาร์ดแวร์ ไปสู่สถาปัตยกรรมที่ขับเคลื่อนด้วยซอฟต์แวร์และผสมผสาน AI (Software-defined, AI-infused architectures) เป้าหมายปลายทางคือ "โรงงานอัตโนมัติที่สั่งการด้วยการรับรู้" (Perception-driven…
Read More
บทวิเคราะห์ IEC 61499: มาตรฐาน Distributed Automation ที่ถูกลืม 20 ปี กำลังกลับมาแรงในยุค Software-Defined Factory

บทวิเคราะห์ IEC 61499: มาตรฐาน Distributed Automation ที่ถูกลืม 20 ปี กำลังกลับมาแรงในยุค Software-Defined Factory

Article
ทุกครั้งที่วิศวกรอัตโนมัติคนหนึ่งลาออก ความรู้ในหัวของเขาก็หายไปพร้อมกัน ลองนึกภาพ: ตู้ PLC ที่ทำงานมา 12 ปี มี logic หลายพัน rung ที่แก้ไขข้ามหลายชั่วคน ไม่มีเอกสาร ไม่มีใครเข้าใจทั้งหมด และตอนนี้ต้องขยายสายการผลิตเพิ่ม สถานการณ์นี้คือ "หนี้ทางเทคนิค" (Technical Debt) ที่สะสมในโรงงานอุตสาหกรรมทั่วโลก และเป็นคำถามเปิดที่มาตรฐาน IEC 61499 ตั้งใจมาตอบ IEC 61499 คืออะไร และต่างจาก IEC 61131-3 ตรงไหน IEC 61499 เป็นมาตรฐานสากลที่พัฒนาต่อยอดจาก IEC 61131-3 (มาตรฐานภาษาโปรแกรม PLC ที่ใช้กันแพร่หลายที่สุดในปัจจุบัน) โดยยกระดับสมรรถนะขึ้นจาก "การควบคุมเชิงเหตุการณ์" ไปสู่ "การกระจายตัวของระบบ" (Distributed Automation) หัวใจสำคัญของ 61499 คือการทำให้ function block สามารถถูก "ย้าย" ข้ามอุปกรณ์ได้ โดยไม่ต้องเขียนโค้ดใหม่ แต่ในทางปฏิบัติ แนวคิดนี้เจออุปสรรคใหญ่: vendor lock-in ผู้ผลิต PLC รายใหญ่ของโลกจำนวนมากไม่ได้เปิดใช้ IEC 61499 เต็มรูปแบบ เพราะมันขัดกับผลประโยชน์ทางการค้าของพวกเขา — ถ้า logic ย้ายได้อิสระ ลูกค้าก็ย้ายผู้ขายได้อิสระเช่นกัน ผลคือ 20 ปีแรกของ 61499 เงียบเหงา จนกระทั่งยุค Industry 4.0 ที่ software-defined automation กลายเป็นจริง Ladder Diagram ภาษาคลาสสิกของ IEC 61131-3 ที่วิศวกรส่วนใหญ่ถนัด แต่ถูกออกแบบมาเพื่อเครื่องเดียว ไม่ใช่ระบบกระจายตัว (ภาพ: Wikimedia Commons) 3 แนวคิดหลักที่ทำให้ 61499 ต่างออกไป Event-Driven Execution Model — ใน 61131-3 คอนโทรลเลอร์รันแบบ scan cycle ตามรอบ (cyclic) ทั่วไป 1-10 ms ต่อรอบ ไม่ว่าข้อมูลจะเปลี่ยนหรือไม่ แต่ 61499 function block ทำงานเมื่อมี event เข้ามาเท่านั้น ทำให้ประหยัดทรัพยากร CPU และตอบสนองเฉพาะสิ่งที่เปลี่ยนแปลง Separation of Interface and Implementation —…
Read More
บทวิเคราะห์: Data Contract — สัญญาที่โรงงานยุค AI ต้องมี ก่อนที่ dashboard จะเบรกอีกครั้ง

บทวิเคราะห์: Data Contract — สัญญาที่โรงงานยุค AI ต้องมี ก่อนที่ dashboard จะเบรกอีกครั้ง

Article
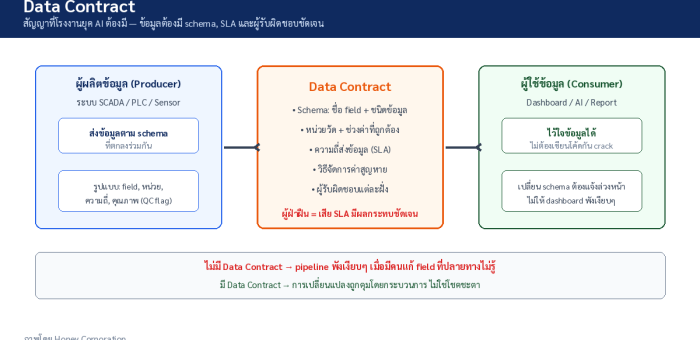
คำถามที่เราได้ยินบ่อยขึ้นเรื่อยๆ ในวงการโรงงานไทย ช่วงสองสามปีที่ผ่านมา ทีมงาน Honey Corporation ถูกถามคำถามแบบเดิมซ้ำๆ จากผู้บริหารโรงงานหลายแห่ง: “เราลงทุนเก็บข้อมูลจากเครื่องจักรมาทั้งที ทำไม dashboard ยังเบรก รายงานยังเพี้ยน และทีม AI ยังบ่นว่าข้อมูลใช้ไม่ได้?” คำตอบที่เราพบบ่อยที่สุดไม่ได้อยู่ที่เครื่องมือ แต่อยู่ที่ข้อเท็จจริงที่หลายองค์กรยังมองข้าม — โรงงานส่วนใหญ่ยังไม่มี “สัญญา” ว่าข้อมูลที่ส่งให้กันจะหน้าตาเป็นอย่างไร โรงงานยุคใหม่มีผู้ผลิตและผู้บริโภคข้อมูลมากขึ้นเรื่อยๆ — ปัญหาย้ายไปอยู่ที่ “คุณภาพการส่งมอบ” ไม่ใช่ปริมาณข้อมูล (ภาพ: Wikimedia Commons) Data Contract คืออะไร และทำไมกระแสมันมาเร็วในตอนนี้ Data Contract คือข้อตกลงที่เป็นทางการระหว่าง ผู้ผลิตข้อมูล (data producer — เช่น ทีมที่ดูแล IIoT gateway, ระบบ SCADA หรือ MES) กับ ผู้บริโภคข้อมูล (data consumer — เช่น ทีม dashboard, ทีม AI/ML, ฝ่ายบัญชี) ที่ระบุร่วมกันว่า คุณภาพ โครงสร้าง ความหมาย และความพร้อมใช้ของข้อมูลจะเป็นแบบไหน ต่างจากสัญญาธุรกิจทั่วไปตรงที่มัน เขียนด้วยโค้ด (YAML/JSON) จึงบังคับใช้ด้วยระบบอัตโนมัติได้จริง ไม่ต้องพึ่งความทรงจำของคน แนวคิดนี้ถูกเปรียบโดยนักวิเคราะห์หลายท่านว่ามีผลต่อวงการข้อมูล เทียบเท่ากับสิ่งที่ API ทำให้วงการพัฒนาซอฟต์แวร์ — API นิยามกติกาการสื่อสารระหว่างโปรแกรม ส่วน data contract นิยามกติกาการส่งมอบข้อมูลระหว่างทีม และเหมือนกันตรงที่พอมีตั้งแต่วันแรก ทุกอย่างที่หลังจากนี้จะเกิดขึ้นจะเร็วขึ้นทั้งระบบ ทำไมกระแสนี้มา “ตอนนี้” พอดี? คำตอบสั้นๆ คือ ผู้บริโภคข้อมูลในโรงงานเพิ่มขึ้นแบบทวีคูณ — จากเดิมที่มีแค่ SCADA กับ Historian ตอนนี้มี OEE dashboard, ระบบพยากรณ์การซ่อมบำรุง, โมเดล AI ตรวจคุณภาพ, ระบบรายงาน ESG และ application ใหม่ๆ ที่ไปขอข้อมูลจากทีม OT อยู่ตลอดเวลา ข้อมูลชุดเดิมถูก consume หลายทาง แต่ไม่มีใครรับประกันความเสถียรของมัน “คุณได้ข้อมูลที่ดีกว่าเข้าสู่ระบบ คุณจะได้ garbage in, garbage out ที่ดีกว่าเดิม” — Jean-Georges Perrin นักวิเคราะห์สถาปัตยกรรมข้อมูล อธิบายว่าทำไม data contract จึงเป็นเรื่องพื้นฐานของงาน AI ยุคใหม่…
Read More
Case Study: จากสายพานพลาสติกที่พังกลางดึก สู่ Blockchain Traceability ที่ช่วยเรียกคืนสินค้าเฉพาะจุดใน 2 ชั่วโมง

Case Study: จากสายพานพลาสติกที่พังกลางดึก สู่ Blockchain Traceability ที่ช่วยเรียกคืนสินค้าเฉพาะจุดใน 2 ชั่วโมง

Article
03:40 น. — สายพานลำเลียงหยุด และคำถามที่ตอบไม่ได้ กรณีศึกษาสังเคราะห์นี้ยึดตามรูปแบบปัญหาที่พบซ้ำๆ ในโรงงานอาหารแปรรูปขนาดกลางแห่งหนึ่งในภาคตะวันออก ซึ่งส่งออกผลิตภัณฑ์แช่แข็งให้แบรนด์ใหญ่ในต่างประเทศ คืนวันนั้นสายพานพลาสติก (modular belt) ของตู้แช่แข็ง IQF ราวกลางสายการผลิตหักพับลงกลางดึก เจ้าหน้าที่เปลี่ยนสายพานใหม่และเดินสายการผลิตต่อภายใน 40 นาที ปัญหาไม่ได้อยู่ที่เวลาหยุด — แต่อยู่ที่ว่าเช้าวันรุ่งขึ้น ทีม quality ตอบคำถามแบรนด์เจ้าของไม่ได้ว่า "ช่วง 40 นาทีที่สายพานเก่าแตะสินค้าก่อนหัก มีผลิตภัณฑ์กี่กล่อง และกล่องไหนบ้างที่ต้องกักตัวเพื่อตรวจโลหะหรือเศษพลาสติก" ในระบบกระดาษและ spreadsheet ยุคเก่า คำตอบคือ "ต้องเรียกคืนทั้งล็อตการผลิต 8 ชั่วโมง" — กว่า 12,000 กล่อง เพราะไม่มีทางพิสูจน์ได้ว่ากล่องไหนปลอดภัย นี่คือจุดที่ทุกโรงงานเริ่มตระหนักว่าปัญหา traceability ไม่ใช่เรื่อง "ระบบ IT สวยงาม" แต่คือเรื่องการเงินและชื่อเสียงโดยตรง ปัญหาราก: ข้อมูลอยู่คนละที่ ในคนละภาษา เมื่อทีมงานเข้าไปประเมิน พบภาพเดิมที่คุ้นเคยในโรงงานไทยจำนวนมาก: เครื่องสแกนบาร์โค้ด 14 จุด ส่งข้อมูลเข้าไฟล์ CSV แยกตามจุด ไม่มีการ standardize ข้อมูลการผลิตล็อต (batch record) อยู่ในระบบ MES เก่า ที่ต้อง export ผ่านหน้าจอ เนื่องจากไม่มี API สถานะอุณหภูมิตู้แช่อยู่ในที่เดียวกับข้อมูลพลังงาน ไม่เคยถูกผูกกับล็อตการผลิต ผู้ขนส่งเก็บ GPS และอุณหภูมิระหว่างขนส่งในระบบของตัวเอง เข้าถึงได้เฉพาะผ่านเว็บพอร์ทัล ความท้าทายคือทั้งหมดนี้ต้องกลายเป็น "เรื่องเล่าเดียว" ที่ย้อนได้ทั้งเส้นทาง — จากวัตถุดิบถึงหน้าร้าน — ภายในไม่กี่นาที ไม่ใช่ไม่กี่วัน ทางออก: EPCIS เป็นกระดูกสันหลัง + Blockchain เป็น notary ข้ามองค์กร สถาปัตยกรรมที่เลือกใช้แบ่งเป็น 3 ชั้นตามหน้าที่ ไม่ใช่ตามฮิต: โครงสร้าง Merkle Tree — กลไก cryptographic ที่ blockchain ใช้ตรวจสอบความถูกต้องของข้อมูลทั้งก้อนจาก hash รากเพียงค่าเดียว (ภาพ: Wikimedia Commons) ชั้นเก็บเหตุการณ์ (EPCIS layer) — ทุกจุดสแกนและเหตุการณ์สำคัญถูกแปลงเป็น EPCIS event มาตรฐาน GS1: Object Event เมื่อกล่องผ่านจุดสแกน, Aggregation Event เมื่อกล่องใส่พาเลท, Transformation Event เมื่อวัตถุดิบกลายเป็นล็อตผลิตภัณฑ์ และ…
Read More
Digital Product Passport: บัตรประจำตัวดิจิทัลของผลิตภัณฑ์ และห้วงเวลาเตรียมตัวของโรงงานไทย

Digital Product Passport: บัตรประจำตัวดิจิทัลของผลิตภัณฑ์ และห้วงเวลาเตรียมตัวของโรงงานไทย

Article
ยุคที่ข้อมูลผลิตภัณฑ์อยู่แค่บนฉลากกระดาษกำลังจะจบลง ภายใต้ Ecodesign for Sustainable Products Regulation (ESPR) หรือ Regulation (EU) 2024/1781 ซึ่งมีผลบังคับใช้ตั้งแต่ 18 กรกฎาคม 2024 สหภาพยุโรปกำลังผลักดันให้ผลิตภัณฑ์ที่จำหน่ายในตลาด EU มี Digital Product Passport (DPP) — บัตรประจำตัวดิจิทัลที่เก็บข้อมูลตั้งแต่องค์ประกอบวัสดุ แหล่งที่มา สัดส่วนวัสดุรีไซเคิล ไปจนถึงแผนผังห่วงโซ่อุปทาน โดยเข้าถึงผ่าน QR Code แท็ก RFID หรือเทคโนโลยีที่สแกนได้อื่นๆ คณะกรรมาธิการยุโรประบุว่า ESPR คือ "รากฐาน" ของแนวทางที่ทำให้ผลิตภัณฑ์ยั่งยืนและหมุนเวียนมากขึ้น และในเดือนเมษายน 2025 ได้ประกาศ Working Plan ฉบับแรกที่ระบุกลุ่มผลิตภัณฑ์ที่จะถูกกำหนดกติกาก่อน โดยงานเตรียมสำหรับ สิ่งทอและเหล็กกล้า เริ่มไปแล้ว สำหรับประเทศไทยซึ่งเป็นฐานผลิตสิ่งทอ เหล็ก อิเล็กทรอนิกส์ และยานยนต์ที่ส่งออกไป EU กฎระเบียบนี้จะส่งผลกระทบเชิงระบบต่อวิธีที่โรงงานเก็บและส่งต่อข้อมูล แท็ก RFID ฝังในป้ายผลิตภัณฑ์ — หนึ่งในพาหะที่ ESPR ระบุสำหรับ Digital Product Passport (ภาพ: Wikimedia Commons) DPP เปลี่ยนอะไรในโรงงาน หลายคนคิดว่า DPP คือ "ฉลากที่ฉลาดขึ้น" แต่มองให้ลึกกว่านั้น: DPP คือการบังคับให้ข้อมูลที่เคยอยู่ในซิโลภายใน (ใบสั่งผลิต ใบ COA สเปกวัสดุ ประวัติการตรวจสอบ) ต้องถูกโครงสร้างใหม่ให้เป็น ข้อมูลที่ค้นได้ตลอดห่วงโซ่อุปทาน เมื่อลูกค้า EU สแกน QR บนเสื้อผ้าหรือแผ่นเหล็ก เบื้องหลังคือระบบข้อมูลที่ไล่ย้อนได้จากผลิตภัณฑ์สุดท้าย ไปยังโรงเอาท์ซอร์ส โรงย้อม โรงปั่นด้าย จนถึงผู้ผลิตเส้นใย นี่คือจุดที่โรงงานไทยส่วนใหญ่ยังมีช่องว่าง เพราะข้อมูลที่ว่านี้กระจายอยู่ในกระดาษ ไฟล์ Excel แยกกัน และระบบ ERP/MES เก่าที่ไม่ได้ออกแบบให้แลกเปลี่ยนข้อมูลกับภายนอก การจะทำ DPP ได้จริง โรงงานต้องมีรากฐาน 3 ชั้น: การระบุตัวตนผลิตภัณฑ์รายชิ้น (Item-Level Identification) การเก็บเหตุการณ์การผลิตเป็นทางการ (Event Data ตามมาตรฐาน EPCIS) และการเชื่อมต่อข้อมูลกับคู่ค้า (Interoperability) บทวิเคราะห์: โอกาสซ่อนอยู่ในภาระผูกพัน มองเชิงกลยุทธ์ DPP ไม่ได้เป็นแค่ภาระ Compliance แต่เป็นแรงกดดันที่บังคับให้โรงงานสร้าง Data Infrastructure ที่แท้จริง โรงงานที่ตอบสนองเร็วจะได้ 3 สิ่ง:…
Read More
บทวิเคราะห์: Uncertainty Quantification — ทำไม Digital Twin ที่ดีต้องบอกว่า “ตัวเลขนี้เชื่อได้แค่ไหน”

บทวิเคราะห์: Uncertainty Quantification — ทำไม Digital Twin ที่ดีต้องบอกว่า “ตัวเลขนี้เชื่อได้แค่ไหน”

Article
เมื่อดิจิทัลทวินบอกว่า "อุณหภูมิจะเป็น 78°C ใน 30 นาที" — คุณควรเชื่อแค่ไหน? ค่าทำนายที่แม่นยำดูเหมือนของดี แต่ในโลกอุตสาหกรรม ตัวเลขเดียวที่ไม่บอกความมั่นใจคือข้อมูลครึ่งๆ กลางๆ ลองนึกภาพสองระบบ: ระบบ A ทำนายอุณหภูมิ 78°C, ระบบ B ทำนาย 78°C ± 6°C พร้อมช่วงความเชื่อมั่น 95% — ทั้งคู่ให้ตัวเลขกลางเดียวกัน แต่การนำไปใช้ตัดสินใจหยุดสายการผลิตหรือไม่ต่างกันคนละเรื่อง นี่คือเหตุผลที่ Uncertainty Quantification (UQ) กำลังกลายเป็นเกณฑ์ใหม่ของดิจิทัลทวินระดับมืออาชีพ ผลลัพธ์การจำลองเชิงตัวเลข ( finite element simulation) — เมื่อพารามิเตอร์ตั้งต้นไม่แน่นอน ผลลัพธ์ที่ได้ก็เป็นการกระจาย ไม่ใช่ค่าเดียว (ที่มา: Wikimedia Commons, CC BY-SA 3.0) ทำไมตัวเลขเดียวจึงไม่พออีกต่อไป รายงานฉบับสำคัญ Foundational Research Gaps and Future Directions for Digital Twins ของ National Academies of Sciences, Engineering, and Medicine (สหรัฐฯ, 2024) ระบุชัดเจนว่า uncertainty quantification ต้องเป็นส่วนหนึ่งของการออกแบบดิจิทัลทวินตั้งแต่ต้น ไม่ใช่ของตกแต่งท้ายโครงการ เพราะความไม่แน่นอนในระบบ twin มีหลายชั้นมากกว่าที่คิด: ชนิดความไม่แน่นอน ต้นกำเนิด ตัวอย่างในโรงงาน Aleatoric ความสุ่มตามธรรมชาติของกระบวนการ ความแปรปรวนของวัตถุดิบแต่ละล็อต, ความผันแปรของอุณหภูมิแวดล้อม Epistemic ความรู้ที่ยังไม่ครบถ้วน สัมประสิทธิ์สึกหรอที่ยังวัดไม่ได้, พฤติกรรมเครื่องจักรที่ยังไม่เคยเจอในข้อมูล Model การทำให้เป็นโมเดล (assumptions, สมการอย่างง่าย) สมการถ่ายเทความร้อนที่ตัดรายละเอียดมุมตายของหม้อต้มออก Numerical ข้อจำกัดของการคำนวณ ขนาด mesh ที่หยาบเกินไปเพื่อให้คำนวณทันเวลาจริง Data / Sensor ความคลาดเคลื่อนของการวัด เซ็นเซอร์อุณหภูมิความแม่นยำ ±0.5°C, ค่า drift หลังใช้งาน, สัญญาณรบกวน ประเด็นสำคัญที่มักถูกมองข้าม: สองชนิดแรกต้องจัดการคนละวิธี Aleatoric เป็นธรรมชาติของกระบวนการ ลดไม่ได้แต่บรรยายได้ด้วยการกระจายความน่าจะเป็น ส่วน Epistemic ลดได้ด้วยการเก็บข้อมูลเพิ่มหรือทดลองเพิ่ม — การแยกแยะให้ออกว่า error ที่เห็นมาจากไหน จึงกำหนดว่าควรลงทุนซื้อเซ็นเซอร์แม่นขึ้น (แก้ data) หรือปรับโมเดล (แก้ model) หรือทั้งคู่ เครื่องมือหลักของ UQ ในงานอุตสาหกรรม…
Read More
บทวิเคราะห์ Hybrid Cloud ในโรงงานอุตสาหกรรม 2026: งานไหนควรอยู่ On-premise งานไหนควรขึ้นคลาวด์

บทวิเคราะห์ Hybrid Cloud ในโรงงานอุตสาหกรรม 2026: งานไหนควรอยู่ On-premise งานไหนควรขึ้นคลาวด์

Article
คำถามที่ฝ่าย IT ของโรงงานไทยถามกันบ่อยที่สุดในปี 2026 ไม่ใช่ "ควรขึ้นคลาวด์ไหม" อีกต่อไป แต่คือ "งานไหนควรอยู่ที่ไหน" เมื่อระบบ SCADA, MES และ data platform ต้องทำงานร่วมกันทั้งบน on-premise และคลาวด์ คำตอบที่กำลังได้รับความนิยมคือ Hybrid Cloud — สถาปัตยกรรมที่ไม่เลือกข้าง แต่จัดวาง workload ตามลักษณะของงาน บทความนี้วิเคราะห์มุมมองของเราที่ Honey Corporation จากประสบการณ์ทำ System Integration ในภาคอุตสาหกรรมไทย ว่าเส้นแบ่งระหว่าง on-premise กับคลาวด์ควรอยู่ตรงไหนจึงจะได้ประโยชน์สูงสุดโดยไม่สร้างความเสี่ยงใหม่ เซิร์ฟเวอร์ในโรงงาน (on-premise) ยังคงเป็นที่พำนักของระบบ real-time control และข้อมูลดิบ — ขณะที่คลาวด์รับงานวิเคราะห์ระยะยาว (ภาพ: Wikimedia Commons) ทำไม "All-in Cloud" และ "All-in On-premise" ต่างก็ไม่ใช่คำตอบ ฝ่ายที่ผลักดัน all-in cloud มักอ้างเรื่องความยืดหยุ่น ไม่ต้องลงทุน hardware ล่วงหน้า และเข้าถึงบริการ AI ได้ทันที แต่ในบริบทโรงงาน มีสามข้อจำกัดที่ยังแก้ไม่ตก: Latency และ dependency — ระบบควบคุมกระบวนการผลิตต้องทำงานต่อแม้อินเทอร์เน็ตขาด การพึ่งพาคลาวด์ 100% ในงาน critical loop คือความเสี่ยงที่ยอมรับไม่ได้ ปริมาณข้อมูลดิบ — เซ็นเซอร์หลายพันจุดสร้างข้อมูลดิบมหาศาล การเก็บทั้งหมดบนคลาวด์เป็นการใช้ทรัพยากรอย่างสิ้นเปลือง ทั้งยังมีค่าใช้จ่าย egress เมื่อต้องดึงกลับมาวิเคราะห์ ข้อกำหนดด้านข้อมูล — ลูกค้าบางรายหรือกฎหมายบางประเทศกำหนดว่าข้อมูลกระบวนการผลิตบางประเภทห้ามออกนอกประเทศ ในทางกลับกัน all-in on-premise ก็แพ้ในเกมระยะยาว: ทีมงานจำกัด การขยายระบบช้า และการเข้าถึงเครื่องมือ AI/ML สมัยใหม่ที่คลาวด์พัฒนาออกมาตลอดเวลา ทำได้ลำบากกว่ามาก เส้นแบ่งที่เราใช้: วาง workload ตาม 4 คำถาม จากประสบการณ์ติดตั้งระบบให้โรงงานหลายแห่ง เราสรุปกรอบการตัดสินใจ 4 คำถาม ก่อนวาง workload ใดๆ ลงที่ไหน: Workload ความเร็วที่ต้องการ ลักษณะข้อมูล ที่วางที่เหมาะสม Real-time control / interlockมิลลิวินาทีข้อมูลดิบหมุนเร็วOn-premise (PLC/DCS) Line dashboard / Andonวินาทีข้อมูลรวมระดับสายผลิตOn-premise edge server OEE, production reportนาที–ชั่วโมงข้อมูลสรุปรายวัน/รายสัปดาห์Cloud ML…
Read More
Global Lighthouse Network 2026: ถอดรหัส 223 โรงงานระดับโลก และ Scaling Archetypes ที่โรงงานไทยควรยืมใช้

Global Lighthouse Network 2026: ถอดรหัส 223 โรงงานระดับโลก และ Scaling Archetypes ที่โรงงานไทยควรยืมใช้

Article
223 ประภาคาร 30 ประเทศ และบทเรียนที่โรงงานไทยหยิบไปใช้ได้ ตลอด 8 ปีที่ผ่านมา เครือข่าย Global Lighthouse Network ของ World Economic Forum ทำหน้าที่เหมือน "ห้องทดลองกลางแจ้ง" ของการผลิตโลก — คัดเลือกโรงงานที่พิสูจน์แล้วว่าใช้เทคโนโลยีปฏิวัติอุตสาหกรรม (4IR) สร้างผลลัพธ์ที่วัดได้จริง ไม่ใช่แค่ทำ PoC เก็บไว้โชว์ รายงานฉบับล่าสุด (มกราคม 2026) เผยตัวเลขที่สะท้อนทิศทางของอุตสาหกรรมชัดเจนกว่าที่เคย นั่นคือเครือข่ายเติบโตจาก 16 โรงงานแรก เป็น 223 ไซต์ในกว่า 30 ประเทศ 40 อุตสาหกรรม และหนึ่งในนั้นอยู่ที่ศรีราชา ประเทศไทย ประเด็นที่น่าสนใจที่สุดของรายงานปีนี้ไม่ใช่จำนวนโรงงาน แต่คือ สัดส่วนของ AI ในโซลูชันที่ทำงานจริง: AI เชิงวิเคราะห์และ Machine Learning ถูกฝังอยู่ในเกือบ 62% ของ use case หลัก ขณะที่ Generative AI โตจาก 9% ในปี 2024 เป็น 23% ในปี 2025 และ AI Agent เพิ่งเริ่มต้นที่ 5% — ตัวเลขชุดนี้บอกว่าเรากำลังเปลี่ยนผ่านจาก "โรงงานอัจฉริยะ" ที่รวบรวมข้อมูล ไปสู่ "โรงงานอัจฉริยะเชิงปัญญา" (Cognitive Factory) ที่เรียนรู้และปรับตัวเอง สายการผลิตยุคใหม่ — พื้นที่ทดลองจริงของ 4IR ที่ Lighthouse ทั่วโลกพิสูจน์ผลลัพธ์ (ภาพ: Wikimedia Commons) จาก Pilot Purgatory สู่ Scaling Slump — และทางออก 3 Archetype รายงานชี้ว่าปัญหาของธุรกิจการผลิตส่วนใหญ่ไม่ได้อยู่ที่การเริ่มต้น แต่อยู่ที่การขยายผล หลายโรงงานติดอยู่ใน "Pilot Purgatory" คือทำนำร่องได้แต่ขยายไม่ได้ และเมื่อผ่านจุดนั้นไปได้ก็เจอกับ "Scaling Slump" ระยะที่โซลูชันขยายแล้วผลลัพธ์กลับเพิ่มช้าลงไม่เป็นสัดส่วนกับการลงทุน รายงานแก้ปัญหานี้ด้วยการระบุ 3 รูปแบบของผู้สำเร็จ (Scaling Archetypes): Archetype กลยุทธ์หลัก เหมาะกับใคร 1. Centre of Excellenceรวมผู้เชี่ยวชาญไว้ที่ส่วนกลาง สร้างแพลตฟอร์มร่วมและ playbook แล้วเป็นตัวขับเคลื่อนให้ทุกโรงงานในเครือเครือบริษัทหลายไซต์ มีงบดิจิทัลระดับกลาง 2. Workforce…
Read More

Industrial Metaverse ในโรงงานอุตสาหกรรม: เมื่อโลกเสมือนและโลกแห่งความจริงกลายเป็นหนึ่งเดียว

Article
ในปี 2026 คำว่า "Industrial Metaverse" ไม่ใช่แค่คำโฆษณาชวกเชื่อจากวงการเทคโนโลยีอีกต่อไป แต่เป็นแนวคิดที่กำลังเปลี่ยนวิธีที่โรงงานออกแบบ จำลอง และควบคุมการผลิต บริษัทวิเคราะห์อุตสาหกรรมหลายแห่งคาดการณ์ว่าตลาด Industrial Metaverse จะแตะ 100 พันล้านดอลลาร์สหรัฐภายในปี 2030 โดยภาคการผลิตครองสัดส่วนใหญ่ Industrial Metaverse คือการผสานระหว่าง Digital Twin, Extended Reality (XR), AI, และ IoT ให้กลายเป็นสภาพแวดล้อมเสมือนที่สะท้อนโรงงานจริงแบบเรียลไทม์ ทีมวิศวกรสามารถ "เดิน" เข้าไปในโรงงานเสมือน สังเกตเครื่องจักรทำงาน ทดสอบสถานการณ์สมมติ (What-If Analysis) และตัดสินใจได้โดยไม่ต้องหยุดสายการผลิตจริง สถาปัตยกรรมของ Industrial Metaverse มีอะไรบ้าง? Industrial Metaverse ไม่ใช่เทคโนโลยีเดียว แต่เป็น Stack ของเทคโนโลยี 5 ชั้น ที่ทำงานร่วมกัน: ชั้นเทคโนโลยี หน้าที่ เทคโนโลยีหลัก Latency ที่ต้องการ 1. Physical Layer เครื่องจักร เซ็นเซอร์ และอุปกรณ์จริงในโรงงาน IIoT Sensors, PLC, SCADA N/A (ข้อมูลดิบ) 2. Data Layer รวบรวมและประมวลผลข้อมูลจากเซ็นเซอร์ Edge Gateway, Time-Series DB, OPC UA 1–10 ms 3. Digital Twin Layer สร้างแบบจำลองเสมือนของสินทรัพย์และกระบวนการ Asset Twin, Process Twin, System Twin 10–100 ms 4. Intelligence Layer AI วิเคราะห์และเพิ่มประสิทธิภาพ Machine Learning, Physics-Based Simulation 100 ms – 1s 5. Experience Layer อินเทอร์เฟซให้มนุษย์โต้ตอบกับโลกเสมือน AR/VR/MR Headset, 3D Visualization < 20 ms (Motion-to-Photon) ภาพประกอบ: โครงสร้างพื้นฐานของ Industrial Metaverse เชื่อมต่อข้อมูลจากเซ็นเซอร์ IIoT ผ่าน Edge Computing สู่ Digital Twin และแสดงผลใน…
Read More