บทวิเคราะห์ Motor Current Signature Analysis (MCSA): เมื่อมอเตอร์คือเซ็นเซอร์ของตัวเอง — Pole Pass Frequency และ Sideband dB

บทวิเคราะห์ Motor Current Signature Analysis (MCSA): เมื่อมอเตอร์คือเซ็นเซอร์ของตัวเอง — Pole Pass Frequency และ Sideband dB

Article
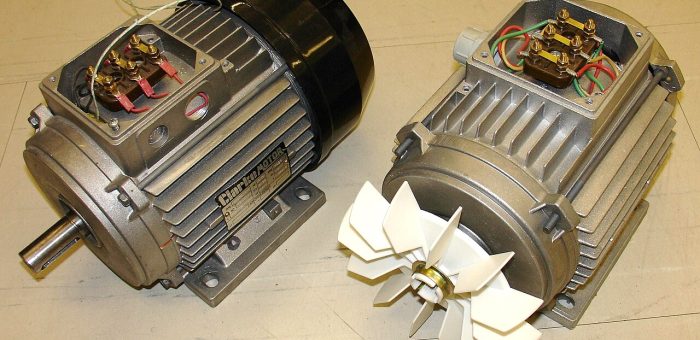
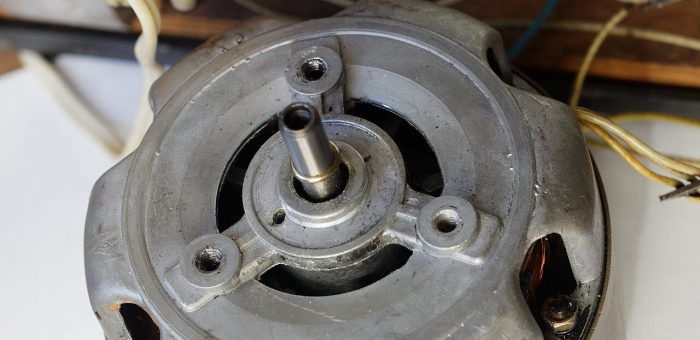
บทวิเคราะห์: ทำไมสัญญาณที่ "พร้อมใช้" ที่สุดในโรงงาน กลับถูกมองข้ามมานานที่สุด ในโลกของ Condition Monitoring เราคุ้นเคยกับการติดเซ็นเซอร์วัดการสั่นสะเทือนบนตัวมอเตอร์ ติดเทอร์มอคัปเปิลวัดอุณหภูมิ หรือส่งน้ำมันเข้าห้องแล็บ แต่มีสัญญาณหนึ่งที่พร้อมใช้งานอยู่แล้วในทุกมอเตอร์ไฟฟ้า โดยไม่ต้องติดอะไรเพิ่มเลย — กระแสไฟฟ้าที่ไหลเข้าสู่ขดลวดสเตเตอร์ นี่คือจุดเริ่มต้นของเทคนิคที่ชื่อว่า Motor Current Signature Analysis (MCSA) หลักการง่ายๆ คือแรงบิดของมอเตอร์เหนี่ยวนำสัมพันธ์โดยตรงกับกระแสโรเตอร์ เมื่อชิ้นส่วนกลไกภายในเริ่มผิดปกติ ไม่ว่าจะเป็นแท่งนำของโรเตอร์หลุด ความไม่สมดุลของช่องอากาศ (Airgap Eccentricity) หรือแม้แต่โหลดกลไกที่กระตุก เฟร์ชชูเรชันของความเร็วรอบนั้นจะถูกสะท้อนกลับมาปรากฏเป็น Sideband รอบๆ ความถี่ไฟฟ้าในสเปกตรัมของกระแส นั่นคือเหตุผลที่นักวิเคราะห์บอกว่า "มอเตอร์คือเซ็นเซอร์ของตัวเอง" ขดลวดสเตเตอร์ — จุดที่สัญญาณกลไกทั้งหมดของมอเตอร์และโหลดถูก "มอดูเลต" ลงบนกระแสไฟฟ้า กลายเป็นข้อมูลวินิจฉัยที่เข้าถึงได้จากหน้าปัดเดียว | ภาพ: public domain คณิตศาสตร์ที่โรงงานควรรู้: Pole Pass Frequency สูตรสำคัญที่สุดของ MCSA คือการหา Pole Pass Frequency (PPF) ซึ่งกำหนดโดย: Slip (s) = (Ns - Nr) / Ns # Ns = synchronous speed, Nr = rated speed PPF = Slip × P × f_line # P = number of pole pairs Sideband = f_line ± n x PPF # n = 1, 2, 3, ... ตัวอย่างเชิงตัวเลข: มอเตอร์ 4 โพล (2 pole pairs) ความถี่ไฟฟ้า 50 Hz ความเร็วพร้อมนามมาตรฐาน 1,470 rpm จะมี Synchronous Speed 1,500 rpm คำนวณ Slip = 2% ดังนั้น PPF = 0.02 × 2…
Read More
Case Study: Oil Analysis กับระบบไฮดรอลิคที่ ISO 4406 เกินเกณฑ์ — จาก 21/19/16 สู่ 17/15/12 ใน 6 เดือน

Case Study: Oil Analysis กับระบบไฮดรอลิคที่ ISO 4406 เกินเกณฑ์ — จาก 21/19/16 สู่ 17/15/12 ใน 6 เดือน

Article
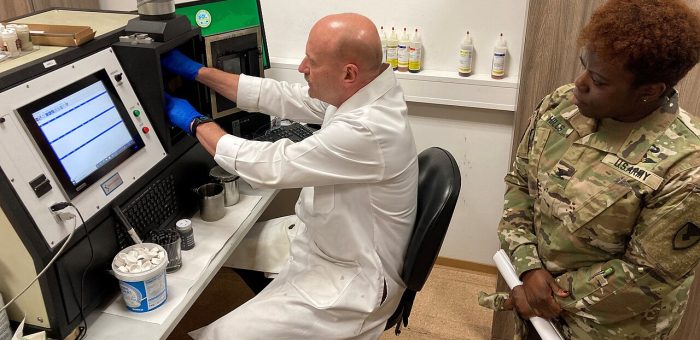
บทนำ: เมื่อ "เดือนดาว" เริ่มจากขวดน้ำมันเพียงขวดเดียว โรงงานผลิตชิ้นส่วนยนต์แห่งหนึ่งใน ระยะคุมภัย 1 ปี พบว่าเครื่องจักรไฮดรอลิคหยุดกะทันหันบ่อยครั้งขึ้นเรื่อยๆ จนกระทั่งช่างเทคนิคเริ่มชินกับคำว่า "อีกแล้ว" ทุกครั้งที่ไฟสัญญาณเตือนเครื่องตัดกำลังบนเครื่อง Press ขนาดใหญ่กะพริบ ฝ่ายบำรุงรักษาใช้แนวทาง Run-to-Failure มาตลอด เพราะ "เครื่องอื่นก็เป็นแบบนี้" และการหยุดเพื่อตรวจสภาพถือเป็นการรบกวนสายการผลิต จุดเปลี่ยนมาถึงเมื่อทีมวิศวกรเสนอแผนนำร่องที่แทบไม่ต้องลงทุนอะไรเลย: เก็บตัวอย่างน้ำมันส่งตรวจแล็บ ตามรอบเวลาที่กำหนด และติดตามผลเป็นตัวเลข ไม่ใช่ความรู้สึก ห้องแล็บวิเคราะห์น้ำมันอุตสาหกรรม — ผลวิเคราะห์จากที่นี่คือ "ผลตรวจเลือด" ของเครื่องจักร ที่บอกทั้งสุขภาพน้ำมันและสุขภาพชิ้นส่วนภายใน | ภาพ: U.S. Army, public domain ปัญหา: ทำไมการเปลี่ยนน้ำมันตามเวลาจึงไม่พอ โรงงานส่วนใหญ่เปลี่ยนน้ำมันตามรอบเวลา (Time-Based) เช่น ทุก 4,000 ชั่วโมงการทำงาน ซึ่งเป็นวิธีที่ง่ายและถูกต้องตามคู่มือ แต่มีข้อจำกัดสองด้าน ด้านแรกคือน้ำมันที่ยังใช้งานได้ดีถูกทิ้งก่อนวัยอันควร ด้านที่สองและอันตรายกว่าคือน้ำมันที่ "เสียก่อนเวลา" จากการปนเปื้อนน้ำ ความร้อนสูง หรืออนุภาคโลหะ ไม่ได้ถูกพบจนกว่าความเสียหายจะเกิดขึ้นแล้ว ในกรณีของโรงงานชิ้นส่วนยนต์นี้ ผลวิเคราะห์รอบแรกจากเครื่อง Press ตัวหลักพบค่าความสะอาดตามมาตรฐาน ISO 4406 อยู่ที่ 21/19/16 ในขณะที่ค่าเป้าหมายของระบบไฮดรอลิคแรงดันสูงควรอยู่ที่ 18/16/13 หรือดีกว่า ตัวเลขสามชั้นนี้แทนจำนวนอนุภาคต่อมิลลิลิตร ที่ขนาดมากกว่า 4 ไมครอน, 6 ไมครอน และ 14 ไมครอนตามลำดับ — โดยแต่ละเลขคือลอการิทึมของจำนวนอนุภาค (เลขเพิ่ม 1 = อนุภาคเพิ่มประมาณ 2 เท่า) น้ำมันไฮดรอลิค — ตัวกลางถ่ายทอดพลังงานที่ต้องการ "ความสะอาด" มากกว่าที่หลายโรงงานคิด เพราะอนุภาคแข็งขนาด 1–5 ไมครอนเข้าไปเกาะในช่องว่างภายในวาล์ว | ภาพ: public domain ทางแก้: โปรแกรม Oil Analysis 4 ขั้นตอน ทีมวิศวกรร่วมกับห้องแล็บออกแบบโปรแกรมตรวจสอบน้ำมันเชิงรุก 4 ขั้นตอน: จัดทำรายการเครื่องจักรและ Baseline — เก็บตัวอย่างน้ำมันจากทุกถังสำคัญ พร้อมระบุจุดเก็บตัวอย่างมาตรฐานให้ช่างทุกคนใช้จุดเดียวกันเพื่อความเปรียบเทียบได้ กำหนดเกณฑ์เป้าหมาย (Target Cleanliness) — ระบบไฮดรอลิคแรงดันสูงกำหนดที่ 18/16/13, Gearbox ที่ 17/15/12, น้ำมันหล่อลื่นแบริ่งที่ 16/14/11 เก็บตัวอย่างตามรอบสม่ำเสมอ — เครื่องวิกฤตทุกเดือน, เครื่องสำคัญทุก 3 เดือน โดยเก็บขณะเครื่องกำลังทำงานหรือหลังหยุดไม่เกิน 15 นาที ปฏิบัติตามผล (Act…
Read More
Vibration Analysis: อ่านลายเซ็นความถี่จากเครื่องจักรก่อนที่มันจะพัง — Deep Dive จาก FFT ถึง ISO 20816

Vibration Analysis: อ่านลายเซ็นความถี่จากเครื่องจักรก่อนที่มันจะพัง — Deep Dive จาก FFT ถึง ISO 20816

Article
ทำไม "เสียงเครื่องจักร" จึงโกหกคุณได้ แต่ "ค่าการสั่นสะเทือน" โกหกไม่ได้ ช่างเทคนิคที่เก่งที่สุดในโรงงานมักบอกได้ว่าเครื่องจักรกำลังจะพัง "จากเสียง" — แต่หูมนุษย์มีข้อจำกัดสองข้อที่ยอมรับกันในวงวิศวกรรมเครื่องกล ข้อแรกคือหูคนได้ยินตั้งแต่ 20 Hz ถึงราว 20,000 Hz ในขณะที่สัญญาณบ่งชี้ความเสียหายระยะแรกของลูกสูบมักเกิดที่ความถี่ต่ำกว่านั้น ข้อสองคือสมองมนุษย์ "ชิน" กับเสียงที่เพิ่มขึ้นอย่างค่อยเป็นค่อยไปในแต่ละวัน จนกระทั่งวันหนึ่งเครื่องหยุดกลางคัน Vibration Analysis คือการเปลี่ยนสัญญาณการสั่นสะเทือนให้กลายเป็นตัวเลขที่วัดได้ ตรวจสอบซ้ำได้ และเปรียบเทียบข้ามเวลาได้ ด้วยหลักการง่ายๆ ว่า ทุกความผิดปกติเชิงกล มีลายเซ็นความถี่เป็นของตัวเอง ลูกสูบ (Rolling Element Bearing) — แหล่งกำเนิดความถี่บกพร่องที่นำไปคำนวณเป็น BPFO, BPFI, BSF และ FTF ได้ | ภาพ: public domain หลักการ 4 ขั้น: จากคลื่นสั่นสะเทือนสู่การวินิจฉัย ขั้นตอนการวิเคราะห์มาตรฐานในอุตสาหกรรมคือ (1) เก็บสัญญาณด้วยเซ็นเซอร์วัดความเร่ง (Accelerometer) ที่ติดตั้งบนตัวเครื่องจักรใกล้จุดรับน้ำหนัก (2) แปลงสัญญาณแรงดันไฟฟ้าให้เป็นหน่วยความเร่ง g ผ่านตัวเก็บประจุภายในเซ็นเซอร์แบบ Piezoelectric (3) นำข้อมูลดิบผ่านการแปลงฟูเรียร์ (FFT) เพื่อแยกสัญญาณออกเป็นแต่ละความถี่ และ (4) ตีความความถี่ที่โดดออกมาเทียบกับความถี่บกพร่องทางทฤษฎีของเครื่องจักร เซ็นเซอร์ 100 mV/g เป็นสเปกที่พบมากที่สุดในโรงงานอุตสาหกรรม ส่วนความถี่ในการเก็บข้อมูล (Sampling Rate) ต้องเป็นอย่างน้อย 2.56 เท่าของความถี่สูงสุดที่สนใจตามทฤษฎีบทของไนควิสต์ เช่น ต้องการวิเคราะห์ถึง 10 kHz ต้องเก็บข้อมูลที่ 25.6 kHz การติดตั้งเซ็นเซอร์วัดค่าที่จุดสำคัญ ตำแหน่งและวิธีติดตั้ง (แม่เหล็ก/สติ๊ก/ยึดสกรู) มีผลต่อความถี่สูงสุดที่วัดได้จริง | ภาพ: NASA, public domain ตารางลายเซ็นความถี่: อ่านตัวโรคเครื่องจักรให้เป็น ความถี่ที่พบ สาเหตุที่พบบ่อย สิ่งที่ควรตรวจสอบต่อ 1×RPMความไม่สมดุล (Unbalance)น้ำหนักเพิ่มจากเศษวัสดุหรือฝุ่นเป็นก้อนบนใบพัด หรือโรเตอร์โค้งงอ โดยเฟสของสัญญาณจะนิ่งไม่เปลี่ยน 2×RPMเพลาไม่ได้แนว (Misalignment)ตรวจการจัดแนวเพลาด้วยเลเซอร์ ทั้งแนวออฟเซ็ตและแนวมุม BPFO / BPFIลูกสูบเสียหาย (แหวนนอก/ใน)โดยเฉพาะเมื่อมี Sideband ของ FTF ปรากฏร่วมด้วย หมายถึงการสึกหรอลุกลาม ราว 0.42–0.48×RPMฟิล์มน้ำมันไม่เสถียร (Oil Whirl)ตรวจระดับความหนืดน้ำมัน แรงดันน้ำมันหล่อลื่น และ Load ของ Sleeve Bearing — มักพบในเครื่องจักรความเร็วสูง ความถี่ลูกผสม (Line Frequency ×…
Read More
Human Digital Twin: เมื่อสิ่งที่ถูกลืมมากที่สุดในโรงงานอัจฉริยะคือ “คน” — บทวิเคราะห์แนวคิดและโอกาสปี 2026

Human Digital Twin: เมื่อสิ่งที่ถูกลืมมากที่สุดในโรงงานอัจฉริยะคือ “คน” — บทวิเคราะห์แนวคิดและโอกาสปี 2026

Article
เมื่อพูดถึง Digital Twin ในโรงงาน ภาพที่ผุดขึ้นมาเกือบทุกครั้งคือเครื่องจักร ท่อ และสายพานที่ถูกจำลองเป็นโมเดลสามมิติเรืองแสง แต่มี "อะไรบางอย่าง" ที่เดินไปมาท่ามกลางเครื่องจักรเหล่านั้นทุกวัน ทำงาน 8-12 ชั่วโมงต่อวัน ปรับตัวตามคำสั่งผลิตที่เปลี่ยนทุกชั่วโมง — แต่แทบไม่เคยถูกจำลอง นั่นคือ คนงาน Human Digital Twin (HDT) คือแนวคิดการสร้างตัวแบบดิจิทัลของมนุษย์ในระบบการผลิต — ไม่ใช่แค่หุ่นยนต์เสมือนใน software จำลอง แต่คือการผูกข้อมูลการเคลื่อนไหว ท่าทาง ภาระงาน และบางกรณีถึงสัญญาณชีวภาพ เข้ากับโมเดลที่ใช้วิเคราะห์ ทำนาย และออกแบบงานให้กับคนได้ดีขึ้น ในห้วงที่อุตสาหกรรมทั่วโลกกำลังเผชิญภาวะแรงงานขาดแคลนและอัตราการลาออกสูง แนวคิดนี้กำลังขยับจากงานวิจัยสู่หน้างานจริง ทำไมต้องจำลองคน — เมื่อปัญหาของโรงงานคือคน ไม่ใช่เครื่องจักร เครื่องจักรมี datasheet บอกขีดจำกัดชัดเจน แต่คนไม่มี โรงงานส่วนใหญ่รู้ว่าเครื่อง CNC ตัวไหนทำงานได้กี่ชั่วโมงก่อนพัง แต่ไม่รู้ว่าคนงานคนไหนกำลังยกของเกินหลักการยศาสตร์ (ergonomics) มาก่อนจะบาดเจ็บ องค์กรเออร์โกโนมิกส์นานาชาติ (IEA) แบ่งสาขาวิชานี้ออกเป็น 3 ด้าน ซึ่งเป็นโครงของ HDT เช่นกัน: Physical Ergonomics — ท่าทางการทำงาน การยกของ การเคลื่อนไหวซ้ำๆ ซึ่งเป็นต้นเหตุอาการบาดเจ็บสะสม (MSD — Musculoskeletal Disorders) อันดับต้นของโรงงาน Cognitive Ergonomics — ภาระทางการรู้คิด ความเหนื่อยล้าทางสมอง การตัดสินใจภายใต้ความกดดัน ซึ่งสัมพันธ์กับข้อผิดพลาดในการปฏิบัติงาน Organizational Ergonomics — การออกแบบกะการทำงาน โครงสร้างทีม และการสื่อสาร ที่ส่งผลต่อทั้งประสิทธิภาพและความปลอดภัย Motion Capture — หนึ่งในเทคโนโลยีหลักที่ใช้เก็บข้อมูลการเคลื่อนไหวของคนเพื่อสร้าง Human Digital Twin (ภาพ: Wikimedia Commons, CC BY 2.0) Human Digital Twin ต่างจากการประเมินยศาสตร์แบบเดิมอย่างไร การประเมินยศาสตร์แบบดั้งเดิม เช่น การสังเกตการทำงานด้วยตาแล้วให้คะแนนความเสี่ยง เป็นการวัด "ชั่วขณะหนึ่ง" — วิศวกรมาสังเกต 30 นาที แล้วสรุปทั้งกะ HDT เปลี่ยนวิธีนี้สามชั้น: มิติ การประเมินแบบเดิม Human Digital Twin การเก็บข้อมูล สังเกตด้วยตา ถ่ายวิดีโอ แบบสอบถาม Motion capture, เซ็นเซอร์สวมใส่, กล้อง AI posture ต่อเนื่อง ช่วงเวลา…
Read More
Reality Capture สำหรับ Digital Twin: จาก LiDAR และ Point Cloud สู่โมเดลโรงงานที่ตรงความจริง (Scan-to-Twin)

Reality Capture สำหรับ Digital Twin: จาก LiDAR และ Point Cloud สู่โมเดลโรงงานที่ตรงความจริง (Scan-to-Twin)

Article
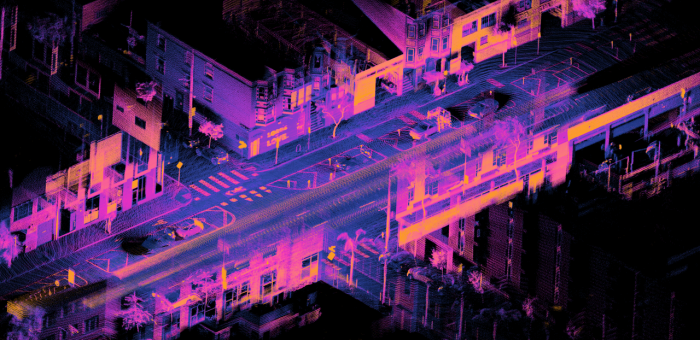
คำถามที่ทีมวิศวกรรมได้ยินบ่อยที่สุดเมื่อเริ่มโครงการ Digital Twin ของโรงงานเก่าคือ "แผ่น CAD ที่มีอยู่ ใช้ได้เลยไหม?" คำตอบในทางปฏิบัติแทบทุกครั้งคือ — ไม่ได้ หรือไม่แม่นพอ โรงงานที่อายุ 10-20 ปีผ่านการปรับปรุงเปลี่ยนแปลงมานับสิบรอบ ทั้งย้ายเครื่องจักร เพิ่มท่อ เปลี่ยนเลย์เอาต์ แต่แฟ้ม CAD ยังค้างอยู่ที่ฉบับวันเปิดโรงงาน ผลคือ "โมเดลที่สวยแต่โกหก" Reality Capture คือกระบวนการจับข้อมูลโลกจริงมาเป็นโมเดลดิจิทัล — ด้วยการสแกนด้วยเลเซอร์ (LiDAR) หรือการถ่ายภาพหลายมุมเพื่อคำนวณเป็นโมเดลสามมิติ (Photogrammetry) ผลลัพธ์ที่ได้เรียกว่า Point Cloud ซึ่งจะกลายเป็นรากฐานที่แท้จริงของ Digital Twin ที่สะท้อนโรงงาน "ตามที่มันเป็น" (as-built) ไม่ใช่ "ตามที่แบบบอก" กระบวนการทั้งหมดนี้เรียกอีกชื่อหนึ่งว่า Scan-to-Twin ทำความรู้จักเครื่องมือก่อน: LiDAR ทำงานอย่างไร LiDAR (Light Detection and Ranging) ทำงานโดยยิงลำแสงเลเซอร์ไปยังวัตถุแล้ววัดเวลาที่แสงสะท้อนกลับมายังตัวรับ จากนั้นคำนวณระยะทางจากความเร็วแสง เมื่อยิงซ้ำนับล้านครั้งต่อวินาทีพร้อมหมุนสแกนไปทั่วพื้นที่ เครื่องจะได้จุดพิกัดสามมิติจำนวนมหาศาลที่ประกอบกันเป็น "เมฆจุด" ของสภาพแวดล้อมจริง รายละเอียดนั้นสูงมากจนสามารถนำไปใช้วัดขนาดจริงได้ หัวสแกน LiDAR แบบหมุน — ยิงลำเลเซอร์นับล้านครั้งต่อวินาทีแล้ววัดเวลาที่แสงสะท้อนกลับ เพื่อระบุพิกัดสามมิติของทุกจุดในพื้นที่ (ภาพ: Wikimedia Commons, CC BY 2.0) How-to: 6 ขั้นตอนจากโรงงานจริงสู่ Digital Twin ขั้นที่ 1 — สำรวจหน้างานและวางแผนตำแหน่งสแกน (Scan Plan) เดินสำรวจพื้นที่ก่อนเสมอ ระบุอุปสรรคแสง (แสงจ้าจากประตูโรงงาน พื้นสะท้อนแสง ผิวโลหะมันวาว) แล้วกำหนดจุดตั้งกล้องให้ทุกมุมมีความซ้อนทับกันอย่างน้อย 30% ระหว่างสแกนแต่ละจุด หากใช้แบบ Handheld SLAM Scanner จะยืดหยุ่นกว่าสำหรับพื้นที่แคบ เช่น ช่องท่อใต้ผิวดินหรือบริเวณท่อร้อย ขั้นที่ 2 — ลงสแกนในหน้างาน สแกนแต่ละจุดใช้เวลาไม่กี่นาที โรงงานขนาดกลางอาจต้องลงสแกนหลายสิบถึงหลายร้อยจุด สิ่งสำคัญคือควบคุมคนเดินผ่านให้น้อยที่สุดระหว่างสแกน เพราะ "คน" จะกลายเป็น noise ใน point cloud ด้วยเหตุผลเดียวกัน ควรสื่อสารกับฝ่ายผลิตล่วงหน้าเพื่อจองช่วงเวลา เช่น วันหยุดปฏิบัติการหรือช่วงเปลี่ยนกะ ขั้นที่ 3 — รวมจุดสแกน (Registration) ไฟล์สแกนแต่ละจุดคือ "ภาพตัด" ของพื้นที่ ต้องนำมาเชื่อมกันเป็นแผนที่เดียว กระบวนการนี้เรียกว่า Point Set Registration โดยอัลกอริทึมที่ใช้แพร่หลายคือ ICP…
Read More
Soft Sensor (เซ็นเซอร์เสมือน): คำนวณค่าที่วัดไม่ได้จากข้อมูลที่มีอยู่แล้ว — หัวใจที่ถูกลืมของ Digital Twin ระดับกระบวนการ

Soft Sensor (เซ็นเซอร์เสมือน): คำนวณค่าที่วัดไม่ได้จากข้อมูลที่มีอยู่แล้ว — หัวใจที่ถูกลืมของ Digital Twin ระดับกระบวนการ

Article
ในโรงงานกระบวนการผลิต (Process Industry) มีค่าบางอย่างที่วิศวกร "อยากรู้" แต่วัดตรงๆ ไม่ได้ หรือวัดได้แต่ช้าเกินไป ซับซ้อนเกินไป หรือเปลืองเกินไป — ไม่ว่าจะเป็นความเข้มข้นของสารในถังปฏิกิริยา คุณภาพของผลิตภัณฑ์กลางกระบวนการ หรืออัตราการไหลมวลในท่อที่มีสารกัดกร่อน วิธีแก้ดั้งเดิมคือหยิบตัวอย่างส่งแล็บ ซึ่งใช้เวลาเป็นชั่วโมง ทำให้ค่าที่ได้ "สะท้อนอดีต" ไม่ใช่สิ่งที่เกิดขึ้นในถังตอนนี้ Soft Sensor (หรือเรียกอีกชื่อว่า Virtual Sensor / Inferential Sensor) คือคำตอบของปัญหานี้ — มันไม่ใช่ฮาร์ดแวร์ แต่เป็น "เซ็นเซอร์ชิ้นใหม่ที่เกิดจากซอฟต์แวร์" โดยนำค่าจากเซ็นเซอร์จริงหลายสิบถึงหลายร้อยตัวที่มีอยู่แล้วในระบบควบคุม มาประมวลผลร่วมกันเพื่อ "คำนวณ" ค่าที่ต้องการนั้นออกมาแบบเรียลไทม์ โดยไม่ต้องติดตั้งอะไรเพิ่มบนท่อหรือถังเลย Soft Sensor ทำงานอย่างไร — หลักการพื้นฐาน หัวใจของ Soft Sensor อยู่ที่แนวคิดทางทฤษฎีการควบคุมที่เรียกว่า State Observer — ระบบที่ใช้สัญญาณที่วัดได้หลายตัว มาประมาณ "สถานะภายใน" (internal state) ของกระบวนการที่มองไม่เห็น ลองนึกภาพถังปฏิกิริยาเคมี: เราวัดอุณหภูมิ ความดัน อัตราการป้อนวัตถุดิบ และกำลังกวนได้ แต่ความเข้มข้นของผลิตภัณฑ์ในถังต้องรอผลแล็บ Soft Sensor จะเรียนรู้ความสัมพันธ์ระหว่างสัญญาณเหล่านี้กับผลแล็บในอดีต แล้วใช้โมเดลนั้นทำนายความเข้มข้นทุก ๆ วินาที แทนที่จะรอชั่วโมงเดียว แผนภาพหลักการทำงานแบบ Predict–Correct ของ Kalman Filter — อัลกอริทึมตระกูล State Observer คลาสสิกที่ถูกนับเป็น Soft Sensor ยุคแรก (ภาพ: Wikimedia Commons, CC BY-SA 3.0) อัลกอริทึมที่ถูกยกให้เป็นตัวอย่างคลาสสิกของ Soft Sensor คือ Kalman Filter — อัลกอริทึมที่รับชุดการวัดที่มี noise เข้ามาต่อเนื่อง แล้วประมาณค่าตัวแปรที่ไม่รู้ค่าออกมาพร้อมช่วงความไม่แน่นอนของการประมาณ ส่วนการ implement ยุคใหม่นิยมใช้ Neural Network หรือ Fuzzy Computing ซึ่งจับความสัมพันธ์แบบไม่เชิงเส้น (non-linear) ที่ซับซ้อนได้ดีกว่าสมการคณิตศาสตร์แบบดั้งเดิม เปรียบเทียบ Soft Sensor กับเซ็นเซอร์จริงและการวิเคราะห์ในแล็บ ประเด็นเปรียบเทียบ เซ็นเซอร์จริง (Hardware Sensor) การเก็บตัวอย่างส่งแล็บ (Lab Analysis) Soft Sensor (Virtual Sensor) ความถี่ของข้อมูล ต่อเนื่อง (วินาที–มิลลิวินาที) ต่ำมาก (ทุก 2–8…
Read More
บทวิเคราะห์ GitOps สำหรับ Edge Fleet ของโรงงานหลายไซต์: จัดการ Configuration Drift ตามหลักการ OpenGitOps 4 ข้อ

บทวิเคราะห์ GitOps สำหรับ Edge Fleet ของโรงงานหลายไซต์: จัดการ Configuration Drift ตามหลักการ OpenGitOps 4 ข้อ

Article
คำถามที่ทุกโรงงานหลายไซต์เจอ: เซิร์ฟเวอร์ Edge 30 เครื่อง เหมือนกันจริงหรือไม่ เมื่อระบบ IIoT ขยายจาก pilot หนึ่งไซต์ไปสู่หลายโรงงาน คำถามที่ตามมาเสมอคือ เราจะมั่นใจได้อย่างไรว่าเซิร์ฟเวอร์ Edge ทุกเครื่องทั่วประเทศรันโค้ดเวอร์ชันเดียวกัน ใช้ค่า config เดียวกัน และติดตั้ง security patch ระดับเดียวกัน ประสบการณ์เดิมของหลายองค์กรคือการ ssh เข้าไปแก้ทีละเครื่อง ซึ่งใช้ได้กับ 3 เครื่อง แต่ไม่ใช่กับ 30 หรือ 300 เครื่อง คำตอบจากโลก software ที่กำลังไหลเข้าสู่โลกโรงงานคือ GitOps ซึ่ง OpenGitOps Working Group แห่ง CNCF ให้นิยามผ่านหลักการ 4 ข้อเวอร์ชัน 1.0.0 ได้แก่ Declarative (สถานะที่ต้องการต้องอธิบายแบบประกาศผล), Versioned and Immutable (เก็บประวัติทุกการเปลี่ยนแปลงแบบย้อนหลังได้), Pulled Automatically (agent ดึงสถานะจาก source เองโดยอัตโนมัติ) และ Continuously Reconciled (agent เฝ้าเทียบสถานะจริงกับที่ต้องการตลอดเวลา แล้วแก้กลับเมื่อพบความคลาดเคลื่อน) GitOps มักถูก implement คู่กับ lightweight Kubernetes บน edge node ของโรงงาน (ภาพ: Honey Corporation) Configuration Drift คือศัตรูที่แท้จริง ปัญหาไม่ใช่การติดตั้งครั้งแรก แต่คือ drift ที่สะสมทีละนิด เวอร์ชันโค้ดต่างกันหนึ่ง release, config ที่วิศวกรแก้ชั่วคราวตอนดึกเพื่อดับไฟปัญหา production แล้วลืมกลับมาเก็บ, patch ที่ติดตั้งบางเครื่องแต่ไม่ติดบางเครื่อง เมื่อเวลาผ่านไปหกเดือน ไม่มีใครกล้ายืนยันว่าทุกเครื่องเหมือนกันจริง และนี่คือจุดกำเนิดของปัญหา "ในเครื่องทดสอบทำงานได้ แต่ใน production ไม่ได้" รวมถึงช่องโหว่ความปลอดภัยที่ค้างอยู่ในเครื่องที่ถูกลืม วิเคราะห์: โมเดล Pull ทำงานกับ Edge ได้ดีอย่างไร จุดเปลี่ยนสำคัญที่ทำให้ GitOps เข้ากันได้กับสภาพแวดล้อมโรงงานคือโมเดล pull-based แทนที่เซิร์ฟเวอร์กลางจะ push การเปลี่ยนแปลงออกไปหา edge (ซึ่งต้องเปิดพอร์ตเข้าแต่ละเครื่องและรู้หมายเลข IP ทุกเครื่อง) ฝั่ง edge เป็นผู้ initiate connection ออกไปดึง desired state จาก Git repository…
Read More
Case Study: Store-and-Forward กู้ข้อมูลหายช่วงเน็ตหลุด — เมื่อ Edge Gateway ของโรงงานอาหารต้องเก็บข้อมูล HACCP ให้ครบ

Case Study: Store-and-Forward กู้ข้อมูลหายช่วงเน็ตหลุด — เมื่อ Edge Gateway ของโรงงานอาหารต้องเก็บข้อมูล HACCP ให้ครบ

Article
สถานการณ์: เมื่ออินเทอร์เน็ตโรงงานหลุดทุกเดือน ข้อมูลหายทุกครั้ง โรงงานแปรรูปอาหารแห่งหนึ่งในภาคกลางติดตั้งระบบเฝ้าระวังอุณหภูมิตู้แช่ด้วย IIoT Gateway ส่งข้อมูลขึ้นคลาวด์ทุก 30 วินาที เพื่อใช้ตรวจสอบย้อนหลังตามข้อกำหนด HACCP ปัญหาเกิดขึ้นเมื่อลิงก์อินเทอร์เน็ตของโรงงาน (ทั้ง fiber หลักและ 4G backup) ล่มพร้อมกันในช่วงพายุฤดูฝน เป็นเวลาราว 4 ชั่วโมง ข้อมูลช่วงนั้นหายไปทั้งหมด และทีมคุณภาพต้องเขียนรายงานอธิบายช่องว่างข้อมูลให้ผู้ตรวจสอบฟังทุกครั้ง ช่องว่างข้อมูลระหว่าง edge กับคลาวด์คือจุดที่พบปัญหาบ่อยที่สุดของระบบ IIoT (ภาพ: Honey Corporation) วินิจฉัยต้นตอ: สถาปัตยกรรมสมมติว่าเครือข่ายไม่มีวันล่ม การวิเคราะห์พบว่า gateway เดิมออกแบบแบบ "fire-and-forget" คืออ่านค่าเซ็นเซอร์แล้วส่งขึ้นคลาวด์ทันที หากส่งไม่สำเร็จก็ปล่อยข้อมูลนั้นหายไป ไม่มีการเก็บสำรองใดๆ บนตัวเครื่อง สถาปัตยกรรมลักษณะนี้ยอมรับได้กับ dashboard ดูสภาพแวดล้อมทั่วไป แต่ไม่เกิดผลกับงานที่ต้องมีหลักฐานข้อมูลต่อเนื่องตามกฎระเบียบ ทางแก้: Store-and-Forward บน Edge Gateway หลักการคือข้อมูลต้อง "เขียนลงดิสก์สำเร็จก่อน" แล้วจึงส่ง หากส่งไม่ได้ให้เก็บต่อในคิวจนกว่าเครือข่ายกลับมา ส่วนประกอบสำคัญมี 4 อย่าง Local persistent queue เก็บข้อมูลเป็นไฟล์บนดิสก์ gateway (เช่น embedded database หรือ log-structured storage) แยกจาก RAM เพื่อรอดจากไฟฟ้าดับ Send-then-acknowledge ข้อมูลถูกลบออกจากคิวเมื่อ server ปลายทางตอบรับสำเร็จเท่านั้น ไม่ใช่แค่ส่งออกไปแล้ว Circular buffer policy กำหนดขนาดคิวสูงสุดและนโยบายเมื่อเต็ม เช่น เขียนทับข้อมูลเก่าที่สุด หรือหยุดรับและเปิด alarm Timestamp ที่ต้นทาง ประทับเวลา ณ จุดอ่านค่าเซ็นเซอร์ ไม่ใช่เวลาที่ส่งสำเร็จ เพื่อให้ข้อมูลย้อนหลังยังถูกต้อง MQTT QoS 1 ร่วมกับ persistent session ช่วยให้ broker และ client จัดการข้อความค้างส่งได้อย่างเป็นระบบ (ภาพ: Honey Corporation) ในทางโปรโตคอล การเลือกใช้ MQTT ระดับ QoS 1 ร่วมกับ persistent session และการตั้งค่า message expiry interval ช่วยให้ broker ทำหน้าที่คล้ายกันในระดับหนึ่ง แต่สำหรับ outage ยาวหลายชั่วโมง การมีคิวบนดิสก์ของ gateway เองยังจำเป็น เพราะไม่ต้องพึ่ง TCP connection ที่ต้องเชื่อมต่อใหม่ทั้งหมด…
Read More
WebAssembly (Wasm) ที่ Edge ของโรงงาน: บทวิเคราะห์ Container Alternative ที่ Cold Start ต่ำกว่า 1 ms

WebAssembly (Wasm) ที่ Edge ของโรงงาน: บทวิเคราะห์ Container Alternative ที่ Cold Start ต่ำกว่า 1 ms

Article
ทำไมโรงงานปี 2026 ถึงพูดถึง Wasm ที่ Edge หลายทีมที่ดูแลระบบ IIoT คุ้นเคยกับการ deploy โค้ดลง Edge Gateway ด้วยสองทางเลือกคลาสสิก คือคอมไพล์โปรแกรมลง OS ตรงๆ หรือห่อด้วย Linux Container แต่ทั้งสองวิธีมีข้อจำกัดที่เจ็บปวดเมื่อเครื่อข่าย Edge โตขึ้น โค้ดที่คอมไพล์ตรงๆ ย้ายระหว่างสถาปัตยกรรม CPU ไม่ได้ ส่วน Container กินทรัพยากรเริ่มต้นค่อนข้างมากและมีพื้นที่โจมตี (attack surface) กว้าง WebAssembly หรือ Wasm คือ binary format มาตรฐานเปิดที่แก้ปัญหาเหล่านี้ได้พร้อมกัน ตัวเลขจาก State of WebAssembly Survey ปี 2026 ชี้ว่าผู้ใช้งานจริงใน production ขึ้นไปถึง 67% เพิ่มจาก 47% ในปี 2024 และเป็นครั้งแรกที่การใช้งานฝั่ง server-side แซงการใช้ในเบราว์เซอร์ โดย 52% ของ deployment ใช้งานในสภาพแวดล้อมที่ไม่ใช่เบราว์เซอร์ Edge Gateway คือจุดที่เหมาะที่สุดในการรัน Wasm module เพราะเป็นชั้นที่ต้องการทั้งความปลอดภัยและการจัดการโค้ดหลากหลายสถาปัตยกรรม CPU (ภาพ: Honey Corporation) Wasm แตกต่างจาก Container ตรงไหน หัวใจของ Wasm คือ sandbox ระดับสถาปัตยกรรมที่ออกแบบมาตั้งแต่แรก โมดูล Wasm แต่ละตัวทำงานแยกจากกันโดยสิ้นเชิง และไม่สามารถเข้าถึงไฟล์ เครือข่าย หรือ hardware ใดๆ ได้เลยจนกว่า host จะมอบสิทธิ์ (capability) ให้อย่างชัดเจน ลักษณะเช่นนี้ต่างจาก Container ที่ process ภายในแชร์ kernel ของ host และเคยมีช่องโหว่ container escape หลายครั้งในอดีต มิติเปรียบเทียบ Linux Container Wasm Module Cold Start500 ms ถึง 2 วินาทีต่ำกว่า 1 ms Memory ขั้นต่ำ100 MB ขึ้นไป1–10 MB ความสามารถพอร์ตตาบิลิตี้ผูกกับ OS และ CPU archbinary…
Read More
บทวิเคราะห์: Digital Twin ออกจากห้วงนำร่องปี 2026 — ทำไม Predictive Maintenance กลายเป็น use case แรกที่ขยายสู่ทั้งโรงงาน

บทวิเคราะห์: Digital Twin ออกจากห้วงนำร่องปี 2026 — ทำไม Predictive Maintenance กลายเป็น use case แรกที่ขยายสู่ทั้งโรงงาน

Article
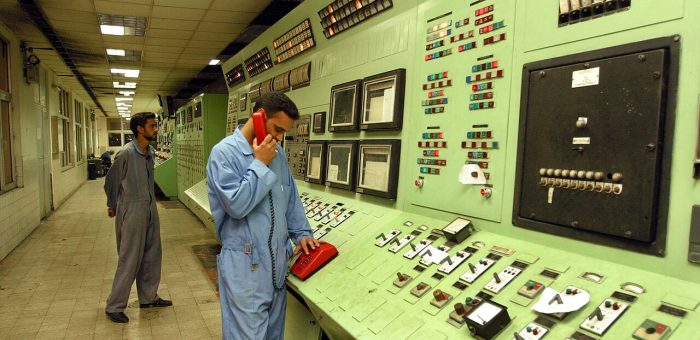
คำถามที่เปลี่ยนไป — สองปีก่อน คำถามที่ผู้บริหารโรงงานถามเรื่อง Digital Twin คือ "มันคุ้มไหม" ปี 2026 คำถามกลายเป็น "จะขยายจากนำร่องสู่ทั้งโรงงานได้อย่างไร" รายงานแนวโน้มอุตสาหกรรมการผลิตปี 2026 จากหลายสำนักวิเคราะห์ระดับโลกสะท้อนภาพเดียวกัน: Digital Twin และ Smart Factory กำลังก้าวพ้นช่วงทดลอง (Pilot Phase) สู่การใช้งานจริงในระดับองค์กร โดยเฉพาะในงานมอนิเตอร์เครื่องจักรเรียลไทม์และการบำรุงรักษาเชิงคาดการณ์ (Predictive Maintenance) การเปลี่ยนแปลงนี้สำคัญเพราะเกือบทศวรรษที่ผ่านมา เทคโนโลยีโรงงานอัจฉริยะติดอยู่ที่ "Pilot Purgatory" — นำร่องเสร็จ ทำได้จริง แต่ขยายไม่ได้ ครั้งนี้ต่างจากเดิมเพราะตัวแปรหลายตัวเปลี่ยนพร้อมกัน ห้องควบคุมโรงงาน — จุดที่ข้อมูลจาก Digital Twin ต้องมาบรรจบเป็นการตัดสินใจจริง ไม่ใช่แค่ภาพสวยบนจอ (ภาพ: Wikimedia Commons) ทำไมครั้งนี้ถึงออกจาก Pilot ได้จริง: 4 ตัวแปรที่พร้อมพร้อมกัน จากที่เราสังเกตจากงานวางระบบให้โรงงานอุตสาหกรรม การออกจากห้วงนำร่องของ Digital Twin ปี 2026 เกิดจากตัวแปร 4 ตัวที่สุกพร้อมกัน: ข้อมูลเรียลไทม์ราคาถูกลงมาก — เซ็นเซอร์วัดอุณหภูมิ แรงสั่นสะเทือน แรงดัน ความเร็วรอบ และพลังงาน พร้อมโปรโตคอลมาตรฐานอย่าง OPC UA (IEC 62541) และ MQTT ทำให้ต้นทุนการ "เติมเซ็นเซอร์" ให้เครื่องจักรเดิมลดลงจนคุ้มค่าในเชิงพาณิชย์ — เฉพาะงานแรงสั่น เซ็นเซอร์เร่งความเร็วแบบ MEMS รุ่นอุตสาหกรรมปัจจุบันสุ่มข้อมูลได้ระดับหลัก kHz เพียงพอต่อการวิเคราะห์ FFT หาความผิดปกติของลูกปืนและเฟืองตามโซนความรุนแรงของมาตรฐาน ISO 10816/20816 Edge Computing เสถียรแล้ว — การประมวลผลที่ตู้คอนโทรลหรือ Edge Gateway ทำให้การตรวจจับความผิดปกติเกิดขึ้นในหลักมิลลิวินาที ไม่ต้องรอขึ้นคลาวด์ ลดภาระแบนด์วิดท์และความเสี่ยงจากเน็ตขาด AI ตรวจจับความผิดปกติได้จริง — โมเดลเรียนรู้พฤติกรรมปกติของเครื่องจักรแต่ละตัว แล้วแจ้งเตือนเมื่อพฤติกรรมเบี่ยงเบน โดยไม่ต้องรอ failure label ที่มีน้อยมากในโรงงานจริง การผสานระบบที่จำเป็นเริ่มเป็นมาตรฐาน — Digital Twin + CMMS (ระบบซ่อมบำรุง) + ERP + Edge + 5G กำลังถูกออกแบบให้ทำงานร่วมกันตั้งแต่ต้น ไม่ใช่ต่อทีหลัง เซ็นเซอร์ IIoT ติดตั้งภาคสนามเพื่อมอนิเตอร์คุณภาพน้ำและอากาศ — โมเดลมูลค่าเดียวกันกับที่ใช้กับแรงสั่น อุณหภูมิ และแรงดันในงานบำรุงรักษาเชิงคาดการณ์ (ภาพ:…
Read More