บทวิเคราะห์ WRC 2026: เมื่อหุ่นยนต์ถูกถามว่า “ทำงานจริงได้หรือยัง” — สัญญาณจากปักกิ่งที่โรงงานไทยต้องอ่าน

บทวิเคราะห์ WRC 2026: เมื่อหุ่นยนต์ถูกถามว่า “ทำงานจริงได้หรือยัง” — สัญญาณจากปักกิ่งที่โรงงานไทยต้องอ่าน

Article
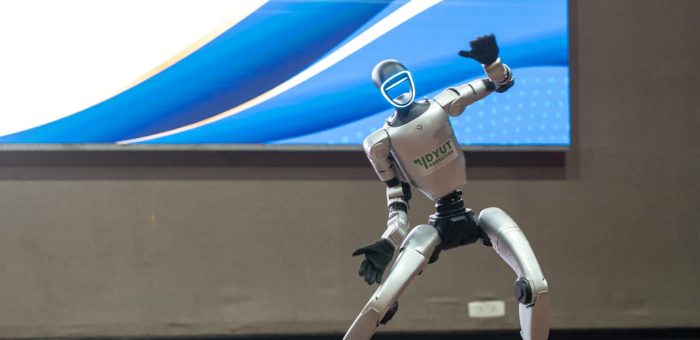
กลางเดือนสิงหาคมที่ผ่านมา งาน World Robot Conference (WRC) 2026 ที่ปักกิ่งปิดฉากลงด้วยภาพที่ต่างจากปีก่อนๆ อย่างชัดเจน — ไม่ใช่การแข่งกันอวดว่าโมเดลฉลาดแค่ไหน แต่เป็นการถูกถามคำถามตรงๆ ว่า "หุ่นยนต์ตัวนี้ทำงานจริงได้หรือยัง" และคำถามนั้น เป็นคำถามเดียวกันที่ผู้จัดการโรงงานในไทยถามทุกวัน ตัวเลขจากงานบอกอะไร ปีนี้ WRC มีผู้เข้าร่วมแสดงสินค้ามากกว่า 300 ราย เพิ่มขึ้นราว 40% จากปีก่อน พร้อมหุ่นยนต์บนเวทีราว 3,000 ตัว ในพื้นที่ 52,000 ตารางเมตร ขยายเป็น 4 ฮอลล์ แต่สิ่งที่น่าสนใจกว่าขนาดงานคือองค์ประกอบของคนในงาน: มี รัฐวิสาหกิจ (SOE) 49 แห่ง เดินทางมาร่วมกัน พร้อมส่งมอบ 12 สถานการณ์วิศวกรรมจริง ตั้งแต่งานโครงข่ายไฟฟ้า อวกาศ เหมืองแร่ ไปจนถึงงานโลหกรรม เพื่อหาโซลูชันหุ่นยนต์ที่ใช้งานได้จริง — ผู้ซื้อมาหาผู้ขายด้วยโจทย์จริง ไม่ใช่แค่มาชมเทคโนโลยี จาก VLA สู่ World Model — วิวัฒนาการที่โรงงานควรเข้าใจ กระแสเทคนิคที่เปลี่ยนไปจากปีก่อนคือ ปี 2025 คนพูดถึง Vision-Language-Action (VLA) model กันทั้งงาน แต่ปีนี้ผู้แสดงสินค้าหันมาพูดถึงการผสาน World Model เข้ากับ VLA แทน — งานวิจัยที่เผยแพร่บน arXiv ช่วงก่อนหน้านี้ก็ไปในทิศทางเดียวกัน โดยนำเสนอวิธี pre-train ที่ทำให้ policy เดียวทำงานข้ามรูปแบบหุ่นยนต์ที่ต่างกันได้ เหตุผลทางเทคนิคง่ายกว่าที่คิด: VLA เพียวๆ มองเห็นฉาก ตีความคำสั่ง แล้วสั่งการเคลื่อนไหวได้ แต่มันไม่ได้ "คาดเดา" ว่าสิ่งแวดล้อมจะเปลี่ยนไปอย่างไรหลังการกระทำนั้น เมื่องานยาวขึ้น ความผิดพลาดจึงสะสม และประสิทธิภาพตกทันทีที่เจอสถานการณ์ไม่คุ้นเคย — ซึ่งเป็นเรื่องปกติมากในสายการผลิตจริง ที่ตำแหน่งชิ้นงานคลาดเคลื่อนหรือของหลุดมือจาก pallet ได้ตลอดเวลา มุมเปรียบเทียบVLA เพียวๆVLA + World Model การมองสถานการณ์รับรู้ฉากปัจจุบันแบบ snapshotคาดการณ์การเปลี่ยนแปลงของสภาพแวดล้อม งานยาว (Long-horizon)error สะสม ประสิทธิภาพตกเสถียรกว่า เพราะคาดผลลัพธ์ก่อนลงมือ สถานที่ไม่คุ้นเคยต้องเทรนใหม่เมื่อ layout เปลี่ยน generalize ได้ดีกว่า ปรับตัวเร็วกว่า ความเร็วอนุมานเร็วกว่า (pipeline สั้น)ช้ากว่า แต่บางสถาปัตยกรรมลดช่องว่างได้ (มีรายงานเร็วขึ้น 2.71 เท่าจาก autoregressive แบบเดิม) การหยิบจับวัตถุด้วยมือหุ่นยนต์ในสภาพแวดล้อมจริง — งานที่ง่ายสำหรับคนแต่ยากที่สุดสำหรับโมเดล เพราะต้องคาดการณ์แรง…
Read More
State of IoT ล่าสุด: อุปกรณ์เชื่อมต่อทั่วโลกแตะ 21.1 พันล้านเครื่อง — โรงงานไทยควรอ่านตัวเลขไหนให้ขาด

State of IoT ล่าสุด: อุปกรณ์เชื่อมต่อทั่วโลกแตะ 21.1 พันล้านเครื่อง — โรงงานไทยควรอ่านตัวเลขไหนให้ขาด

Article
ทุกครั้งที่มีรายงานใหม่ออกมา เรามักเห็นพาดหัวแบบ "IoT โตมหาศาล" แต่คนทำงานในโรงงานควรสนใจตัวเลขจริงที่อยู่เบื้องหลัง เพราะมันบอกอะไรละเอียดกว่านั้นมาก — ล่าสุด IoT Analytics (ตุลาคม 2025) ปรับปรุงตัวเลข State of IoT รอบใหม่ และมีทั้งข่าวดีและสัญญาณเตือนที่น่าสนใจสำหรับผู้วางแผนระบบ IIoT ในไทย ตัวเลขหลักที่ต้องจำ จำนวนอุปกรณ์ IoT ที่เชื่อมต่ออยู่ทั่วโลกแตะ 21.1 พันล้านเครื่อง ณ สิ้นปี 2025 เพิ่มขึ้น 14% จาก 18.5 พันล้านเครื่องในปี 2024 และคาดการณ์ว่าจะไปถึง 39 พันล้านเครื่องในปี 2030 (CAGR 13.2%) ก่อนทะลุ 50 พันล้านเครื่องราวปี 2034–2035 น่าสังเกตว่าการเติบโต 14% นี้เกิดขึ้น "แม้" การลงทุนขององค์กรจะถูกเลื่อนออกไป และดีมานด์ในจีนชะลอตัวจน forecast ถูกปรับลงราว 300 ล้าน connection จากที่คาดไว้ก่อนหน้า ปีอุปกรณ์ IoT เชื่อมต่อ (พันล้านเครื่อง)การเติบโต YoY 202418.5+12% 202521.1+14% 2030 (คาด)39.0CAGR 13.2% 2035 (คาด)>50ชะลอหลังปี 2030 ที่มา: IoT Analytics, State of IoT 2025 (อัปเดต Fall 2025) 3 เทคโนโลยีที่กินส่วนแบ่งเกือบ 80% เบื้องหลังตัวเลขรวม การเชื่อมต่อ IoT แทบทั้งหมดกระจุกอยู่ใน 3 เทคโนโลยีหลักคือ Wi-Fi, Bluetooth และ Cellular IoT ซึ่งรวมกันคิดเป็นเกือบ 80% ของ connection ทั้งหมด โดย Cellular IoT โตเร็วกว่าค่าเฉลี่ยตลาด — เฉพาะปี 2026 คาดว่าจะมี connection แบบเซลลูลาร์ถึง 5.4 พันล้าน line (CAGR 14.3% ถึงปี 2030) เพราะงานอุตสาหกรรม โลจิสติกส์ และการแพทย์ ต้องการการเชื่อมต่อที่ควบคุมได้และครอบคลุมพื้นที่กว้างโดยไม่ต้องวางโครงข่ายเอง แผนภาพแนวคิด Industry 4.0 — การเชื่อมต่อระหว่างเครื่องจักร ข้อมูล และระบบสารสนเทศคือหัวใจของการเติบโตของ IoT (ภาพ: Wikimedia…
Read More
Cyber Resilience สำหรับโรงงาน: ศาสตร์แห่งการกลับมาผลิตให้เร็วที่สุด เมื่อการโจมตีหยุดไม่ได้

Cyber Resilience สำหรับโรงงาน: ศาสตร์แห่งการกลับมาผลิตให้เร็วที่สุด เมื่อการโจมตีหยุดไม่ได้

Article
เมื่อการโจมตีเปลี่ยนจาก "ขอเงิน" ไปเป็น "หยุดโรงงาน" — คำถามจึงไม่ใช่ว่าจะโดนหรือไม่ แต่คือกลับมาผลิตได้เร็วแค่ไหน ตลอดหลายปีที่ผ่านมา โรงงานอุตสาหกรรมคุ้นเคยกับ ransomware ในรูปแบบ "เข้ารหัสข้อมูล แล้วขอค่าไถ่" แต่แนวโน้มที่ชัดเจนในปี 2026 คือการเปลี่ยนเป้าหมายไปที่ operational disruption — การหยุดการผลิตโดยตรง ไม่จำเป็นต้องเข้ารหัสอะไรเลย อาจเป็นแค่การแก้ control logic ให้ไลน์หยุดเป็นพักๆ หรือปิดระบบ monitoring ชั่วคราวจนโรงงานต้องปิดเครื่องเพื่อความปลอดภัย รายงานจากสายงาน OT security ระบุว่า downtime ที่ไม่ได้วางแผนของบริษัทอุตสาหกรรมในเยอรมนีมีมูลค่าราว 147,000 ยูโรต่อชั่วโมง ตัวเลขนี้อธิบายว่าทำไมผู้โจมตีจึงหันมา "เล่นกับเวลา" แทนการเล่นกับข้อมูล — ทุกชั่วโมงที่ไลน์หยุด คือแรงกดดันที่เพิ่มขึ้นต่อฝ่ายบริหาร และคือ leverage ของฝ่ายโจมตีในการเจรจา ในโลกที่การป้องกันร้อยเปอร์เซ็นต์เป็นไปไม่ได้ Cyber Resilience จึงกลายเป็นคำถามที่วิศวกรโรงงานต้องตอบให้ได้: ไม่ใช่ "จะไม่ให้โดนได้อย่างไร" แต่คือ "เมื่อโดนแล้ว จะกลับมาผลิตได้เร็วแค่ไหน โดยไม่เสียความปลอดภัย" ระบบ IT ที่รองรับการกู้คืนโรงงาน — backup ที่ดีไม่ได้อยู่แค่ในห้องเซิร์ฟเวอร์ แต่ต้องมีสำเนาที่ผู้โจมตีแตะไม่ได้ (ภาพ: Wikimedia Commons, CC BY-SA 3.0) เปลี่ยนกรอบคิด: จาก Prevention เป็น Resilience กรอบคิดเดิมวางเงินไปที่กำแพง — firewall, antivirus, access control ซึ่งยังจำเป็นอยู่ แต่กรอบคิด resilience เพิ่มคำถามอีกสามข้อที่มักถูกลืม: ระบบจะ ตรวจจับการโจมตีได้เร็วแค่ไหน (MTTD), จะ จำกัดความเสียหายไม่ให้ลามไปทั้งโรงงานได้อย่างไร และจะ กู้คืนกลับมาผลิตได้ภายในเวลาเท่าไร (MTTR) มิติ กรอบคิดแบบ Prevention กรอบคิดแบบ Resilience เป้าหมายไม่ให้ผู้โจมตีเข้ามาได้เข้ามาแล้วรอด เห็นเร็ว กลับมาผลิตได้เร็ว ตัวชี้วัดหลักจำนวนการโจมตีที่บล็อกได้MTTD และ MTTR เทียบกับ RTO ที่ธุรกิจกำหนด บทบาทของ backupเป็นงานฝ่าย IT ตามหลังเป็นแกนหลักของการกู้คืน ต้องทดสอบทุกไตรมาส การซ้อมซ้อม table-top ปีละครั้ง (ถ้ามี)restore drill บน testbed ทุกไตรมาส วัดเวลาจริง ผู้รับผิดชอบทีม IT securityทีมผลิต + วิศวกรรม + IT ร่วมกัน หัวใจของการกู้คืนโรงงาน: สำรองสิ่งที่ "เป็นตัวโรงงาน"…
Read More
AI Security ในโรงงานอุตสาหกรรม: เมื่อ AI ที่ปกป้องสายการผลิต กลายเป็นเป้าหมายของผู้โจมตี

AI Security ในโรงงานอุตสาหกรรม: เมื่อ AI ที่ปกป้องสายการผลิต กลายเป็นเป้าหมายของผู้โจมตี

Article
เมื่อ AI เข้ามาอยู่ในสายการผลิต ใครจะเป็นคนเฝ้า AI ของคุณ? สองปีที่ผ่านมา โรงงานไทยต่างรีบดึง AI เข้าไปอยู่ในทุกจุดของสายการผลิต ตั้งแต่กล้องตรวจสอบคุณภาพบนสายพาน โมเดลทำนายการเสียหายของเครื่องจักร ไปจนถึงผู้ช่วย AI ที่ช่วยแนะนำการตั้งค่าพารามิเตอร์เครื่องจักร แต่มีคำถามหนึ่งที่หลายองค์กรยังไม่เคยตอบตัวเอง — ถ้า AI ตัวนั้นถูกโจมตี ใครจะรู้ตัว และรู้ได้อย่างไร รายงานดัชนีภัยคุกคามไซเบอร์ระดับโลกปี 2025 ระบุว่าอุตสาหกรรมการผลิตครองสัดส่วนการโจมตีทางไซเบอร์ถึง 17% ของทั้งหมดในปี 2025 เพิ่มขึ้นจาก 9% เมื่อปีก่อน ขณะที่ผลสำรวจผู้ผลิตทั่วโลกช่วงต้นปี 2026 พบว่า 40% ของผู้ผลิตส่วนใหญ่ระบุว่าความมั่นคงปลอดภัยไซเบอร์เป็นอุปสรรคอันดับ 1 ของการนำ AI มาใช้ — พวกเขามองเห็นความเสี่ยง แต่ทางออกที่ถูกต้องไม่ใช่การใช้ AI ให้น้อยลง หากคือการออกแบบระบบ AI ที่ "ปลอดภัยตั้งแต่ต้นทาง" (Security by Design) สายการผลิตอัตโนมัติสมัยใหม่มี AI ฝังอยู่ในทุกจุดตัดสินใจ — ตั้งแต่กล้องตรวจคุณภาพจนถึงการควบคุมเครื่องจักร (ภาพ: Wikimedia Commons, Public Domain) AI ในโรงงานถูกโจมตีได้จากทางไหนบ้าง? เส้นแบ่งระหว่าง "ปัญญาประดิษฐ์" กับ "ช่องโหว่ความปลอดภัย" ในโรงงานบางครั้งบางเกินไป การโจมตี AI ในสภาพแวดล้อมอุตสาหกรรมไม่ได้มากับไฟล์ malware ที่ antivirus สแกนเจอ หากมากับการบิดเบือน "ข้อมูล" และ "กระบวนการตัดสินใจ" ของ AI เอง ซึ่งเป็นมุมที่ทีม IT แบบดั้งเดิมมักมองข้าม เวกเตอร์การโจมตี กลไกการโจมตี ผลกระทบต่อสายการผลิต Adversarial Examples เพิ่มสัญญาณรบกวนขนาดเล็กที่ตามนุษย์มองไม่เห็น ทำให้โมเดล Computer Vision จำแนกชิ้นงานพลาด ชิ้นงานบกพร่องเล็ดลอดถึงลูกค้า หรือชิ้นงานดีถูกทิ้งเป็น scrap ทั้งที่เครื่องจักรปกติดี Model Poisoning แทรกข้อมูลปลอมเข้าชุดข้อมูลเทรน เช่น ป้ายกำกับผิดในระบบติดป้ายอัตโนมัติ จนโมเดลเรียนรู้ว่าความผิดปกติคือเรื่องปกติ โมเดล "เงียบๆ โง่ลง" อัตราการจับ scrap ค่อยๆ ตกลงเป็นเดือนโดยไม่มีใครรู้ตัว Data Evasion ปรับสภาพสัญญาณจากเซ็นเซอร์ เช่น ออฟเซ็ตอุณหภูมิเล็กน้อย ให้พ้นช่วงตรวจจับของโมเดล Anomaly Detection ความผิดพลาดของเครื่องจักรถูก "ทำให้มองไม่เห็น" จนเกิดความเสียหายจริง Prompt Injection ฝังคำสั่งแอบแฝงในเอกสารทางเทคนิค คู่มือ หรือ work…
Read More
บทวิเคราะห์: Anti-Surge Control — ทำไม Recycle Valve ตัวเดียวที่เปิดไม่ทันใน 200 มิลลิวินาที ชี้ขาดชะตากรรมของคอมเพรสเซอร์

บทวิเคราะห์: Anti-Surge Control — ทำไม Recycle Valve ตัวเดียวที่เปิดไม่ทันใน 200 มิลลิวินาที ชี้ขาดชะตากรรมของคอมเพรสเซอร์

Article
ในบรรดา Loop ควบคุมทั้งหมดในโรงงานโปรเซส มี Loop หนึ่งที่ไม่มีสิทธิ์ล้มเหลว — Anti-Surge Control ของ Centrifugal Compressor เพราะเมื่อเกิด Surge ขึ้นแล้ว แรงสั่นสะเทือนที่กระทบ Impeller, Thrust Bearing และ Dry Gas Seal จะทำลายเครื่องจักรภายในเวลาเพียงไม่กี่วินาที ผลที่ตามมาคือการเปลี่ยน Rotor ทั้งชุดและเวลาหยุดผลิตที่ยาวนานต่อทุกเหตุการณ์ บทวิเคราะห์นี้ถอดรหัสว่า Surge เกิดขึ้นได้อย่างไร และเพราะเหตุใดหัวใจของการป้องกันจึงอยู่ที่วาล์วตัวเดียวที่ต้องเปิดทันภายในระดับร้อยมิลลิวินาที Centrifugal Compressor ติดตั้งบน Skid พร้อมระบบประกอบ — หน้างานจริงในอุตสาหกรรมโปรเซส (ภาพ: Wikimedia Commons) Surge คืออะไร: วินาทีที่แรงดันไหลย้อนกลับ Centrifugal Compressor เสถียรเฉพาะเมื่อ Flow สูงกว่าค่าต่ำสุดของแต่ละความเร็วรอบและอัตราส่วนความดัน เมื่อ Flow ตกต่ำกว่าจุดนั้น (Surge Point) เครื่องจะไม่สามารถรักษา Differential Pressure ไว้ได้ แก๊สแรงดันสูงด้าน Discharge จะไหลย้อนกลับผ่านเครื่อง ความดันคายตัว เครื่องจักรสร้าง Flow ใหม่ชั่วขณะ แล้ววงจรก็ซ้ำไปซ้ำมา — นี่คือ Surge โดยในเครื่องขนาดเล็กวงรอบการไหลย้อนเกิดที่ความถี่ราว 10–20 Hz สร้างแรงกระชากซ้ำๆ บนชิ้นส่วนหมุนทั้งหมด ความน่ากลัวของ Surge อยู่ที่ความเร็วในการทำลาย: เหตุการณ์เพียง 1–2 วินาทีก็เพียงพอจะทำให้ใบพัดเกิด Fatigue Cracking จากการสั่นพ้อง Thrust Bearing รับแรงเพลามหาศาลระหว่างการไหลย้อน และ Dry Gas Seal เสียหายจากการกลับด้านของ Differential Pressure หลายเหตุการณ์ที่รายงานต่อกันมาจบด้วยการเปลี่ยน Rotor ทั้งชุด Surge Control Line: เส้นเบี่ยง 10–15% ที่ซ่อนความหมายไว้ Anti-Surge Controller คำนวณจุดทำงานของเครื่องแบบ Real-time (มักพล็อตเป็น Head vs Flow หรือ Pressure Ratio vs Reduced Flow) แล้วเทียบกับ Surge Limit Line ที่เก็บไว้ในตัวควบคุม ทางปฏิบัติจะวาง Surge Control Line แบบเว้นระยะ Flow Margin ประมาณ 10–15%…
Read More
How-to: Instrument Loop Check ตั้งแต่ Punch List ถึง Start-up — คู่มือ Commissioning ที่ช่าง Instrument ต้องรู้ก่อนเดินเครื่องครั้งแรก

How-to: Instrument Loop Check ตั้งแต่ Punch List ถึง Start-up — คู่มือ Commissioning ที่ช่าง Instrument ต้องรู้ก่อนเดินเครื่องครั้งแรก

Article
ก่อนโรงงานโปรเซสแห่งหนึ่งจะเดินเครื่องได้ มีขั้นตอนหนึ่งที่ไม่มีใครข้ามได้แต่มักถูกลดบทบาทจนกลายเป็นคอขวดของโครงการ — Instrument Loop Check งานนี้คือช่วงเวลาที่ทุกสายไฟ ทุก Transmitter และทุกวาล์วถูกพิสูจน์ว่าทำงานตรงตาม P&ID จริง บทความนี้เขียนแบบ How-to จากมุมมองคนทำหน้างาน ทีละขั้นตอนตามที่ปฏิบัติจริงในโครงการ Commissioning P&ID คือเอกสารหลักที่ใช้ตรวจสอบระหว่าง Loop Check — ทุก Tag Number ต้องตรงกับสิ่งที่ติดตั้งจริง (ภาพ: Wikimedia Commons) ขั้นที่ 1: เตรียม Loop Folder ให้พร้อมก่อนแตะหน้างาน งาน Loop Check ที่ลื่นไหลเริ่มจากการเตรียมเอกสาร ครึ่งหนึ่งของปัญหาหน้างานเกิดจาก Loop Folder ที่ไม่ตรงกับ As-built รายการที่ต้องมี: P&ID ฉบับล่าสุด, Loop Diagram, Instrument Index, Datasheet ของทุก Tag, Cause & Effect Diagram (สำหรับ SIS) และแบบฟอร์มบันทึกผลที่กำหนด Acceptance Criteria ไว้ล่วงหน้า เช่น ค่าที่อ่านได้ต้องเข้าเกณฑ์ภายใน ±0.5% ของ Span ขั้นที่ 2: Cold Loop Check — พิสูจน์ว่าสายถูกต้องก่อนจ่ายไฟ Cold Loop คือการตรวจสอบเชิงกายภาพก่อนมีกระแสไฟฟ้าไหลจริง: ไล่สายจาก Junction Box ถึง Marshalling Cabinet ตาม Loop Diagram เช็ก Isolation, Shield Ground ฝั่งเดียว, ตรวจ Insulation Resistance ด้วย Megger และยืนยันว่า Tag Number บนแผ่นป้ายตรงกับเอกสาร ข้อผิดพลาดที่พบบ่อยคือสายคู่ Twisted Pair ถูกสลับกันระหว่างฝั่ง Field กับฝั่ง Cabinet ทำให้สัญญาณรบกวนทีหลัง ขั้นที่ 3: Hot Loop Check — จ่ายสัญญาณแล้วดูว่าทุกอย่างพูดกันรู้เรื่อง Hot Loop คือการยิงสัญญาณจำลองเข้า Loop แล้วตรวจว่าค่าวิ่งถูกต้องครบทั้งสาย ทีมหน้างานมักใช้ Loop Calibrator จ่าย 4 / 12 /…
Read More
Control Valve และ Smart Positioner: Final Control Element ที่ถูกมองข้าม — เมื่อ Control Loop ที่แก้ไม่ได้ส่วนใหญ่ มีต้นตออยู่ที่วาล์ว

Control Valve และ Smart Positioner: Final Control Element ที่ถูกมองข้าม — เมื่อ Control Loop ที่แก้ไม่ได้ส่วนใหญ่ มีต้นตออยู่ที่วาล์ว

Article
ในโลกของ Process Automation หลายคนให้ความสำคัญกับ DCS, PID Algorithm และ Advanced Process Control แต่มักลืมว่าคำสั่งควบคุมทั้งหมดต้องผ่านอุปกรณ์กลไกชิ้นเดียวก่อนถึงกระบวนการผลิตจริง — Control Valve ประสบการณ์จากโครงการจริงหลายแห่งชี้ตรงกันว่า เมื่อ Control Loop หนึ่งแกว่งไม่หยุด ทั้งที่ Tuning ถูกต้องแล้ว สาเหตุมักไม่ได้อยู่ที่ตัวควบคุม แต่อยู่ที่วาล์วที่มี Hysteresis สูง, Stem Friction หรือ Positioner ที่หมดอายุการใช้งาน Final Control Element: จุดที่ Signal ไฟฟ้ากลายเป็นการไหลจริง Control Loop ปิด (Closed Loop) ประกอบด้วย 3 ส่วนหลัก: Sensor/Transmitter ที่วัดค่า Process Variable, Controller ที่คำนวณ Output และ Final Control Element ที่ลงมือปรับกระบวนการจริง ในอุตสาหกรรมโปรเซส ส่วนสุดท้ายนี้คือ Control Valve นั่นเอง — รับสัญญาณ 4–20 mA จาก Controller แปลงเป็นตำแหน่ง Stem แล้วเปลี่ยนอัตราการไหลของ Fluid ในท่อ ประเด็นสำคัญคือ วาล์วเป็นชิ้นส่วนกลไกที่เคลื่อนไหวต่อเนื่องเพียงชิ้นเดียวใน Loop ทั้งหมด Transmitter ไม่มีชิ้นส่วนหมุน 100 รอบ/วินาที แต่วาล์วอาจต้องขยับตำแหน่งหลายพันครั้งต่อวันในโหมดควบคุมที่แรง ความเสียดสีที่สะสมจึงเป็นตัวแปรที่เปลี่ยนไปตลอดเวลา และเป็นสาเหตุที่ Loop Performance ถดลงโดยไม่มีใครสังเกตเห็น Control Valve พร้อม Positioner ติดตั้งในโรงงานโปรเซสจริง — สังเกต Actuator ด้านบนและ Positioner ที่ยึดอยู่กับ Yoke (ภาพ: Wikimedia Commons) Positioner ไม่ใช่ "อุปกรณ์เสริม" แต่คือสมองของวาล์ว Positioner ทำหน้าที่เปรียบเทียบ Setpoint ตำแหน่งจาก Controller กับตำแหน่งจริงของ Stem แล้วปรับแรงดันอากาศเข้า Actuator จนกว่าตำแหน่งจริงจะตรงกับคำสั่ง — โดยพื้นฐานแล้ว Positioner คือ Controller ตัวที่สองที่ทำงานอยู่ในระดับตำแหน่ง (Position Loop) ซ้อนอยู่กับ Process Loop หลัก วาล์วที่ไม่มี…
Read More
บทวิเคราะห์: Model Drift — เมื่อ AI ตรวจสอบคุณภาพในโรงงานเงียบๆ โง่ลง และวิธีตรวจจับด้วย PSI / Jensen-Shannon / Wasserstein ก่อนที่ Scrap Rate จะบอกคุณเอง

บทวิเคราะห์: Model Drift — เมื่อ AI ตรวจสอบคุณภาพในโรงงานเงียบๆ โง่ลง และวิธีตรวจจับด้วย PSI / Jensen-Shannon / Wasserstein ก่อนที่ Scrap Rate จะบอกคุณเอง

Article
มีความล้มเหลวของ AI ในโรงงานอีกแบบหนึ่งที่เงียบกว่า outage และอันตรายกว่า bug — โมเดล vision ตรวจสอบคุณภาพที่เคยแม่นยำ 99% ในวัน go-live ค่อยๆ เสื่อมสภาพทีละนิดจนวันหนึ่ง scrap rate เริ่มไต่ขึ้นโดยไม่มี error message ใดๆ ปรากฏ ระบบยังเปิดอยู่ โมเดลยังตอบ แต่คำตอบนั้นเลื่อนจากความจริงไปเรื่อยๆ ปรากฏการณ์นี้คือ model drift และมันคือเหตุผลว่าทำไมโครงการ AI ในโรงงานจำนวนมากถึง “ตายหลังการผลิต” ทั้งที่ผ่าน UAT มาอย่างสวยงาม ทำไมโมเดลในโรงงานถึงเสื่อมเร็วกว่าที่คิด สภาพแวดล้อมการผลิตคือเครื่องจักรผลิต drift ชั้นเยี่ยม เปลี่ยน supplier วัสดุดิบเจอครั้งเดียว การกระจายของสีและ texture ในภาพตรวจสอบก็เปลี่ยน เครื่องจักรร้อนขึ้นตามอายุการใช้งาน ลำแสงกล้องสปอตไลต์เลือนลง แสงธรรมชาติเปลี่ยนตามฤดูกาล หรือแม้แต่การเปลี่ยนผู้ปฏิบัติงานก็เปลี่ยนพฤติกรรมการวางชิ้นงานต่อสายพาน ทุกอย่างที่โมเดลไม่เคยเห็นตอนเทรนคือ drift ที่กำลังจะเกิด ประเด็นสำคัญที่หลายทีมพลาดคือ drift ไม่ได้แค่ “เกิดขึ้นได้” แต่เกิดขึ้น แน่นอน — คำถามมีเพียงว่าจะเร็วแค่ไหนและคุณจะรู้ตัวก่อนหรือหลังความเสียหาย และในเชิงปฏิบัติ เมื่อ label จริง (ground truth) ใน production หาได้ยากหรือช้า การเฝ้าดูการกระจายของข้อมูลนำเข้าจึงกลายเป็นสัญญาณตัวแทน (proxy signal) ที่ดีที่สุดที่เรามี แยกให้ออก: Data Drift vs Concept Drift ก่อนจะเฝ้าระวัง ต้องเข้าใจว่า drift มีสองตระกูลใหญ่ที่สาเหตุและวิธีรักษาต่างกัน ถ้าสับสนสองอย่างนี้จะแก้ผิดทาง แผนภาพ: Data Drift (ซ้าย) คือการกระจายของ input เลื่อนแต่ความสัมพันธ์ input-output ยังเดิม / Concept Drift (ขวา) คือความสัมพันธ์นั้นเองเปลี่ยนไป (ที่มา: Honey Corporation) Data drift (หรือ covariate shift) คือการกระจายของ input features เปลี่ยนไปจากตอนเทรน — P(x) เปลี่ยน แต่ความสัมพันธ์ระหว่าง input กับ output ยังเหมือนเดิม ตัวอย่างโรงงานคือเปลี่ยน supplier วัสดุ ทำให้ค่าการสะท้อนแสงในภาพเลื่อนไปทางใดทางหนึ่ง ส่วน concept drift รุนแรงกว่า — ความสัมพันธ์ระหว่าง input กับ…
Read More
TinyML ในโรงงานอุตสาหกรรม: ฝาก AI ลงไมโครคอนโทรลเลอร์ขนาด KB เพื่อตรวจสุขภาพเครื่องจักรแบบ Real-time โดยไม่ต้องพึ่งคลาวด์

TinyML ในโรงงานอุตสาหกรรม: ฝาก AI ลงไมโครคอนโทรลเลอร์ขนาด KB เพื่อตรวจสุขภาพเครื่องจักรแบบ Real-time โดยไม่ต้องพึ่งคลาวด์

Article
หลายโรงงานที่เริ่มใช้ AI ตรวจสอบสถานะเครื่องจักรมักเจอทางตันเดียวกัน คือสถาปัตยกรรมแบบ “ส่งข้อมูลขึ้นคลาวด์แล้วค่อยวิเคราะห์” ทำงานได้ดีในห้องทดลอง แต่เมื่อลงสนามจริงกับเซ็นเซอร์หลายร้อยจุด ปัญหาที่ตามมาคือค่า bandwidth, latency หลายร้อยมิลลิวินาที และความเสี่ยงเมื่ออินเทอร์เน็ตขาดกลางคัน คำตอบที่วงวิศวกร embedded เลือกใช้มากขึ้นเรื่อยๆ ในปี 2026 คือ TinyML — การฝากโมเดล Machine Learning ที่ผ่านการบีบอัดลงไปรันบนไมโครคอนโทรลเลอร์ (MCU) ที่มี RAM เพียงหลักร้อยกิโลไบต์ กินไฟระดับมิลลิวัตต์ และตัดสินใจได้เองที่ขอบเครือข่ายโดยไม่ต้องส่งข้อมูลดิบออกไปไหนเลย TinyML คืออะไร และทำไมโรงงานควรสนใจ TinyML คือสาขาย่อยของ Machine Learning ที่เน้นการ deploy และรันโมเดลบนอุปกรณ์ embedded ที่มีทรัพยากรจำกัด เช่น ไมโครคอนโทรลเลอร์ที่มี RAM เพียง “หลักสิบถึงหลักร้อยกิโลไบต์” flash จำกัด ไม่มี GPU และมักรันบน bare-metal หรือ RTOS เบาๆ ข้อจำกัดพวกนี้บังคับให้ทุกการตัดสินใจทางวิศวกรรมต้องแม่นยำ ตั้งแต่เลือกสถาปัตยกรรมโมเดลไปจนถึงวิธี quantize น้ำหนักโมเดล เหตุผลที่แนวทางนี้โตเร็วในภาคอุตสาหกรรมชัดเจนมาก: การทำ inference บนตัวอุปกรณ์เองช่วยรักษาความเป็นส่วนตัวของข้อมูล (ไม่ต้องส่ง raw data ขึ้นคลาวด์), ยืดอายุแบตเตอรี่ และทำให้ระบบตรวจจับความผิดปกติทำงานต่อได้แม้เน็ตหลุด สำหรับโรงงานที่มีจุดวัดในพื้นที่ห่างไกลหรือสภาพแวดล้อมรุนแรง TinyML จึงเป็นเสมือน “ผู้เชี่ยวชาญที่ประจำอยู่ในเครื่องจักร” 24 ชั่วโมง แผนภาพ: TinyML pipeline — เซ็นเซอร์ส่งสัญญาณเข้า preprocessing (FFT/Filter) แล้วป้อนเข้าโครงข่ายประสาทเทียมขนาดเล็กบน MCU ที่ตัดสินใจส่ง alert เองโดยไม่ผ่านคลาวด์ (ที่มา: Honey Corporation) อาหารสมองของ TinyML: Quantization หัวใจที่ทำให้โมเดล AI ลงไปอยู่ใน MCU ได้คือเทคนิคบีบอัด โมเดล image classification สถาปัตยกรรมยอดนิยมขนาด 50 เลเยอร์ในความละเอียดเต็ม (FP32) มีขนาดราว 100 MB เมื่อแปลงเป็น INT8 ด้วย Post-Training Quantization (PTQ) จะเหลือประมาณ 5 MB และเมื่อปรับให้เหมาะกับงานเฉพาะแบบ TinyML แล้ว ขนาดที่ทำได้จริงคือระดับ 500 KB — เล็กลงราว 200 เท่าจากต้นฉบับ พอที่จะฝากลง flash…
Read More
Case Study: Federated Learning ในงาน Metal Additive Manufacturing — เมื่อ 3 โรงงานร่วมมือเทรนโมเดลตรวจจับ Defect โดยไม่ส่งข้อมูลดิบออกนอกไซต์

Case Study: Federated Learning ในงาน Metal Additive Manufacturing — เมื่อ 3 โรงงานร่วมมือเทรนโมเดลตรวจจับ Defect โดยไม่ส่งข้อมูลดิบออกนอกไซต์

Article
โจทย์คลาสสิกของ AI ในโรงงานคือ “ข้อมูลไม่พอเทรน” เครื่องจักรแต่ละตัวผลิต defect ที่หลากหลายและหายาก การเก็บชุดข้อมูลตัวอย่างที่ครอบคลุมทุกรูปแบบความผิดพลาดในไซต์เดียวอาจใช้เวลาเป็นปี ทางออกที่ตรงไปตรงมาคือรวมข้อมูลจากหลายโรงงานเข้าด้วยกัน — แต่แผนภาพสถานการณ์ของข้อมูล สูตรการผลิต และภาพถ่ายชิ้นงานจริง มักถูกจัดเป็นความลับทางการค้าที่แบ่งปันกันไม่ได้ บทความนี้ถอดบทเรียนจากงานวิจัยจริงที่ใช้ Federated Learning (FL) แก้ปัญหานี้ในงาน Metal Additive Manufacturing (การพิมพ์โลหะสามมิติ) ปัญหา: โมเดลตรวจ defect ที่ “ฉลาดเฉพาะบ้านตัวเอง” ในกระบวนการพิมพ์โลหะด้วยเลเซอร์ (Laser-Based Powder Bed Fusion) defect เกิดจากปัจจัยเชิงกายภาพมากมาย — พลังงานเลเซอร์, ความหนาผงโลหะ, อุณหภูมิแผ่นรองรับ และพฤติกรรมของ melt pool ระหว่างการพิมพ์ แต่ละไซต์ผลิตมีเครื่องพิมพ์คนละรุ่น ใช้ผงโลหะคนละล็อต และเจอ defect pattern ที่ไม่เหมือนกัน ผลคือโมเดลที่เทรนจากข้อมูลไซต์เดียว (Isolated Learning) ทำนายได้ดีในบ้านตัวเองแต่พลาดเมื่อเจอรูปแบบใหม่ ขณะที่การรวมศูนย์ข้อมูล (Centralized Learning) กระทบทั้งความเป็นส่วนตัวและขนาดข้อมูลที่ต้องเคลื่อนย้าย ทางออก: เทรนร่วมกันโดยข้อมูลไม่ต้องย้ายบ้าน Federated Learning กลับสูตรการเทรนแบบเดิม แทนที่จะย้าย “ข้อมูล” ไปหาโมเดล ก็ส่ง “โมเดล” ไปหาข้อมูล แต่ละโรงงาน (client) เทรนโมเดลสำเนาของตัวเองด้วยข้อมูลในพื้นที่ แล้วส่งเฉพาะ ค่าน้ำหนักที่อัปเดต (weight updates) กลับไปยังเซิร์ฟเวอร์กลาง เซิร์ฟเวอร์รวม (aggregate) การอัปเดตจากทุกไซต์ด้วยอัลกอริทึมอย่าง FedAvg ให้กลายเป็นโมเดลร่วม (global model) แล้วส่งกลับไปให้ทุกไซต์ในรอบถัดไป วนซ้ำแบบนี้จนโมเดลลู่เข้า แผนภาพ: วงจร Federated Learning — client เทรนในพื้นที่ ส่งเฉพาะ weight updates ขึ้นเซิร์ฟเวอร์กลางเพื่อ aggregate ด้วย FedAvg แล้วรับ global model กลับมา (ที่มา: Honey Corporation) ความต่างจากการเทรนรวมศูนย์เห็นได้ชัดเมื่อเปรียบเทียบว่า “อะไรเดินทางออกจากโรงงาน” ในแบบรวมศูนย์ ชุดข้อมูลดิบทั้งก้อนต้องออกจากทุกไซต์ไปอยู่บนเซิร์ฟเวอร์เดียว แต่ในแบบ federated สิ่งเดียวที่ออกจากไซต์คือพารามิเตอร์โมเดลขนาดกิโลไบต์ถึงหลักเมกะไบต์ต่อรอบ ข้อมูลภาพ melt pool หรือสูตรกระบวนการที่อ่อนไหวยังอยู่หลังไฟร์วอลล์ของเจ้าของข้อมูลเหมือนเดิม แผนภาพ: Centralized vs Federated — ซ้ายคือ raw data ทั้งหมดออกจากทุกไซต์ ขวาคือเฉพาะ model parameters เดินทาง…
Read More