Metal FFF และ Bound Metal Deposition: พิมพ์โลหะ 316L บนเครื่อง FFF ธรรมดา ก่อนส่งเตา Sintering — คู่มือจาก Green Part ถึงชิ้นงานความหนาแน่น 96%

Metal FFF และ Bound Metal Deposition: พิมพ์โลหะ 316L บนเครื่อง FFF ธรรมดา ก่อนส่งเตา Sintering — คู่มือจาก Green Part ถึงชิ้นงานความหนาแน่น 96%

Article
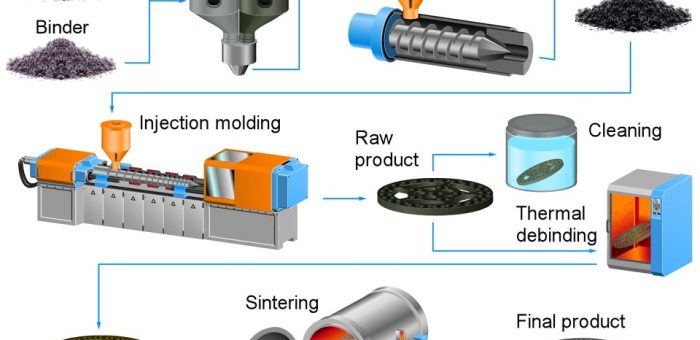
โลหะบนเครื่องพิมพ์ FFF — ถ้าพูดถึงงานพิมพ์โลหะสามมิติ (Metal AM) คนส่วนใหญ่นึกถึงเครื่องเลเซอร์ผงโลหะที่ต้องลงทุนสูงและห้องก๊าซเฉื่อย แต่ปี 2026 มีเส้นทางอื่นที่ "เบากว่า" และเข้าถึงง่ายกว่ามาก นั่นคือการเอาผงโลหะผสมในฟิลาเมนต์พลาสติก แล้วก็บนเครื่องพิมพ์ FFF (Fused Filament Fabrication) ธรรมดา ก่อนส่งไปเผาในเตา sintering — แนวทางที่อุตสาหกรรมเรียกว่า Metal FFF หรือ Bound Metal Deposition แนวคิดนี้ยืมมาจากเทคโนโลยีที่พิสูจน์ตัวมานานกว่า 40 ปี นั่นคือ Metal Injection Molding (MIM) ซึ่งผสมผงโลหะละเอียดกับไบน์เดอร์พลาสติก ฉีดขึ้นรูป แล้วล้างไบน์เดอร์ออกก่อน sintering ที่อุณหภูมิ 1,350–1,400°C จนได้ความหนาแน่น 96–99% Metal FFF จึงเป็น "MIM ที่เปลี่ยนขั้นตอนฉีดเป็นการพิมพ์" ทำให้ได้ทั้งความแข็งแรงระดับโลหะหล่อ และอิสระทางเรขาคณิตของการพิมพ์ โดยไม่ต้องทำแม่พิมพ์ แผนภาพหลักการ Powder Injection Molding (MIM) ที่ Metal FFF ยืมกระบวนการ debinding–sintering มาใช้ทั้งชุด | ที่มา: Wikimedia Commons (CC BY-SA 4.0) ทำงานอย่างไร: 3 ขั้นตอน Print → Debind → Sinter ขั้นที่ 1 — พิมพ์ "Green Part": ฟิลาเมนต์โลหะประกอบด้วยผงสเตนเลส 316L หรือ 17-4 PH ประมาณ 80–90% โดยน้ำหนัก ผสมกับไบน์เดอร์พอลิเมอร์ที่ทำหน้าที่เป็น "พาหะ" ให้วัสดุไหลผ่านหัวฉีดได้เหมือนพลาสติกทั่วไป เครื่องพิมพ์ FFF มาตรฐานที่รองรับ Bowden หรือ Direct Drive ก็สามารถใช้งานได้ ชิ้นงานที่ได้เรียกว่า green part ซึ่งมีขนาดใหญ่กว่าชิ้นงานจริง เพราะต้องเผื่อการหดตัวหลังเผา ขั้นที่ 2 — Debinding: ชิ้นงานถูกแช่ในตัวทำละลาย (สำหรับระบบ catalyst หรือ solvent debinding) เพื่อดึงไบน์เดอร์ส่วนแรกออก เหลือโครงสร้างรูพรุนที่เปราะแต่คงรูป เรียกว่า brown part — ขั้นตอนนี้คือหัวใจที่ตัดสินว่าชิ้นงานจะแตกหรือไม่ในเตา ขั้นที่ 3 — Sintering:…
Read More
Case Study: โรงหล่อที่ลบ pattern ออกจากสมการ — เมื่อ Sand Binder Jetting ตัด lead time งานต้นแบบจาก 8 สัปดาห์เหลือ 5 วัน

Case Study: โรงหล่อที่ลบ pattern ออกจากสมการ — เมื่อ Sand Binder Jetting ตัด lead time งานต้นแบบจาก 8 สัปดาห์เหลือ 5 วัน

Article
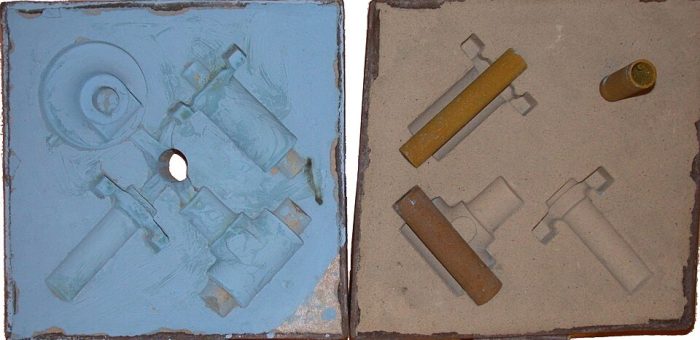
Case Study: โรงหล่อที่ลบคำว่า "แม่พิมพ์" ออกจากปฏิทิน — โรงหล่อโลหะแห่งหนึ่งในนิคมอุตสาหกรรมภาคตะวันออกรับงานหล่อชิ้นส่วนเครื่องจักรครึ่งผลิตภัณฑ์ ปัญหาเดิมที่ทำให้เสียงานมาตลอดคือ ลูกค้าต้องการชิ้นหล่อต้นแบบ 2–3 ชิ้นเพื่อทดสอบการประกอบ แต่กระบวนการเดิมบังคับให้ทำแม่พิมพ์ไม้/โลหะก่อนเสมอ รอคิว 4–8 สัปดาห์ และถ้าทดสอบแล้วต้องแก้ขนาด ก็ต้องเริ่มกระบวนการแม่พิมพ์ใหม่อีกรอบ ลูกค้าหลายรายเลือกส่งงานไปต่างประเทศแทน ปัญหา: Pattern คือ bottleneck ที่ไม่มีใครแก้มา 50 ปี ในการหล่อทรายแบบดั้งเดิม ทุกชิ้นงานเริ่มจากการสร้าง pattern (แบบจำลองของชิ้นงาน) จากไม้ อะลูมิเนียม หรือพลาสติก แล้วบดทรายลงรอบ ๆ เพื่อสร้างโพรงแม่พิมพ์ pattern ต้องเผื่อ contraction allowance ตามโลหะที่หล่อ ต้องมี draft angle ให้ดึงออกได้ และต้องทำ core print สำหรับวางแกนทราย (core) ที่สร้างช่องภายใน — ทั้งหมดนี้คือทักษะช่างแม่พิมพ์ระดับสูงที่หายากขึ้นทุกปี และเป็นต้นทุนคงที่ที่โรงหล่อต้องจ่ายไม่ว่าจะหล่อ 2 ชิ้นหรือ 2,000 ชิ้น แม่พิมพ์ทรายครึ่งบน (cope) ครึ่งล่าง (drag) พร้อม core ทรายสำหรับสร้างช่องภายใน — องค์ประกอบเดิมที่ยังต้องใช้ต่อ แต่ต้นทางการทำ pattern เปลี่ยนไปตลอด | ที่มา: Wikimedia Commons (CC BY-SA 2.0) ทางออก: พิมพ์แม่พิมพ์ทรายโดยไม่ต้องมี pattern โรงหล่อนี้เริ่มนำ เครื่องพิมพ์แม่พิมพ์ทรายขนาดใหญ่ (Sand Binder Jetting) มาใช้ในปี 2024 หลักการคือพิมพ์ทรายผสม binder สะสมชั้นทับชั้นโดยตรงจากไฟล์ CAD กลายเป็นแม่พิมพ์และ core พร้อมใช้งาน — ข้ามขั้นตอนสร้าง pattern ทั้งหมด สำหรับงานต้นแบบ แม่พิมพ์ขนาดกลางพิมพ์เสร็จภายใน 1–3 วัน และเพราะทุกแม่พิมพ์มาจากไฟล์ การแก้ไขดีไซน์รอบที่สองแค่แก้ CAD แล้วกดพิมพ์ใหม่ ไม่ต้องรอช่างแก้แม่พิมพ์ไม้ สิ่งที่เปลี่ยนไม่ใช่แค่ความเร็ว แต่คือ เส้น parting line ที่หายไป — แบบพิมพ์สามารถมี undercut และช่องภายในที่ pattern ดั้งเดิมดึงออกจากทรายไม่ได้ ทำให้วิศวกรรวมชิ้นส่วนหลายชิ้นเป็นชิ้นเดียว ลดจุดร้อยที่เคยเป็นจุดรั่วของงานหล่อแบบประกอบ ชิ้นงานหล่อดิบ (บรอนซ์และอะลูมิเนียม) ก่อนแต่งผิว — คุณภาพผิวของงานพิมพ์ทรายใกล้เคียงงาน no-bake แบบดั้งเดิม | ที่มา: Wikimedia…
Read More
บทวิเคราะห์ Cold Spray: ซ่อมเครื่องจักรด้วยผงโลหะความเร็วเหนือเสียง โดยไม่หลอม ไม่บิดเบี้ยว และไม่ต้องห้องก๊าซเฉื่อย

บทวิเคราะห์ Cold Spray: ซ่อมเครื่องจักรด้วยผงโลหะความเร็วเหนือเสียง โดยไม่หลอม ไม่บิดเบี้ยว และไม่ต้องห้องก๊าซเฉื่อย

Article
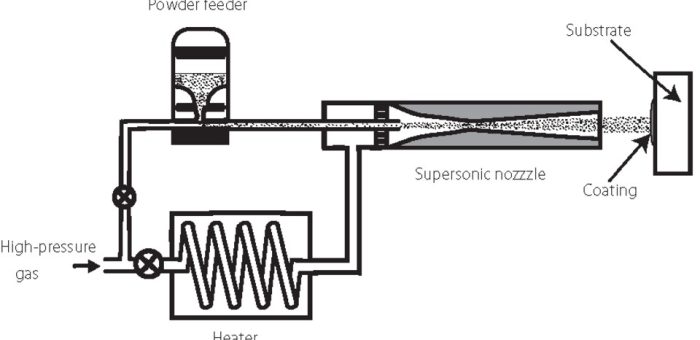
ซ่อมโดยไม่หลอม — ในโลกของ Additive Manufacturing ที่ทุกคนพูดถึงการ "สร้าง" ชิ้นส่วนใหม่ มีสายเทคโนโลยีหนึ่งที่เติบโตเงียบ ๆ จากทิศตรงข้าม คือการ "ซ่อม" ชิ้นส่วนเดิมให้กลับมาใช้งานได้ นั่นคือ Cold Spray (Gas Dynamic Cold Spray) กระบวนการพ่นผงโลหะด้วยความเร็วเหนือเสียงที่ ไม่หลอมโลหะตลอดกระบวนการ — และในมุมของผู้ดูแลสายการผลิต นี่อาจเป็นคำตอบของคำถามที่แพงกว่าการสร้างใหม่ นั่นคือ downtime Cold Spray ถูกคิดค้นโดยนักวิทยาศาสตร์รัสเซียในทศวรรษ 1990 ขณะทดลองเรื่องการกัดกร่อนของผงในอุโมงค์ลม แล้วบังเอิญพบว่าผงโลหะความเร็วสูงเกาะแน่นกับพื้นผิวเป้าหมายจนกลายเป็นเคลือบ เทคโนโลยีนี้ถูกพาไปสู่เชิงพาณิชย์ในทศวรรษเดียวกัน และวันนี้ถูกใช้ซ่อมชิ้นส่วนอากาศยานและอุปกรณ์ทหารเรือสหรัฐในระดับปฏิบัติการจริง หลักการ: พลังงานจลน์แทนความร้อน ขณะที่ thermal spray รุ่นเก่าอย่าง HVOF หรือ plasma spray ต้องหลอมหรือกึ่งหลอมผงก่อนพ่น Cold Spray เร่งผงโลหะขนาด 1–50 ไมโครเมตร ในกระแสก๊าซไนโตรเจนหรือฮีเลียมเหนือเสียง (สูงสุดราว 1,200 ม./วินาที) อุณหภูมิก๊าซไม่เกิน ~900°C ซึ่งต่ำกว่าจุดหลอมของโลหะที่พ่น เมื่ออนุภาคชนพื้นผิวด้วยความเร็วเหนือ critical velocity พลังงานจลน์เปลี่ยนเป็นการเสียรูปพลาสติก อนุภาคกระแทกแบนราบและยึดเกาะด้วยกลไก adiabatic shear instability — โลหะไหลตัวแบบของเหลวที่บริเวณรอยต่อแทบจะเข้าใกล้จุดหลอม ทั้งที่อุณหภูมิกว้างของชิ้นงานยังเย็น แผนภาพหลักการ Cold Spray: ผงโลหะถูกเร่งผ่าน nozzle De Laval จนเหนือเสียง ก่อนยึดเกาะพื้นผิวแบบ solid-state | ที่มา: Wikimedia Commons (CC BY 4.0) ทำไมโลกอุตสาหกรรมถึงหันมาสนใจ เหตุผลที่ Cold Spray ได้แรงผลักดันในช่วงหลายปีมานี้ วงจรมาจากปัญหาจริงของโรงงาน: ความร้อนต่ำ = ไม่บิดเบี้ยว — ชิ้นงาน base แทบไม่โดนความร้อน จึงซ่อมได้โดยไม่ทำให้ dimension ดั้งเดิมเปลี่ยน ไม่ต้อง heat treatment ซ้ำ ไม่ต้องห้องก๊าซเฉื่อย — ต่างจาก laser-based AM ที่ต้อง vacuum หรือก๊าซเฉื่อย Cold Spray ทำงานในบรรยากาศปกติ ทำให้ทำงานกับชิ้นงานใหญ่และถึงขนาด 9×3×1.5 เมตรได้ (เครื่องพิมพ์โลหะ cold spray ที่ใหญ่ที่สุดในโลกใช้หลักการนี้) อัตราการเติมวัสดุสูงถึง 45 กก./ชม. — เร็วกว่า…
Read More
Spatial Anchoring และ Persistent AR: ทำไมคำสั่งงาน AR ที่ ‘ลอย’ ไม่ยังตรงที่เดิม คือปัญหาที่แก้ได้ด้วยวิศวกรรม ไม่ใช่เวทมนตร์

Spatial Anchoring และ Persistent AR: ทำไมคำสั่งงาน AR ที่ ‘ลอย’ ไม่ยังตรงที่เดิม คือปัญหาที่แก้ได้ด้วยวิศวกรรม ไม่ใช่เวทมนตร์

Article
ทีมวิศวกรหลายทีมที่ทดลองใช้ AR ในโรงงานเจอปัญหาเดียวกันเกือบทุกครั้ง — Demo วันแรกเป็นไปได้ด้วยดี แว่น AR ชี้ให้เห็นคำอธิบายใต้ฝาครอบเกียร์ลดความเร็วพอดีตำแหน่ง แต่พอช่างเทคนิคกลับมาทำงานจริงในสัปดาห์ถัดมา ข้อความเดิมกลับลอยเหนือพื้นโรงงาน หรือไปเกาะอยู่กับราวกันสั่นข้างเคียง ปัญหานี้ไม่ใช่ความล้มเหลวของ AR แต่เป็นการออกแบบระบบ Spatial Anchoring ที่ยังไม่ครบ บทความนี้เจาะลึกกลไกการตรึงตำแหน่งเสมือนให้ติดกับโลกกายภาพอย่างถาวร ตั้งแต่หลักการทางคณิตศาสตร์ ไปจนถึงแนวปฏิบัติที่ทีมงาน Honey Corporation ใช้เวลาติดตั้งระบบ AR คู่กับ Digital Twin ในโรงงานจริง ปัญหาเบื้องหลังคำว่า "คำสั่งงานลอยไม่ตรงที่" อุปกรณ์ AR ทุกเครื่องต้องตอบคำถามเดียวกันตลอดเวลา: ตำแหน่งและมุมมองของฉันเทียบกับโลกจริงตอนนี้คืออะไร คำถามนี้ตอบด้วยกระบวนการ Tracking ซึ่งมีข้อจำกัดทางกายภาพสามข้อ Drift เชิงสะสม — การประมาณการเคลื่อนที่จากเซ็นเซอร์ IMU (Inertial Measurement Unit) มีค่าคลาดเคลื่อนเล็กน้อยทุกวินาที หลังเดิน 10 นาทีในโรงงาน ความคลาดเคลื่อนสะสมอาจถึงหลายสิบเซนติเมตร การสูญเสีย Tracking — เมื่อคนงานเดินผ่านมุมอับสัญญาณหรือห้องที่ผนังเรียบไม่มีจุดอ้างอิง ระบบจะ "หลง" ชั่วคราว และเมื่อกลับมาจับได้ใหม่ ตำแหน่งเดิมอาจเพี้ยน สภาพแสงที่เปลี่ยน — โรงงานกลางวันกับกลางคืน หรือฝุ่นในอากาศ ทำให้จุดอ้างอิงภาพ (Feature Points) ที่กล้องมองเห็นต่างกันโดยสิ้นเชิง ภาพที่ 1: แนวทางการปัก Anchor หลักสามแบบ — แต่ละแบบมีพิสัยความแม่นยำและเงื่อนไขการใช้งานต่างกัน (ที่มา: Honey Corporation) สามแนวทางหลักในการปัก Anchor การเลือกเทคนิค Anchoring คือการชั่งน้ำหนักระหว่างความแม่นยำ ความทนทานต่อการเปลี่ยนแปลงสภาพแวดล้อม และต้นทุนการเตรียมหน้างาน ตารางนี้สรุปข้อตกลงหลักของแต่ละแนวทาง เทคนิค ความแม่นยำทั่วไป ต้องเตรียมอะไร ทน Layout เปลี่ยน เหมาะกับงาน Marker-basedประมาณ ±2–5 มม.ติดป้ายลายเฉพาะบนเครื่องจักรต่ำ (ย้ายป้าย = ต้องทำใหม่)จุดเช็คเฉพาะ เครื่องเดิมซ้ำๆ Markerless SLAMประมาณ ±1–3 ซม.สแกนพื้นที่ครั้งแรก (Depth Camera)ปานกลางพื้นที่กว้าง เดินสำรวจอิสระ Cloud Anchorขึ้นกับผู้ให้บริการ (ซม.ระดับ)เครือข่าย + การเชื่อมต่อบริการปานกลาง–สูงทีมหลายคนแชร์พิกัดร่วม Marker-based: แม่นที่สุด แต่เปราะที่สุด ป้ายลายเฉพาะ (Fiducial Marker) คือ "บัตรประชาชน" ของเครื่องจักรในโลก AR กล้องจับมุมและขนาดของป้าย แล้วคำนวณตำแหน่ง 6 องศาอิสระ (6-DoF) ได้ทันทีโดยไม่ต้องพึ่งพื้นที่รอบข้าง จุดอ่อนคือความเปราะ —…
Read More
Hardware-in-the-Loop (HIL): ทดสอบ PLC ของจริงบนโรงงานเสมือน ก่อนถึงวันเดินเครื่องจริง

Hardware-in-the-Loop (HIL): ทดสอบ PLC ของจริงบนโรงงานเสมือน ก่อนถึงวันเดินเครื่องจริง

Article
ทำไมสายการผลิตใหม่ถึงพังตอนเดินเครื่องครั้งแรก — ทั้งที่ PLC ผ่านการทดสอบมาแล้ว? คำถามนี้เราได้ยินจากหัวหน้าโรงงานหลายท่าน ทุกครั้งที่มีการติดตั้งสายการผลิตใหม่หรือทำ Major Upgrade ระบบควบคุม ทีม Automation ทดสอบ PLC Logic บน Desktop Simulation จนผ่านทุก Case แต่พอถึงวันเดินจริง ปัญหาก็ยังมาถึง: Sensor ที่ต่อสลับขั้ว, Noise บนสาย Analog, ค่า Scaling ผิด, หรือ Interlock ที่ทำงานตอนที่ไม่ควรทำงาน สาเหตุอยู่ที่ "ช่องว่าง" ระหว่างโลกจำลองกับโลกจริง Desktop Simulation ทดสอบแค่ Logic ภายในตัว PLC เท่านั้น แต่ไม่ได้ทดสอบ ตัวฮาร์ดแวร์จริงร่วมกับ พฤติกรรมจริงของเครื่องจักรพร้อมกัน วิธีแก้ที่อุตสาหกรรมยุโรปและอเมริกาใช้มานานกว่า 20 ปีคือ Hardware-in-the-Loop (HIL) Simulation — และตอนนี้กำลังกลายเป็นมาตรฐานใหม่ของการทำ Virtual Commissioning ในโรงงานเอเชียด้วยเช่นกัน HIL คืออะไร: เอาของจริงมาต่อกับโรงงานเสมือน หัวใจของ HIL นั้นเรียบง่าย: เอา ตัวควบคุมจริง (PLC, VFD, Motion Controller) มาวางบนโต๊ะทดสอบ แล้วต่อเข้ากับ Real-Time Simulator ที่รันโมเดลคณิตศาสตร์ของเครื่องจักรและกระบวนการผลิตทั้งสาย ตัว Simulator จะปลอมตัวเป็น "โรงงานเสมือน" ที่ส่งสัญญาณ Sensor กลับมาที่ PLC ผ่านทาง I/O จริง ทั้ง Analog 4–20 mA, Digital 24VDC, และโปรโตคอล Industrial Ethernet ตัวควบคุมจริง (PLC) คือองค์ประกอบ "Hardware" ใน Hardware-in-the-Loop — ภาพ: Wikimedia Commons สิ่งที่เกิดขึ้นคือ Closed Loop ที่สมบูรณ์: PLC สั่งปิดวาล์ว → Simulator คำนวณการไหลและแรงดันตาม Physics แล้วส่งค่า Sensor ใหม่กลับมา → PLC เห็นค่าเปลี่ยนแล้วตัดสินใจต่อ ทุกอย่างเกิดขึ้นแบบ Real-Time ในหน่วยมิลลิวินาที เหมือนเครื่องจักรจริงนั่นอยู่ตรงหน้า สถาปัตยกรรม 3 ส่วนของระบบ HIL องค์ประกอบ หน้าที่…
Read More
Case Study: โรงงานปุ๋ยทีม Operator ใหม่ทั้งหมด ทำไม Startup ครั้งแรกถึงราบรื่น — ด้วย Operator Training Simulator

Case Study: โรงงานปุ๋ยทีม Operator ใหม่ทั้งหมด ทำไม Startup ครั้งแรกถึงราบรื่น — ด้วย Operator Training Simulator

Article
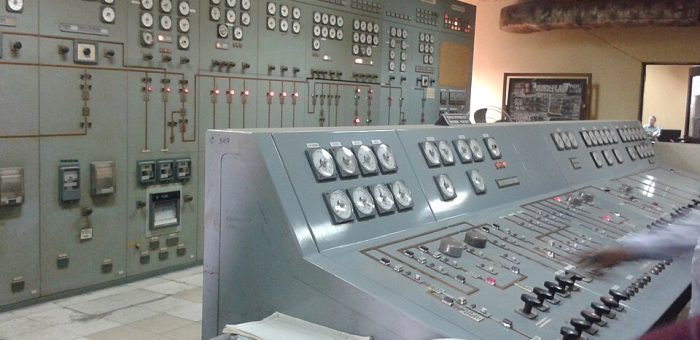
Case Study: โรงงานปุ๋ยแห่งใหม่ พนักงานเฉลี่ยอายุงาน 2 ปี — แล้ว Startup ครั้งแรกทำไมถึงสวยกว่าโรงงานเก่า? โรงงานปุ๋ยแห่งหนึ่งในเอเชียตะวันออกเฉียงใต้เพิ่งเริ่มเดินเครื่องจริงเมื่อไม่นานมานี้ สิ่งที่น่าสนใจคือทีม Operator ของพวกเขาเป็นทีม "หน้าใหม่" เกือบทั้งหมด — ประสบการณ์เฉลี่ยต่ำกว่าโรงงานทั่วไปอย่างเห็นได้ชัด เพราะโรงงานเพิ่งก่อตั้งและไม่มีทีมสืบทอดประสบการณ์จากรุ่นพี่ แต่ผลการเดินเครื่องครั้งแรกกลับราบรื่นกว่าที่คาด ความลับไม่ใช่เรื่องบุคลากรโชคดี แต่คือการตัดสินใจของฝ่ายบริหารที่ลงทุนกับสิ่งที่หลายโรงงานมองข้าม: Operator Training Simulator (OTS) หรือระบบจำลองโรงงานเพื่อการฝึกอบรม — ซึ่งเป็นอีกหน้าหนึ่งของ Digital Twin ที่คนมักลืม อุตสาหกรรม Process เช่น ปิโตรเคมีและปุ๋ยเคมี คือกลุ่มแรกๆ ที่ยอมรับ OTS — ภาพ: Wikimedia Commons โจทย์: เมื่อความรู้ของคนหายไปพร้อมกับคนรุ่นเก่า สถิติที่อุตสาหกรรมกระบวนการผลิต (Process Industry) ยอมรับกันคือ อุบัติเหตุราว 90–95% ของโรงงานมนุษย์เป็นสาเหตุ (ข้อมูลจากผู้ให้บริการ OTS ระดับโลกที่ติดตั้งไปแล้วมากกว่า 200 ระบบ) ปัจจัยทางมนุษย์ไม่ได้หมายถึงแค่ความประมาท แต่รวมถึงขาดประสบการณ์เผชิญสถานการณ์ผิดปกติ ไม่เคยเห็น Process Runaway ด้วยตาตัวเอง และไม่รู้ว่า Alarm ตัวไหน "ปกติ" ตัวไหน "ฉุกเฉิน" โรงงานใหม่ต้องเผชิญปัญหาซ้ำสอง: ไม่มีรุ่นพี่ถ่ายทอดประสบการณ์ และไม่มีข้อมูล Upset จริงจากเครื่องจักรของตัวเองให้เรียนรู้ การฝึกแบบ On-the-Job บนโรงงานที่เพิ่งเดินเครื่องจึงเป็นการเสี่ยงสองตลบ — ทั้งเสี่ยงต่อคนและเสี่ยงต่อเครื่องจักรมูลค่าหลายร้อยล้าน ทางแก้: โรงงานเสมือนที่ผิดพลาดได้ 100 ครั้งโดยไม่มีใครบาดเจ็บ OTS ที่ดีไม่ใช่แค่หน้าจอจำลอง HMI แต่ประกอบด้วย 3 ส่วนที่ต้องทำงานร่วมกัน: Dynamic Process Model — โมเดล Thermodynamic และ Fluid Flow จาก First Principles ที่ตอบสนองเหมือนโรงงานจริง เมื่อ Operator เปิดวาล์วเพิ่ม ค่าน้ำหนักก้อนเปลี่ยน อุณหภูมิขึ้น แรงดันตาม ด้วย Lag และ Cascade Effect เหมือนของจริง (โมเดลระดับสูงในตลาดทำได้ใกล้เคียงข้อมูลจริงภายใน ±2%) DCS/SIS Emulation — หน้าจอและ Logic เหมือนระบบควบคุมที่ใช้จริง ทำให้กล้ามเนื้อความจำ (Muscle Memory) ของ Operator ทำงานเหมือนนั่งอยู่หน้า Console จริง…
Read More
Agent-Based Simulation และ Knowledge Graph: เมื่อ Digital Twin เลิกรอคำสั่ง แล้วให้ทุกเครื่องจักรคิดเอง

Agent-Based Simulation และ Knowledge Graph: เมื่อ Digital Twin เลิกรอคำสั่ง แล้วให้ทุกเครื่องจักรคิดเอง

Article
เมื่อ Digital Twin เลิกเป็น "หุ่นยนต์เดินตามคำสั่ง": ทำไม Simulation ยุคใหม่ต้องให้ทุกเครื่องจักร "คิดเอง" ถ้าถามว่า Digital Twin คืออะไร คำตอบส่วนใหญ่คือ "โมเดลจำลองโรงงานที่ซิงก์ข้อมูล Real-Time" คำตอบนั้นถูกต้อง — แต่ไม่เพียงพออีกต่อไปแล้ว ปัญหาของ Twin แบบดั้งเดิมคือมันเป็น โมเดลเดี่ยวที่ต้องรอคนสั่ง: อยากรู้ว่าถ้าเพิ่มความเร็วคอนเวเยอร์ 15% จะเกิดอะไรขึ้น ต้องมีวิศวกรมานั่งตั้งค่า รัน What-If แล้วรอผล แนวโน้มใหม่ที่งานวิจัยระดับโลกกำลังพิสูจน์คือการผสาน Agent-Based Simulation (ABS) เข้ากับ Digital Twin — แทนที่จะสร้างโมเดลใหญ่หนึ่งเดียวที่คำนวณทุกอย่างพร้อมกัน ให้แต่ละองค์ประกอบในโรงงาน (เครื่องจักร, AGV, คนงาน, คลังสินค้า) กลายเป็น "เอเจนต์" ที่มีกฎการตัดสินใจของตัวเอง แล้วปล่อยให้พวกมันโต้ตอบกันเอง เหมือนโรงงานจริงที่ไม่มีใครสั่งการทุกจุด ระบบผลิตที่ซับซ้อน มีพฤติกรรม "อุบัติเหตุ" ที่ไม่มีสมการใดพรรณนาได้ — ภาพ: Wikimedia Commons สิ่งที่สมการเดี่ยวทำไม่ได้: Emergent Behavior จุดขายที่แท้จริงของ Agent-Based Simulation คือการจับ Emergent Behavior — พฤติกรรมที่เกิดขึ้นจากการโต้ตอบของส่วนย่อยจำนวนมาก แต่ไม่สามารถคาดเดาได้จากการดูส่วนย่อยแต่ละชิ้นแยกกัน ตัวอย่างคลาสสิกในโรงงาน: Deadlock ที่คลังสินค้า — AGV 8 คันไม่มีคันไหนผิดกติกา แต่ลำดับการเข้า-ออกของทั้งระบบในวันที่ Order เยอะทำให้ติดกับแก่นกันเอง คอขวดที่เคลื่อนตำแหน่ง — Buffer หน้าเครื่องจักรเครื่องหนึ่งเต็มทุกวัน เมื่อเพิ่มกำลังเครื่องนั้น คอขวดกลับไปโผล่ที่จุดที่ไม่มีใครคาดคิด ผลกระทบลูกโซ่ของ Breakdown — เครื่องหนึ่งหยุด 30 นาที ทำไม WIP ในส่วนอื่นของโรงงานแทบไม่ขยับ แต่บางครั้งหยุดแค่ 10 นาทีกลับสร้างความปั่นป่วนทั้งกะ ปรากฏการณ์เหล่านี้เกิดจาก ความแปรปรวนทางสถิติ (Stochastic Variability) ของเวลาทำงาน เวลารอ และลำดับเหตุการณ์ — สิ่งที่ Discrete-Event Simulation แบบดั้งเดิมจำลองได้ระดับหนึ่ง แต่การเพิ่ม "ตัวตนและกฎการตัดสินใจ" ให้แต่ละเอเจนต์ทำให้โมเดลสะท้อนความจริงได้ลึกกว่า โดยเฉพาะเมื่อมีคนและระบบอัตโนมัติทำงานปนกัน หลักฐานจากงานวิจัย: โมเดล 3 ชั้น + Knowledge Graph งานวิจัยที่ตีพิมพ์ในวารสาร Scientific Reports (2025) ได้สาธิตแนวทางนี้ด้วยสถาปัตยกรรมที่น่าสนใจ: แทนที่จะปล่อยให้เอเจนต์ "คิดเองเลือกอะไรก็ได้" พวกเขาคุมโครงสร้างความรู้ด้วย Knowledge Graph…
Read More
บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

Article
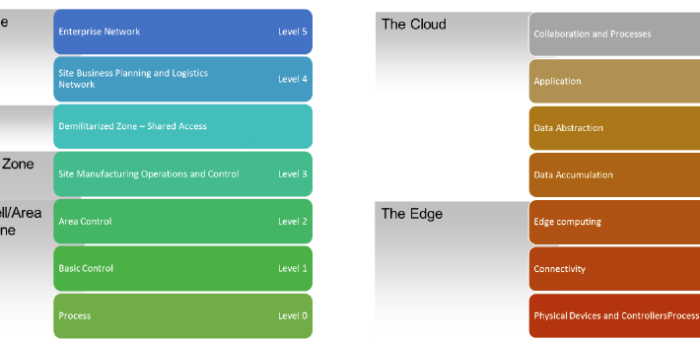
ช่วงสองสามปีที่ผ่านมา วิศวกรโรงงานไทยหลายท่านน่าจะเจอบทสนทนาแบบนี้: "เราควรเอาขึ้นคลาวด์หรือทำ edge ก่อน" คำถามดูเหมือนมีเหตุผล แต่ถ้าดูตัวเลขตลาดล่าสุดแล้ว จะพบว่านี่คือกรอบคิดที่กำลังล้าสมัย เพราะโลกไม่ได้กำลังเลือกระหว่างสองฝั่ง แต่กำลังเติบโต ทั้งสองฝั่งพร้อมกันอย่างก้าวกระโดด ตัวเลขที่ต้องรู้ก่อนตัดสินใจ รายงานล่าสุดของ Grand View Research ระบุว่าตลาด Edge Computing โลกมีมูลค่า 33.4 พันล้านดอลลาร์ในปี 2025 และประมาณการไว้ที่ 46.7 พันล้านดอลลาร์ในปี 2026 ก่อนจะขยายต่อไปถึง 328 พันล้านดอลลาร์ภายในปี 2033 คิดเป็น CAGR 32.1% ตลอดช่วง 2026–2033 — นี่คืออัตราเติบโตที่เร็วกว่าภาพรวมของ smart manufacturing ที่ IoT Analytics ประเมินไว้ที่ CAGR 9.3% (จาก 175 พันล้านดอลลาร์ในปี 2025 สู่ 274 พันล้านดอลลาร์ในปี 2030) ถึงสามเท่าครึ่ง ทำไมถึงเร็วขนาดนั้น? เพราะ edge ไม่ได้แข่งกับคลาวด์ แต่กำลัง เปิดกล่อง use case ใหม่ที่คลาวด์ทำไม่ได้ และเอเชียแปซิฟิกคือภูมิภาคที่โตเร็วที่สุด — Grand View Research ระบุ CAGR ของภูมิภาคเราที่ราว 39% สูงกว่าค่าเฉลี่ยโลก ซึ่งสอดคล้องกับการลงทุน infrastructure ดิจิทัลของไทยในช่วงนี้ Purdue Reference Model เทียบกับ IoT Reference Model — โครงสร้างระดับโรงงานกับระดับคลาวด์กำลังถูกออกแบบให้ทำงานร่วมกัน ไม่ใช่แยกกัน — ภาพ: Wikimedia Commons (CC BY-SA 4.0) คำถามที่ถูกต้อง: Workload นี้ควรอยู่ที่ไหน แทนที่จะถามว่า "เอาขึ้นคลาวด์หรือ edge" ให้ถามว่า "workload นี้มีคุณสมบัติอะไร" แล้วให้คุณสมบัตินั้นตัดสินใจแทน โดยเฉพาะสี่มิติที่ตัดสินได้ชัดเจนที่สุด: มิติการตัดสินใจ ชี้ไปทาง Edge ชี้ไปทาง Cloud Latency ที่ยอมรับได้ ต่ำกว่า ~50 ms เช่น interlock, หยุดเครื่องฉุกเฉิน วินาทีถึงนาที เช่น dashboard, รายงานรายเดือน ปริมาณข้อมูล สูงมากต่อวินาที (vibration 10 kHz, วิดีโอ 30 fps)…
Read More
Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Article
เรื่องนี้เล่าถึงโรงงานอาหารแห่งหนึ่งในนิคมอุตสาหกรรมภาคตะวันออก ที่เดิมใช้เกตเวย์ IoT แบบ standalone จำนวน 24 ตัวกระจายอยู่ทุกสายการผลิต แต่ละตัวเก็บค่าอุณหภูมิห้องเย็น ความชื้น และสถานะเครื่องจักร แล้วส่งขึ้นคลาวด์ผ่าน MQTT ทุกอย่างทำงานได้ดี... จนกระทั่งคืนหนึ่งที่เกตเวย์ตัวหนึ่งหยุดทำงานเพราะการ์ดหน่วยความจำเสีย และไม่มีใครรู้ตัวจนกระทั่งเช้าวันรุ่งขึ้น ข้อมูลห้องเย็นหายไป 7 ชั่วโมงเต็ม ซึ่งในธุรกิจอาหารแปลว่าต้องเขียนรายงานเหตุการณ์ deviation ยาวเหยียด และต้องประเมินความเสี่ยงต่อสินค้าที่เก็บในช่วงเวลานั้น ปัญหา: ความล้มเหลวแบบเงียบ (Silent Failure) การตรวจสอบย้อนหลังพบว่าปัญหาไม่ได้อยู่ที่ตัวเกตเวย์ แต่อยู่ที่สถาปัตยกรรม ระบบเดิมไม่มีกลไกใดตรวจจับว่าเกตเวย์ "ยังมีชีวิต" หรือไม่ และเมื่อเกตเวย์หนึ่งตัวตาย ก็ไม่มีตัวไหนรับหน้าที่แทน ทีมวิศวกรรมจึงเสนอแนวคิดที่ตอนนั้นดูเกินจำเป็นสำหรับโรงงานอาหาร นั่นคือการนำ container orchestration แบบ Kubernetes รุ่นเบา ลงมาวางที่ระดับสายการผลิต — ไม่ใช่เพื่อความสวยงามทางเทคนิค แต่เพื่อให้ได้สามอย่าง: self-healing, declarative configuration และ rollback ที่ทำได้ในไม่กี่วินาที การวางโหนด Edge หลายชั้นให้ครอบคลุมทุกสายการผลิต คือฐานของ orchestration แบบกระจาย — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทางออก: Single-node Cluster ที่ทุกสายการผลิต แนวทางที่เลือกไม่ใช่คลัสเตอร์กลางขนาดใหญ่ แต่เป็น คลัสเตอร์เล็กๆ อยู่กับสายการผลิต แต่ละสายมี industrial computer ตั้งแต่ 2 โหนดขึ้นไป รัน Kubernetes distribution แบบ lightweight ที่ตัดส่วนประกอบที่ไม่จำเป็นออก ตัว workload หลักมีสามชนิด: Collector — อ่านค่าจาก PLC ผ่าน OPC UA และเซ็นเซอร์ผ่าน Modbus TCP เขียนลง local time-series storage Rule engine — ประเมินเงื่อนไข alarm เช่น อุณหภูมิห้องเย็นเกิน -18°C นานเกิน 10 นาที แล้วส่งแจ้งเตือนผ่านหลายช่องทาง Forwarder — ส่งข้อมูลแบบ batch ขึ้นคลาวด์ พร้อม store-and-forward เมื่อลิงก์หลุด จุดเปลี่ยนที่สำคัญคือการตั้งค่า liveness/readiness probe ให้กับทุก workload — collector ที่ค้างไม่อ่านค่า PLC…
Read More
Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Article
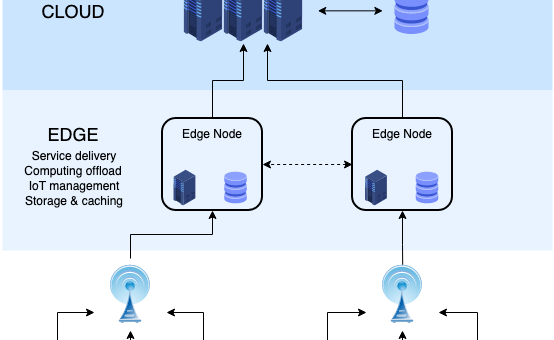
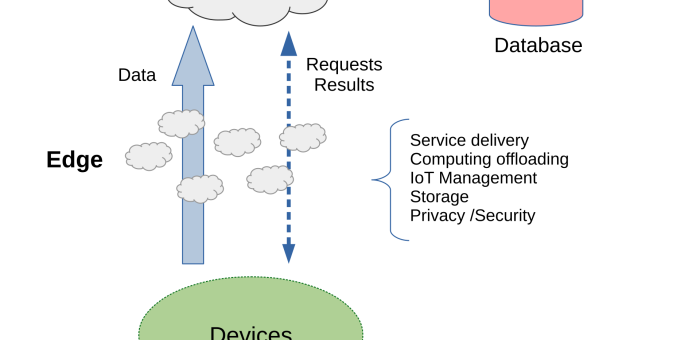
หลายโรงงานในไทยวางแผนธุรกิจดิจิทัลของตัวเองแบบสองขั้ว คือมีอุปกรณ์ IoT และ PLC อยู่ปลายทาง แล้วส่งข้อมูลขึ้นคลาวด์เพื่อประมวลผลทั้งหมด แต่เมื่อปริมาณข้อมูลเพิ่มขึ้นเป็นสิบเท่า และ AI เริ่มถูกใช้ตัดสินใจแบบเรียลไทม์บนพื้นโรงงาน สถาปัตยกรรมแบบสองขั้วนี้ก็เริ่มสะดุด คำตอบที่ถูกที่สุดไม่ใช่การย้ายทุกอย่างกลับมาอยู่ในโรงงาน แต่คือการเพิ่ม ชั้นคำนวณระหว่างกลาง ที่เรียกว่า Fog Computing ซึ่งกำลังกลับมาเป็นที่พูดถึงอีกครั้งในวงการอุตสาหกรรมปี 2026 สถาปัตยกรรมการคำนวณแบบไล่ระดับ ตั้งแต่อุปกรณ์ปลายทาง (Things) ผ่านชั้น Edge/Fog ขึ้นไปถึงคลาวด์ — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทำไมสองขั้วไม่พออีกต่อไป ลองนึกภาพสายการผลิตที่มีกล้องตรวจคุณภาพ 16 ตัว ส่งภาพความละเอียดสูงกลับคลาวด์เพื่อรันโมเดล Computer Vision ที่ 30 เฟรมต่อวินาที เสียงวิเคราะห์คลื่นเสียงเครื่องจักร และข้อมูล vibration ที่สุ่มที่ 10 kHz — แบนด์วิดท์ที่ต้องใช้ไม่ใช่แค่ "เยอะ" แต่แพงและเปราะ ถ้าเน็ตหลุดแม้เพียง 30 วินาที งานตรวจคุณภาพช่วงนั้นก็หายไปตลอดกาล ในทางกลับกัน การเอาทุกอย่างมาไว้ในเซิร์ฟเวอร์กลางในโรงงานล้มเหลวในอีกแบบ ทีม IT ต้องดูแลฮาร์ดแวร์ ทำ backup อัปเดต patch และขยายระบบทุกครั้งที่เพิ่มสายการผลิต Fog Computing เสนอทางที่สาม — กระจายการคำนวณลงไปในหลายๆ โหนดที่อยู่ใกล้แหล่งข้อมูล แต่ยังจัดการแบบรวมศูนย์ ตามแนวคิดที่ OpenFog Consortium (ซึ่งต่อมาควบรวมเข้ากับ Linux Foundation Edge) เคยสรุปไว้ใน Reference Architecture ว่าต้องมีคุณสมบัติ 8 ด้าน ตั้งแต่ Security, Scalability, Openness, Autonomy, Manageability, Agility, Hierarchical Organization ไปจนถึง Programmability ข้อกำหนดทางเทคนิคที่ต้องรู้ก่อนออกแบบ ประเด็นออกแบบ โจทย์จริงในโรงงาน แนวทาง Fog Latency budget ปิดสวิตช์ฉุกเฉินภายใน 10–50 ms หลังตรวจพบความผิดปกติ ประมวลผลและตัดสินใจที่โหนด Fog ในสายการผลิต ไม่รอ round-trip ไปคลาวด์ แบนด์วิดท์ กล้องตรวจคุณภาพ 16 ตัว ที่ 30 fps กินลิงก์ WAN เกินกว่าที่ลิงก์สำรองจะรับไหว สกัดเฉพาะผลลัพธ์และภาพที่พบ defect ขึ้นคลาวด์ ลดปริมาณข้อมูลขาออกได้ 90%…
Read More