Hardware-in-the-Loop (HIL): ทดสอบ PLC ของจริงบนโรงงานเสมือน ก่อนถึงวันเดินเครื่องจริง

Hardware-in-the-Loop (HIL): ทดสอบ PLC ของจริงบนโรงงานเสมือน ก่อนถึงวันเดินเครื่องจริง

Article
ทำไมสายการผลิตใหม่ถึงพังตอนเดินเครื่องครั้งแรก — ทั้งที่ PLC ผ่านการทดสอบมาแล้ว? คำถามนี้เราได้ยินจากหัวหน้าโรงงานหลายท่าน ทุกครั้งที่มีการติดตั้งสายการผลิตใหม่หรือทำ Major Upgrade ระบบควบคุม ทีม Automation ทดสอบ PLC Logic บน Desktop Simulation จนผ่านทุก Case แต่พอถึงวันเดินจริง ปัญหาก็ยังมาถึง: Sensor ที่ต่อสลับขั้ว, Noise บนสาย Analog, ค่า Scaling ผิด, หรือ Interlock ที่ทำงานตอนที่ไม่ควรทำงาน สาเหตุอยู่ที่ "ช่องว่าง" ระหว่างโลกจำลองกับโลกจริง Desktop Simulation ทดสอบแค่ Logic ภายในตัว PLC เท่านั้น แต่ไม่ได้ทดสอบ ตัวฮาร์ดแวร์จริงร่วมกับ พฤติกรรมจริงของเครื่องจักรพร้อมกัน วิธีแก้ที่อุตสาหกรรมยุโรปและอเมริกาใช้มานานกว่า 20 ปีคือ Hardware-in-the-Loop (HIL) Simulation — และตอนนี้กำลังกลายเป็นมาตรฐานใหม่ของการทำ Virtual Commissioning ในโรงงานเอเชียด้วยเช่นกัน HIL คืออะไร: เอาของจริงมาต่อกับโรงงานเสมือน หัวใจของ HIL นั้นเรียบง่าย: เอา ตัวควบคุมจริง (PLC, VFD, Motion Controller) มาวางบนโต๊ะทดสอบ แล้วต่อเข้ากับ Real-Time Simulator ที่รันโมเดลคณิตศาสตร์ของเครื่องจักรและกระบวนการผลิตทั้งสาย ตัว Simulator จะปลอมตัวเป็น "โรงงานเสมือน" ที่ส่งสัญญาณ Sensor กลับมาที่ PLC ผ่านทาง I/O จริง ทั้ง Analog 4–20 mA, Digital 24VDC, และโปรโตคอล Industrial Ethernet ตัวควบคุมจริง (PLC) คือองค์ประกอบ "Hardware" ใน Hardware-in-the-Loop — ภาพ: Wikimedia Commons สิ่งที่เกิดขึ้นคือ Closed Loop ที่สมบูรณ์: PLC สั่งปิดวาล์ว → Simulator คำนวณการไหลและแรงดันตาม Physics แล้วส่งค่า Sensor ใหม่กลับมา → PLC เห็นค่าเปลี่ยนแล้วตัดสินใจต่อ ทุกอย่างเกิดขึ้นแบบ Real-Time ในหน่วยมิลลิวินาที เหมือนเครื่องจักรจริงนั่นอยู่ตรงหน้า สถาปัตยกรรม 3 ส่วนของระบบ HIL องค์ประกอบ หน้าที่…
Read More
Case Study: โรงงานปุ๋ยทีม Operator ใหม่ทั้งหมด ทำไม Startup ครั้งแรกถึงราบรื่น — ด้วย Operator Training Simulator

Case Study: โรงงานปุ๋ยทีม Operator ใหม่ทั้งหมด ทำไม Startup ครั้งแรกถึงราบรื่น — ด้วย Operator Training Simulator

Article
Case Study: โรงงานปุ๋ยแห่งใหม่ พนักงานเฉลี่ยอายุงาน 2 ปี — แล้ว Startup ครั้งแรกทำไมถึงสวยกว่าโรงงานเก่า? โรงงานปุ๋ยแห่งหนึ่งในเอเชียตะวันออกเฉียงใต้เพิ่งเริ่มเดินเครื่องจริงเมื่อไม่นานมานี้ สิ่งที่น่าสนใจคือทีม Operator ของพวกเขาเป็นทีม "หน้าใหม่" เกือบทั้งหมด — ประสบการณ์เฉลี่ยต่ำกว่าโรงงานทั่วไปอย่างเห็นได้ชัด เพราะโรงงานเพิ่งก่อตั้งและไม่มีทีมสืบทอดประสบการณ์จากรุ่นพี่ แต่ผลการเดินเครื่องครั้งแรกกลับราบรื่นกว่าที่คาด ความลับไม่ใช่เรื่องบุคลากรโชคดี แต่คือการตัดสินใจของฝ่ายบริหารที่ลงทุนกับสิ่งที่หลายโรงงานมองข้าม: Operator Training Simulator (OTS) หรือระบบจำลองโรงงานเพื่อการฝึกอบรม — ซึ่งเป็นอีกหน้าหนึ่งของ Digital Twin ที่คนมักลืม อุตสาหกรรม Process เช่น ปิโตรเคมีและปุ๋ยเคมี คือกลุ่มแรกๆ ที่ยอมรับ OTS — ภาพ: Wikimedia Commons โจทย์: เมื่อความรู้ของคนหายไปพร้อมกับคนรุ่นเก่า สถิติที่อุตสาหกรรมกระบวนการผลิต (Process Industry) ยอมรับกันคือ อุบัติเหตุราว 90–95% ของโรงงานมนุษย์เป็นสาเหตุ (ข้อมูลจากผู้ให้บริการ OTS ระดับโลกที่ติดตั้งไปแล้วมากกว่า 200 ระบบ) ปัจจัยทางมนุษย์ไม่ได้หมายถึงแค่ความประมาท แต่รวมถึงขาดประสบการณ์เผชิญสถานการณ์ผิดปกติ ไม่เคยเห็น Process Runaway ด้วยตาตัวเอง และไม่รู้ว่า Alarm ตัวไหน "ปกติ" ตัวไหน "ฉุกเฉิน" โรงงานใหม่ต้องเผชิญปัญหาซ้ำสอง: ไม่มีรุ่นพี่ถ่ายทอดประสบการณ์ และไม่มีข้อมูล Upset จริงจากเครื่องจักรของตัวเองให้เรียนรู้ การฝึกแบบ On-the-Job บนโรงงานที่เพิ่งเดินเครื่องจึงเป็นการเสี่ยงสองตลบ — ทั้งเสี่ยงต่อคนและเสี่ยงต่อเครื่องจักรมูลค่าหลายร้อยล้าน ทางแก้: โรงงานเสมือนที่ผิดพลาดได้ 100 ครั้งโดยไม่มีใครบาดเจ็บ OTS ที่ดีไม่ใช่แค่หน้าจอจำลอง HMI แต่ประกอบด้วย 3 ส่วนที่ต้องทำงานร่วมกัน: Dynamic Process Model — โมเดล Thermodynamic และ Fluid Flow จาก First Principles ที่ตอบสนองเหมือนโรงงานจริง เมื่อ Operator เปิดวาล์วเพิ่ม ค่าน้ำหนักก้อนเปลี่ยน อุณหภูมิขึ้น แรงดันตาม ด้วย Lag และ Cascade Effect เหมือนของจริง (โมเดลระดับสูงในตลาดทำได้ใกล้เคียงข้อมูลจริงภายใน ±2%) DCS/SIS Emulation — หน้าจอและ Logic เหมือนระบบควบคุมที่ใช้จริง ทำให้กล้ามเนื้อความจำ (Muscle Memory) ของ Operator ทำงานเหมือนนั่งอยู่หน้า Console จริง…
Read More
Agent-Based Simulation และ Knowledge Graph: เมื่อ Digital Twin เลิกรอคำสั่ง แล้วให้ทุกเครื่องจักรคิดเอง

Agent-Based Simulation และ Knowledge Graph: เมื่อ Digital Twin เลิกรอคำสั่ง แล้วให้ทุกเครื่องจักรคิดเอง

Article
เมื่อ Digital Twin เลิกเป็น "หุ่นยนต์เดินตามคำสั่ง": ทำไม Simulation ยุคใหม่ต้องให้ทุกเครื่องจักร "คิดเอง" ถ้าถามว่า Digital Twin คืออะไร คำตอบส่วนใหญ่คือ "โมเดลจำลองโรงงานที่ซิงก์ข้อมูล Real-Time" คำตอบนั้นถูกต้อง — แต่ไม่เพียงพออีกต่อไปแล้ว ปัญหาของ Twin แบบดั้งเดิมคือมันเป็น โมเดลเดี่ยวที่ต้องรอคนสั่ง: อยากรู้ว่าถ้าเพิ่มความเร็วคอนเวเยอร์ 15% จะเกิดอะไรขึ้น ต้องมีวิศวกรมานั่งตั้งค่า รัน What-If แล้วรอผล แนวโน้มใหม่ที่งานวิจัยระดับโลกกำลังพิสูจน์คือการผสาน Agent-Based Simulation (ABS) เข้ากับ Digital Twin — แทนที่จะสร้างโมเดลใหญ่หนึ่งเดียวที่คำนวณทุกอย่างพร้อมกัน ให้แต่ละองค์ประกอบในโรงงาน (เครื่องจักร, AGV, คนงาน, คลังสินค้า) กลายเป็น "เอเจนต์" ที่มีกฎการตัดสินใจของตัวเอง แล้วปล่อยให้พวกมันโต้ตอบกันเอง เหมือนโรงงานจริงที่ไม่มีใครสั่งการทุกจุด ระบบผลิตที่ซับซ้อน มีพฤติกรรม "อุบัติเหตุ" ที่ไม่มีสมการใดพรรณนาได้ — ภาพ: Wikimedia Commons สิ่งที่สมการเดี่ยวทำไม่ได้: Emergent Behavior จุดขายที่แท้จริงของ Agent-Based Simulation คือการจับ Emergent Behavior — พฤติกรรมที่เกิดขึ้นจากการโต้ตอบของส่วนย่อยจำนวนมาก แต่ไม่สามารถคาดเดาได้จากการดูส่วนย่อยแต่ละชิ้นแยกกัน ตัวอย่างคลาสสิกในโรงงาน: Deadlock ที่คลังสินค้า — AGV 8 คันไม่มีคันไหนผิดกติกา แต่ลำดับการเข้า-ออกของทั้งระบบในวันที่ Order เยอะทำให้ติดกับแก่นกันเอง คอขวดที่เคลื่อนตำแหน่ง — Buffer หน้าเครื่องจักรเครื่องหนึ่งเต็มทุกวัน เมื่อเพิ่มกำลังเครื่องนั้น คอขวดกลับไปโผล่ที่จุดที่ไม่มีใครคาดคิด ผลกระทบลูกโซ่ของ Breakdown — เครื่องหนึ่งหยุด 30 นาที ทำไม WIP ในส่วนอื่นของโรงงานแทบไม่ขยับ แต่บางครั้งหยุดแค่ 10 นาทีกลับสร้างความปั่นป่วนทั้งกะ ปรากฏการณ์เหล่านี้เกิดจาก ความแปรปรวนทางสถิติ (Stochastic Variability) ของเวลาทำงาน เวลารอ และลำดับเหตุการณ์ — สิ่งที่ Discrete-Event Simulation แบบดั้งเดิมจำลองได้ระดับหนึ่ง แต่การเพิ่ม "ตัวตนและกฎการตัดสินใจ" ให้แต่ละเอเจนต์ทำให้โมเดลสะท้อนความจริงได้ลึกกว่า โดยเฉพาะเมื่อมีคนและระบบอัตโนมัติทำงานปนกัน หลักฐานจากงานวิจัย: โมเดล 3 ชั้น + Knowledge Graph งานวิจัยที่ตีพิมพ์ในวารสาร Scientific Reports (2025) ได้สาธิตแนวทางนี้ด้วยสถาปัตยกรรมที่น่าสนใจ: แทนที่จะปล่อยให้เอเจนต์ "คิดเองเลือกอะไรก็ได้" พวกเขาคุมโครงสร้างความรู้ด้วย Knowledge Graph…
Read More
บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

บทวิเคราะห์: Edge หรือ Cloud — ตัวเลขตลาดบอกว่าคำถามนี้ผิดตั้งแต่ต้น (และโรงงานควรถามอะไรแทน)

Article
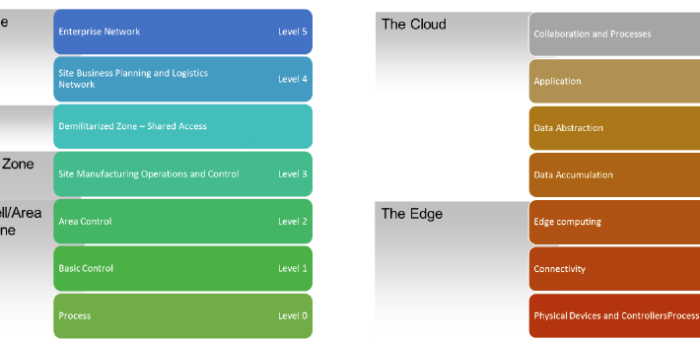
ช่วงสองสามปีที่ผ่านมา วิศวกรโรงงานไทยหลายท่านน่าจะเจอบทสนทนาแบบนี้: "เราควรเอาขึ้นคลาวด์หรือทำ edge ก่อน" คำถามดูเหมือนมีเหตุผล แต่ถ้าดูตัวเลขตลาดล่าสุดแล้ว จะพบว่านี่คือกรอบคิดที่กำลังล้าสมัย เพราะโลกไม่ได้กำลังเลือกระหว่างสองฝั่ง แต่กำลังเติบโต ทั้งสองฝั่งพร้อมกันอย่างก้าวกระโดด ตัวเลขที่ต้องรู้ก่อนตัดสินใจ รายงานล่าสุดของ Grand View Research ระบุว่าตลาด Edge Computing โลกมีมูลค่า 33.4 พันล้านดอลลาร์ในปี 2025 และประมาณการไว้ที่ 46.7 พันล้านดอลลาร์ในปี 2026 ก่อนจะขยายต่อไปถึง 328 พันล้านดอลลาร์ภายในปี 2033 คิดเป็น CAGR 32.1% ตลอดช่วง 2026–2033 — นี่คืออัตราเติบโตที่เร็วกว่าภาพรวมของ smart manufacturing ที่ IoT Analytics ประเมินไว้ที่ CAGR 9.3% (จาก 175 พันล้านดอลลาร์ในปี 2025 สู่ 274 พันล้านดอลลาร์ในปี 2030) ถึงสามเท่าครึ่ง ทำไมถึงเร็วขนาดนั้น? เพราะ edge ไม่ได้แข่งกับคลาวด์ แต่กำลัง เปิดกล่อง use case ใหม่ที่คลาวด์ทำไม่ได้ และเอเชียแปซิฟิกคือภูมิภาคที่โตเร็วที่สุด — Grand View Research ระบุ CAGR ของภูมิภาคเราที่ราว 39% สูงกว่าค่าเฉลี่ยโลก ซึ่งสอดคล้องกับการลงทุน infrastructure ดิจิทัลของไทยในช่วงนี้ Purdue Reference Model เทียบกับ IoT Reference Model — โครงสร้างระดับโรงงานกับระดับคลาวด์กำลังถูกออกแบบให้ทำงานร่วมกัน ไม่ใช่แยกกัน — ภาพ: Wikimedia Commons (CC BY-SA 4.0) คำถามที่ถูกต้อง: Workload นี้ควรอยู่ที่ไหน แทนที่จะถามว่า "เอาขึ้นคลาวด์หรือ edge" ให้ถามว่า "workload นี้มีคุณสมบัติอะไร" แล้วให้คุณสมบัตินั้นตัดสินใจแทน โดยเฉพาะสี่มิติที่ตัดสินได้ชัดเจนที่สุด: มิติการตัดสินใจ ชี้ไปทาง Edge ชี้ไปทาง Cloud Latency ที่ยอมรับได้ ต่ำกว่า ~50 ms เช่น interlock, หยุดเครื่องฉุกเฉิน วินาทีถึงนาที เช่น dashboard, รายงานรายเดือน ปริมาณข้อมูล สูงมากต่อวินาที (vibration 10 kHz, วิดีโอ 30 fps)…
Read More
Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Case Study: โรงงานอาหาร ‘เสียเครื่อง Edge ตอนตี 2’ — บทเรียนจากการย้าย Orchestration ลงสู่ระดับสายการผลิตด้วย Kubernetes แบบ Lightweight

Article
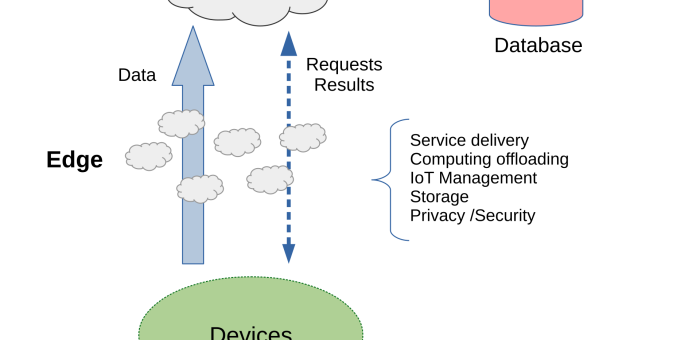
เรื่องนี้เล่าถึงโรงงานอาหารแห่งหนึ่งในนิคมอุตสาหกรรมภาคตะวันออก ที่เดิมใช้เกตเวย์ IoT แบบ standalone จำนวน 24 ตัวกระจายอยู่ทุกสายการผลิต แต่ละตัวเก็บค่าอุณหภูมิห้องเย็น ความชื้น และสถานะเครื่องจักร แล้วส่งขึ้นคลาวด์ผ่าน MQTT ทุกอย่างทำงานได้ดี... จนกระทั่งคืนหนึ่งที่เกตเวย์ตัวหนึ่งหยุดทำงานเพราะการ์ดหน่วยความจำเสีย และไม่มีใครรู้ตัวจนกระทั่งเช้าวันรุ่งขึ้น ข้อมูลห้องเย็นหายไป 7 ชั่วโมงเต็ม ซึ่งในธุรกิจอาหารแปลว่าต้องเขียนรายงานเหตุการณ์ deviation ยาวเหยียด และต้องประเมินความเสี่ยงต่อสินค้าที่เก็บในช่วงเวลานั้น ปัญหา: ความล้มเหลวแบบเงียบ (Silent Failure) การตรวจสอบย้อนหลังพบว่าปัญหาไม่ได้อยู่ที่ตัวเกตเวย์ แต่อยู่ที่สถาปัตยกรรม ระบบเดิมไม่มีกลไกใดตรวจจับว่าเกตเวย์ "ยังมีชีวิต" หรือไม่ และเมื่อเกตเวย์หนึ่งตัวตาย ก็ไม่มีตัวไหนรับหน้าที่แทน ทีมวิศวกรรมจึงเสนอแนวคิดที่ตอนนั้นดูเกินจำเป็นสำหรับโรงงานอาหาร นั่นคือการนำ container orchestration แบบ Kubernetes รุ่นเบา ลงมาวางที่ระดับสายการผลิต — ไม่ใช่เพื่อความสวยงามทางเทคนิค แต่เพื่อให้ได้สามอย่าง: self-healing, declarative configuration และ rollback ที่ทำได้ในไม่กี่วินาที การวางโหนด Edge หลายชั้นให้ครอบคลุมทุกสายการผลิต คือฐานของ orchestration แบบกระจาย — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทางออก: Single-node Cluster ที่ทุกสายการผลิต แนวทางที่เลือกไม่ใช่คลัสเตอร์กลางขนาดใหญ่ แต่เป็น คลัสเตอร์เล็กๆ อยู่กับสายการผลิต แต่ละสายมี industrial computer ตั้งแต่ 2 โหนดขึ้นไป รัน Kubernetes distribution แบบ lightweight ที่ตัดส่วนประกอบที่ไม่จำเป็นออก ตัว workload หลักมีสามชนิด: Collector — อ่านค่าจาก PLC ผ่าน OPC UA และเซ็นเซอร์ผ่าน Modbus TCP เขียนลง local time-series storage Rule engine — ประเมินเงื่อนไข alarm เช่น อุณหภูมิห้องเย็นเกิน -18°C นานเกิน 10 นาที แล้วส่งแจ้งเตือนผ่านหลายช่องทาง Forwarder — ส่งข้อมูลแบบ batch ขึ้นคลาวด์ พร้อม store-and-forward เมื่อลิงก์หลุด จุดเปลี่ยนที่สำคัญคือการตั้งค่า liveness/readiness probe ให้กับทุก workload — collector ที่ค้างไม่อ่านค่า PLC…
Read More
Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Fog Computing กลับมาเป็นข่าวอีกครั้ง: ชั้นคำนวณที่โรงงานไทยมองข้ามไป กำลังกลายเป็นหัวใจของ IIoT ยุค Edge AI

Article
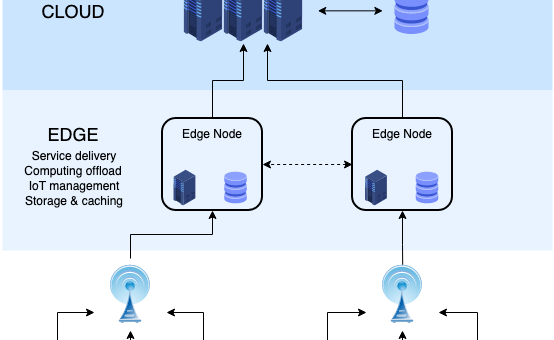
หลายโรงงานในไทยวางแผนธุรกิจดิจิทัลของตัวเองแบบสองขั้ว คือมีอุปกรณ์ IoT และ PLC อยู่ปลายทาง แล้วส่งข้อมูลขึ้นคลาวด์เพื่อประมวลผลทั้งหมด แต่เมื่อปริมาณข้อมูลเพิ่มขึ้นเป็นสิบเท่า และ AI เริ่มถูกใช้ตัดสินใจแบบเรียลไทม์บนพื้นโรงงาน สถาปัตยกรรมแบบสองขั้วนี้ก็เริ่มสะดุด คำตอบที่ถูกที่สุดไม่ใช่การย้ายทุกอย่างกลับมาอยู่ในโรงงาน แต่คือการเพิ่ม ชั้นคำนวณระหว่างกลาง ที่เรียกว่า Fog Computing ซึ่งกำลังกลับมาเป็นที่พูดถึงอีกครั้งในวงการอุตสาหกรรมปี 2026 สถาปัตยกรรมการคำนวณแบบไล่ระดับ ตั้งแต่อุปกรณ์ปลายทาง (Things) ผ่านชั้น Edge/Fog ขึ้นไปถึงคลาวด์ — ภาพ: Wikimedia Commons (CC BY-SA 4.0) ทำไมสองขั้วไม่พออีกต่อไป ลองนึกภาพสายการผลิตที่มีกล้องตรวจคุณภาพ 16 ตัว ส่งภาพความละเอียดสูงกลับคลาวด์เพื่อรันโมเดล Computer Vision ที่ 30 เฟรมต่อวินาที เสียงวิเคราะห์คลื่นเสียงเครื่องจักร และข้อมูล vibration ที่สุ่มที่ 10 kHz — แบนด์วิดท์ที่ต้องใช้ไม่ใช่แค่ "เยอะ" แต่แพงและเปราะ ถ้าเน็ตหลุดแม้เพียง 30 วินาที งานตรวจคุณภาพช่วงนั้นก็หายไปตลอดกาล ในทางกลับกัน การเอาทุกอย่างมาไว้ในเซิร์ฟเวอร์กลางในโรงงานล้มเหลวในอีกแบบ ทีม IT ต้องดูแลฮาร์ดแวร์ ทำ backup อัปเดต patch และขยายระบบทุกครั้งที่เพิ่มสายการผลิต Fog Computing เสนอทางที่สาม — กระจายการคำนวณลงไปในหลายๆ โหนดที่อยู่ใกล้แหล่งข้อมูล แต่ยังจัดการแบบรวมศูนย์ ตามแนวคิดที่ OpenFog Consortium (ซึ่งต่อมาควบรวมเข้ากับ Linux Foundation Edge) เคยสรุปไว้ใน Reference Architecture ว่าต้องมีคุณสมบัติ 8 ด้าน ตั้งแต่ Security, Scalability, Openness, Autonomy, Manageability, Agility, Hierarchical Organization ไปจนถึง Programmability ข้อกำหนดทางเทคนิคที่ต้องรู้ก่อนออกแบบ ประเด็นออกแบบ โจทย์จริงในโรงงาน แนวทาง Fog Latency budget ปิดสวิตช์ฉุกเฉินภายใน 10–50 ms หลังตรวจพบความผิดปกติ ประมวลผลและตัดสินใจที่โหนด Fog ในสายการผลิต ไม่รอ round-trip ไปคลาวด์ แบนด์วิดท์ กล้องตรวจคุณภาพ 16 ตัว ที่ 30 fps กินลิงก์ WAN เกินกว่าที่ลิงก์สำรองจะรับไหว สกัดเฉพาะผลลัพธ์และภาพที่พบ defect ขึ้นคลาวด์ ลดปริมาณข้อมูลขาออกได้ 90%…
Read More
ตลาด SCADA โต CAGR 10% ถึงปี 2032: อ่านตัวเลข MarketsandMarkets ให้ขาด และสิ่งที่โรงงานไทยต้องทำตอนนี้

ตลาด SCADA โต CAGR 10% ถึงปี 2032: อ่านตัวเลข MarketsandMarkets ให้ขาด และสิ่งที่โรงงานไทยต้องทำตอนนี้

Article
ตลาด SCADA ทั่วโลกกำลังเข้าสู่ช่วงเร่งตัว — รายงานฉบับล่าสุดจาก MarketsandMarkets (ตีพิมพ์กันยายน 2026) คาดการณ์ว่ามูลค่าตลาดระบบควบคุมและเฝ้าระวังแบบรวมศูนย์จะเติบโตจาก 13.94 พันล้านดอลลาร์สหรัฐในปี 2026 สู่ 24.69 พันล้านดอลลาร์ในปี 2032 ด้วยอัตราเติบโตเฉลี่ยต่อปี (CAGR) 10.0% ตัวเลขนี้ไม่ได้แค่บอกว่า "มีคนซื้อ SCADA มากขึ้น" แต่สะท้อนการเปลี่ยนแปลงเชิงโครงสร้างว่าระบบ SCADA กำลังถูกมองใหม่จาก "ห้องควบคุมของฝ่ายวิศวกรรม" ไปเป็น "แพลตฟอร์มข้อมูลกลางของทั้งองค์กร" ทีมงาน Honey Corporation ติดตั้งระบบ SCADA และระบบเฝ้าระวังในโรงงานอุตสาหกรรมมากว่าหลายโครงการ และสิ่งที่เราเห็นชัดในรอบ 2-3 ปีคือ ลูกค้าไม่ได้ถามแค่ "จอภาพเก็บค่าจาก PLC ได้กี่จุด" อีกต่อไป แต่ถามว่า "ข้อมูลจาก SCADA จะเชื่อมไปยังระบบ MES, ERP และ Dashboard ผู้บริหารได้อย่างไร" — คำถามที่เปลี่ยนไปนี้แหละคือแรงขับเคลื่อนตัวจริงของตลาด 10.0% ที่รายงานบอก อ่านตัวเลขให้ขาด: SCADA 10.0% หมายความว่าอย่างไร เราลองแยกแยะว่า CAGR 10.0% ในช่วง 2026-2032 มาจากไหน โดยเทียบกับรายงานย่อยที่เกี่ยวข้องจากสำนักเดียวกัน: ตลาด ปีฐาน → ปีเป้า ขนาดตลาด CAGR สิ่งที่บอกเรา SCADA โดยรวม 2026 → 2032 USD 13.94B → 24.69B 10.0% โครงสร้างพื้นฐาน + ซอฟต์แวร์โตพร้อมกันทั้งไลน์ SCADA in BIM (อาคาร) → 2032 USD 16.60B 21.5% อาคารอัจฉริยะ + Digital Twin ดันส่วนผสม BIM Power SCADA (ไฟฟ้า) → 2028 USD 2.9B 7.1% กลุ่มพลังงานเติบโตสม่ำเสมอ ไม่ใช่ตัวขับหลัก ที่มา: MarketsandMarkets, SCADA Market Global Forecast to 2032 (ก.ย. 2026); Power SCADA Market (2024); SCADA in Building Information…
Read More
Autonomous Factory ของโรงงานเซมิคอนดักเตอร์ Backend: ถอดบทเรียนจากโรงงานชิป Power Module มูลค่า 48,000 ล้านบาทที่เพิ่งเปิดในไทย

Autonomous Factory ของโรงงานเซมิคอนดักเตอร์ Backend: ถอดบทเรียนจากโรงงานชิป Power Module มูลค่า 48,000 ล้านบาทที่เพิ่งเปิดในไทย

Article
วันที่ 1 ตุลาคม 2569 ถือเป็นหมุดหมายสำคัญของอุตสาหกรรมการผลิตไทย — โรงงานผลิตเซมิคอนดักเตอร์ขั้นปลาย (Backend) แห่งใหม่มูลค่าการลงทุนกว่า 48,000 ล้านบาท ในจังหวัดสมุทรปราการเปิดตัวอย่างเป็นทางการ โดยมีนายกรัฐมนตรีเป็นประธานในพิธี นี่ไม่ใช่แค่ข่าวการลงทุนต่างชาติอีกหนึ่งชิ้น แต่คือ โรงงานอัตโนมัติ (Autonomous Factory) แห่งแรกของบริษัทเจ้าของโครงการที่รวมการทดสอบเวเฟอร์ (Wafer Testing) เข้ากับการประกอบโมดูลกำลัง (Power Module) และการทดสอบวงจรรวม (IC Final Test) ไว้ในสถานที่เดียวกัน บทความนี้ถอดรหัสว่า "Autonomous Factory" ในบริบท Backend Semiconductor หน้าตาเป็นอย่างไร ใช้เทคโนโลยีอะไรบ้าง และวิศวกรอุตสาหกรรมไทยจะเรียนอะไรได้จากโครงการระดับโลกที่มาตั้งอยู่ในประเทศเรา ความจำเพาะของโครงการที่ต้องรู้ก่อน ตัวเลขสำคัญของโครงการนี้อธิบายขนาดความทะเยอทะยานได้ดี: พื้นที่ห้องคลีนรูมเฟสแรก 30,000 ตารางเมตร ออกแบบให้ขยายได้สูงสุด 5 โมดูล รวม 150,000 ตร.ม. — มากกว่าโรงงานที่ใหญ่ที่สุดปัจจุบันของบริษัทราว 2 เท่า เป็นฐานผลิต Power Module แห่งที่ 3 ของโลก ต่อจากเยอรมนีและจีน และหากขยายครบทุกเฟส ไทยจะขึ้นเป็นฐาน Backend ที่ใหญ่ที่สุดในโลกของบริษัท ใช้พลังงานไฟฟ้าสีเขียว 100% พร้อมแผงโซลาร์เซลล์ ระบบหมุนเวียนน้ำ และระบบกักเก็บน้ำฝน คาดการณ์การจ้างงาน 5,000 ตำแหน่ง เมื่อครบทุกเฟส (ประมาณ 1,000 คนต่อเฟส) เน้นวิศวกรและช่างเทคนิค เงื่อไขถ่ายทอดเทคโนโลยี: พัฒนาบุคลากรไทยด้านวิทยาศาสตร์เทคโนโลยี 600 คน ส่งไปฝึกอบรมต่างประเทศ 130 คน ร่วมพัฒนาหลักสูตร 60 วิชา และวิจัยร่วม 680 โครงการ แผนภาพ: สถาปัตยกรรม Autonomous Backend Factory ที่รวม 3 กระบวนการหลักไว้ในโรงงานเดียว (ที่มา: Honey Corporation) ทำไม Backend ต้อง Autonomous มากกว่า Frontend? คนนอกวงการมักคิดว่าขั้นตอน Frontend (การผลิตเวเฟอร์) ซับซ้อนกว่า แต่ในมุมของวิศวกร Automation ขั้นตอน Backend กลับเป็นโจทย์ที่ท้าทายไม่แพ้กัน เพราะต้องจัดการกับ: ความหลากหลายของผลิตภัณฑ์ — โมดูลกำลังหนึ่งรุ่นอาจมี package หลายขนาด ทำให้ changeover บ่อยและต้องพึ่งระบบลำเลียงอัตโนมัติที่ยืดหยุ่น ความต้องการความสะอาดระดับสูงแต่ไม่สูงเท่า Frontend — โดยทั่วไปอยู่ในช่วง ISO…
Read More
บทวิเคราะห์ Powder Lifecycle Management: เมื่อผงโลหะ 90% ของเตียงพิมพ์ต้องถูกติดตามทุกรอบ ไม่ใช่แค่นับ reuse

บทวิเคราะห์ Powder Lifecycle Management: เมื่อผงโลหะ 90% ของเตียงพิมพ์ต้องถูกติดตามทุกรอบ ไม่ใช่แค่นับ reuse

Article
ในโลกของ Metal Additive Manufacturing มีตัวแปรที่ถูกพูดถึงน้อยกว่าเครื่องพิมพ์และดีไซน์ แต่ส่งผลต่อคุณภาพชิ้นงานโดยตรงเท่ากัน: ผงโลหะที่ใช้แล้วนำกลับมาใช้ใหม่ (powder reuse) เพราะในกระบวนการ Powder Bed Fusion ผงทั้งเตียงไม่ได้ถูกหลอมหมด — มีเพียงส่วนที่เป็นชิ้นงานจริงเท่านั้น ที่เหลือกว่า 90–95% ของผงต้องถูกเก็บ ร่อน ผสม และนำกลับเข้าเตียงพิมพ์รอบถัดไป คำถามที่ทุกโรงพิมพ์ต้องตอบให้ได้คือ "ผงรอบที่เท่าไหร่ที่ยังปลอดภัย และเรารู้ได้อย่างไรว่าถึงรอบนั้นแล้ว" กลไกเบื้องหลัง: อะไรเปลี่ยนไปในผงทุกครั้งที่ถูกพิมพ์ ทุกครั้งที่ผงผ่านวงจร heat exposure ในเตียงพิมพ์ มี 4 กลไกหลักที่เปลี่ยนแปลงคุณสมบัติของผงอย่างสะสม: Oxygen pickup — ไทเทเนียมและอัลลอยที่มีองค์ประกอบไวปฏิกิริยาดูดซับออกซิเจนเพิ่มขึ้นทุกรอบ แม้ในบรรยากาศก๊าซเฉื่อยที่ควบคุมดีแล้วก็ตาม ระดับออกซิเจนในผงจะไต่ขึ้นเรื่อยๆ จนกระทบความเหนียวของชิ้นงาน Morphology degradation — ผงเม็ดกลม (spherical) ที่ไหลดีค่อยๆ เปลี่ยนรูปทรงเปลี่ยน บางส่วน sinter ติดกันเป็นเม็ดผิดรูป (satellites) ส่งผลต่อ flowability และ bulk density ที่เทลงเตียง PSD shift — particle size distribution เลื่อนไปทางเม็ดใหญ่ขึ้น เพราะเม็ดเล็กถูก heat ทำลายหรือร่อนออกก่อน Spatter contamination — ฟองไอโลหะที่กระเด็นออกจาก melt pool กลายเป็นเม็ดผงเผาไหม้ (oxidized spatter) ปนเปื้อนอยู่ในผงที่เก็บกลับ ภาพ SEM ผงสแตนเลส 316L ช่วง atomize แรก — เม็ดกลมสม่ำเสมอคือสิ่งที่ reuse หลายรอบจะค่อยๆ ทำลาย (ภาพ: Wikimedia Commons, CC BY 4.0) งานวิจัยบอกอะไรเรา งานวิจัยจำนวนมากในทศวรรษที่ผ่านมาพยายามตอบคำถามนี้ด้วยการทดสอบ reuse หลายสิบรอบต่อเนื่อง ภาพรวมที่เห็นสอดคล้องกันคือ การเปลี่ยนแปลงของผงเกิดขึ้นจริงและวัดได้ตั้งแต่รอบแรกๆ แต่ทิศทางและอัตราไม่ได้เลวร้ายเสมอไป — หลายการทดสอบพบว่าค่า flowability บางตัวชี้วัดดีขึ้นในช่วงแรกเพราะความชื้นและไอระเหยถูกกำจัดออก ก่อนที่ผลจาก morphology และออกซิเจนจะกลับมากดลงในรอบถัดๆ ไป สรุปได้ว่าไม่มีตัวเลข "จำนวนรอบมหัศจรรย์" ที่ใช้ได้กับทุกวัสดุ ทุกเครื่อง และทุกชิ้นงาน — สิ่งที่เป็นสากลคือ ผงต้องถูกทดสอบอย่างเป็นระบบทุกครั้งที่ผ่านการใช้งาน ไม่ใช่นับรอบอย่างเดียว มุมมองจาก Honey Corporation: เราเห็นแนวโน้มเดียวกันนี้ในหลายโครงการ industrial — ปัญหาไม่ใช่การขาดเครื่องมือทดสอบผง แต่คือการที่ข้อมูลการทดสอบถูกเก็บกระจัดกระจายในไฟล์ Excel ของแต่ละกะ…
Read More
How-to: Industrial CT ตรวจชิ้นงาน Additive Manufacturing ตั้งแต่เลือก Voxel ถึง Porosity Analysis ใน 7 ขั้นตอน

How-to: Industrial CT ตรวจชิ้นงาน Additive Manufacturing ตั้งแต่เลือก Voxel ถึง Porosity Analysis ใน 7 ขั้นตอน

Article
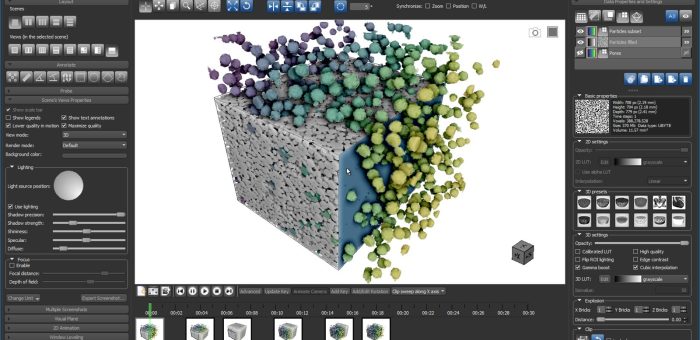
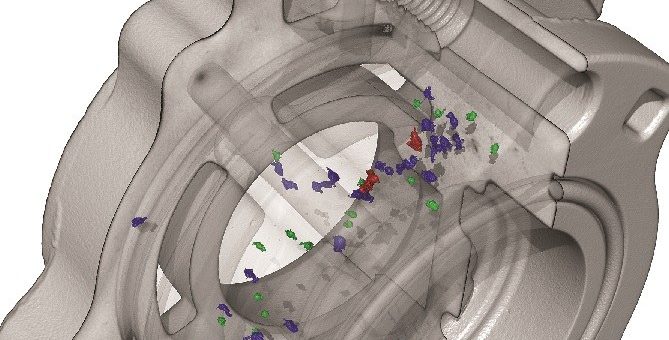
Industrial Computed Tomography (Industrial CT) คือเทคโนโลยีถ่ายภาพ 3 มิติด้วยรังสีเอกซ์ที่ก้าวขึ้นมาเป็น "มาตรฐานใหม่" ของการตรวจสอบชิ้นส่วน Additive Manufacturing ในช่วงหลายปีที่ผ่านมา เพราะมันตอบโจทย์ที่ NDT วิธีอื่นตอบไม่ได้: มองเห็นภายในชิ้นงานทั้งชิ้นโดยไม่ต้องทำลาย จากภายนอกจนถึงแกนกลาง ในหนึ่งการสแกน ทั้งยังได้ไฟล์โมเดล 3 มิติครบถ้วนที่นำไปเทียบกับไฟล์ CAD ต้นฉบับได้เลย หลักการทำงานสรุปได้ง่าย: หลอดเอกซ์เรย์หมุนรอบชิ้นงาน (หรือชิ้นงานหมุนรอบแหล่งกำเนิด) ตรวจจับด้วย flat panel detector นับพันภาพ 2 มิติจากมุมต่างๆ แล้วสร้างแบบจำลอง 3 มิติคืนกลับด้วยอัลกอริทึม reconstruction ผลลัพธ์คือ voxel model — คือพิกเซลที่มีความหนา จุดข้อมูลที่เล็กที่สุดของภาพ ซึ่งขนาด voxel กำหนดว่าเราจะมองเห็นรู (porosity) เล็กแค่ไหนได้ เครื่อง Industrial CT ยุคใหม่ใช้ digital direct detection — ความละเอียดและความไวต่อความหนาแน่นวัสดุสูงกว่า film ดั้งเดิมหลายเท่า (ภาพ: Wikimedia Commons, CC BY-SA 4.0) เจ็บปวดที่ CT มาแก้: Defect ที่ซ่อนอยู่ใต้พื้นผิว ชิ้นงาน AM มี defect จำเพาะที่โปรเซสแบบดั้งเดิมไม่มี — lack of fusion (หลอมไม่ติดกันเพราะพลังงานต่ำเกิน) กลายเป็นรูเปล่ายืดยาวพร้อมขอบแหลม, keyhole porosity (เปิดโพรงไอโลหะแล้วพังทลายกลายเป็นรูกลม), และ trapped powder ในช่องภายในที่ออกแบบให้เป็น channel หรือ lattice สิ่งเหล่านี้อยู่ "ใต้ผิว" การตรวจด้วยตา (VT) มองไม่เห็น Penetrant Testing (PT) ก็จับไม่ได้เพราะรูไม่เปิดออกผิว และ Ultrasonic Testing (UT) แบบดั้งเดิมเจอปัญหาพื้นผิวหยาบของ AM ที่ทำให้ coupling แย่ — CT จึงเป็นคำตอบที่เหลืออยู่เพียงคำตอบเดียวสำหรับชิ้นงาน AM ที่มีความซับซ้อนสูง ตัวอย่าง void ที่ CT ตรวจพบภายในชิ้นงาน — defect ประเภทนี้ VT/PT มองไม่เห็นเพราะไม่เปิดออกสู่ผิว (ภาพ: Wikimedia Commons, CC BY-SA…
Read More