Case Study: Federated Learning ในงาน Metal Additive Manufacturing — เมื่อ 3 โรงงานร่วมมือเทรนโมเดลตรวจจับ Defect โดยไม่ส่งข้อมูลดิบออกนอกไซต์

Case Study: Federated Learning ในงาน Metal Additive Manufacturing — เมื่อ 3 โรงงานร่วมมือเทรนโมเดลตรวจจับ Defect โดยไม่ส่งข้อมูลดิบออกนอกไซต์

Article
โจทย์คลาสสิกของ AI ในโรงงานคือ "ข้อมูลไม่พอเทรน" เครื่องจักรแต่ละตัวผลิต defect ที่หลากหลายและหายาก การเก็บชุดข้อมูลตัวอย่างที่ครอบคลุมทุกรูปแบบความผิดพลาดในไซต์เดียวอาจใช้เวลาเป็นปี ทางออกที่ตรงไปตรงมาคือรวมข้อมูลจากหลายโรงงานเข้าด้วยกัน — แต่แผนภาพสถานการณ์ของข้อมูล สูตรการผลิต และภาพถ่ายชิ้นงานจริง มักถูกจัดเป็นความลับทางการค้าที่แบ่งปันกันไม่ได้ บทความนี้ถอดบทเรียนจากงานวิจัยจริงที่ใช้ Federated Learning (FL) แก้ปัญหานี้ในงาน Metal Additive Manufacturing (การพิมพ์โลหะสามมิติ) ปัญหา: โมเดลตรวจ defect ที่ "ฉลาดเฉพาะบ้านตัวเอง" ในกระบวนการพิมพ์โลหะด้วยเลเซอร์ (Laser-Based Powder Bed Fusion) defect เกิดจากปัจจัยเชิงกายภาพมากมาย — พลังงานเลเซอร์, ความหนาผงโลหะ, อุณหภูมิแผ่นรองรับ และพฤติกรรมของ melt pool ระหว่างการพิมพ์ แต่ละไซต์ผลิตมีเครื่องพิมพ์คนละรุ่น ใช้ผงโลหะคนละล็อต และเจอ defect pattern ที่ไม่เหมือนกัน ผลคือโมเดลที่เทรนจากข้อมูลไซต์เดียว (Isolated Learning) ทำนายได้ดีในบ้านตัวเองแต่พลาดเมื่อเจอรูปแบบใหม่ ขณะที่การรวมศูนย์ข้อมูล (Centralized Learning) กระทบทั้งความเป็นส่วนตัวและขนาดข้อมูลที่ต้องเคลื่อนย้าย ทางออก: เทรนร่วมกันโดยข้อมูลไม่ต้องย้ายบ้าน Federated Learning กลับสูตรการเทรนแบบเดิม แทนที่จะย้าย "ข้อมูล" ไปหาโมเดล ก็ส่ง "โมเดล" ไปหาข้อมูล แต่ละโรงงาน (client) เทรนโมเดลสำเนาของตัวเองด้วยข้อมูลในพื้นที่ แล้วส่งเฉพาะ ค่าน้ำหนักที่อัปเดต (weight updates) กลับไปยังเซิร์ฟเวอร์กลาง เซิร์ฟเวอร์รวม (aggregate) การอัปเดตจากทุกไซต์ด้วยอัลกอริทึมอย่าง FedAvg ให้กลายเป็นโมเดลร่วม (global model) แล้วส่งกลับไปให้ทุกไซต์ในรอบถัดไป วนซ้ำแบบนี้จนโมเดลลู่เข้า แผนภาพ: วงจร Federated Learning — client เทรนในพื้นที่ ส่งเฉพาะ weight updates ขึ้นเซิร์ฟเวอร์กลางเพื่อ aggregate ด้วย FedAvg แล้วรับ global model กลับมา (ที่มา: Honey Corporation) ความต่างจากการเทรนรวมศูนย์เห็นได้ชัดเมื่อเปรียบเทียบว่า "อะไรเดินทางออกจากโรงงาน" ในแบบรวมศูนย์ ชุดข้อมูลดิบทั้งก้อนต้องออกจากทุกไซต์ไปอยู่บนเซิร์ฟเวอร์เดียว แต่ในแบบ federated สิ่งเดียวที่ออกจากไซต์คือพารามิเตอร์โมเดลขนาดกิโลไบต์ถึงหลักเมกะไบต์ต่อรอบ ข้อมูลภาพ melt pool หรือสูตรกระบวนการที่อ่อนไหวยังอยู่หลังไฟร์วอลล์ของเจ้าของข้อมูลเหมือนเดิม แผนภาพ: Centralized vs Federated — ซ้ายคือ raw data ทั้งหมดออกจากทุกไซต์ ขวาคือเฉพาะ model parameters เดินทาง…
Read More
TinyML ในโรงงานอุตสาหกรรม: ฝาก AI ลงไมโครคอนโทรลเลอร์ขนาด KB เพื่อตรวจสุขภาพเครื่องจักรแบบ Real-time โดยไม่ต้องพึ่งคลาวด์

TinyML ในโรงงานอุตสาหกรรม: ฝาก AI ลงไมโครคอนโทรลเลอร์ขนาด KB เพื่อตรวจสุขภาพเครื่องจักรแบบ Real-time โดยไม่ต้องพึ่งคลาวด์

Article
หลายโรงงานที่เริ่มใช้ AI ตรวจสอบสถานะเครื่องจักรมักเจอทางตันเดียวกัน คือสถาปัตยกรรมแบบ "ส่งข้อมูลขึ้นคลาวด์แล้วค่อยวิเคราะห์" ทำงานได้ดีในห้องทดลอง แต่เมื่อลงสนามจริงกับเซ็นเซอร์หลายร้อยจุด ปัญหาที่ตามมาคือค่า bandwidth, latency หลายร้อยมิลลิวินาที และความเสี่ยงเมื่ออินเทอร์เน็ตขาดกลางคัน คำตอบที่วงวิศวกร embedded เลือกใช้มากขึ้นเรื่อยๆ ในปี 2026 คือ TinyML — การฝากโมเดล Machine Learning ที่ผ่านการบีบอัดลงไปรันบนไมโครคอนโทรลเลอร์ (MCU) ที่มี RAM เพียงหลักร้อยกิโลไบต์ กินไฟระดับมิลลิวัตต์ และตัดสินใจได้เองที่ขอบเครือข่ายโดยไม่ต้องส่งข้อมูลดิบออกไปไหนเลย TinyML คืออะไร และทำไมโรงงานควรสนใจ TinyML คือสาขาย่อยของ Machine Learning ที่เน้นการ deploy และรันโมเดลบนอุปกรณ์ embedded ที่มีทรัพยากรจำกัด เช่น ไมโครคอนโทรลเลอร์ที่มี RAM เพียง "หลักสิบถึงหลักร้อยกิโลไบต์" flash จำกัด ไม่มี GPU และมักรันบน bare-metal หรือ RTOS เบาๆ ข้อจำกัดพวกนี้บังคับให้ทุกการตัดสินใจทางวิศวกรรมต้องแม่นยำ ตั้งแต่เลือกสถาปัตยกรรมโมเดลไปจนถึงวิธี quantize น้ำหนักโมเดล เหตุผลที่แนวทางนี้โตเร็วในภาคอุตสาหกรรมชัดเจนมาก: การทำ inference บนตัวอุปกรณ์เองช่วยรักษาความเป็นส่วนตัวของข้อมูล (ไม่ต้องส่ง raw data ขึ้นคลาวด์), ยืดอายุแบตเตอรี่ และทำให้ระบบตรวจจับความผิดปกติทำงานต่อได้แม้เน็ตหลุด สำหรับโรงงานที่มีจุดวัดในพื้นที่ห่างไกลหรือสภาพแวดล้อมรุนแรง TinyML จึงเป็นเสมือน "ผู้เชี่ยวชาญที่ประจำอยู่ในเครื่องจักร" 24 ชั่วโมง แผนภาพ: TinyML pipeline — เซ็นเซอร์ส่งสัญญาณเข้า preprocessing (FFT/Filter) แล้วป้อนเข้าโครงข่ายประสาทเทียมขนาดเล็กบน MCU ที่ตัดสินใจส่ง alert เองโดยไม่ผ่านคลาวด์ (ที่มา: Honey Corporation) อาหารสมองของ TinyML: Quantization หัวใจที่ทำให้โมเดล AI ลงไปอยู่ใน MCU ได้คือเทคนิคบีบอัด โมเดล image classification สถาปัตยกรรมยอดนิยมขนาด 50 เลเยอร์ในความละเอียดเต็ม (FP32) มีขนาดราว 100 MB เมื่อแปลงเป็น INT8 ด้วย Post-Training Quantization (PTQ) จะเหลือประมาณ 5 MB และเมื่อปรับให้เหมาะกับงานเฉพาะแบบ TinyML แล้ว ขนาดที่ทำได้จริงคือระดับ 500 KB — เล็กลงราว 200 เท่าจากต้นฉบับ พอที่จะฝากลง flash…
Read More
NILM (Non-Intrusive Load Monitoring): อ่านทะลุโหลดไฟฟ้าทั้งโรงงานจากมิเตอร์ตัวเดียวด้วย AI

NILM (Non-Intrusive Load Monitoring): อ่านทะลุโหลดไฟฟ้าทั้งโรงงานจากมิเตอร์ตัวเดียวด้วย AI

Article
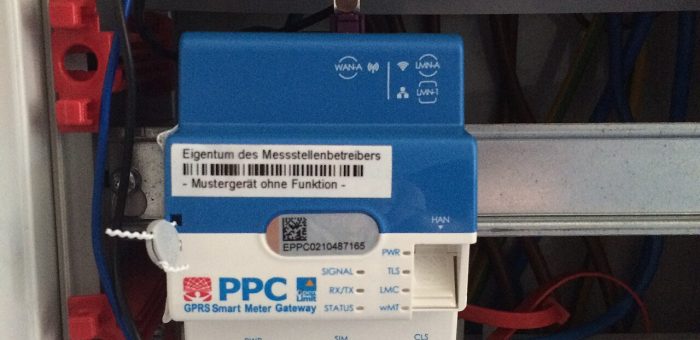
โรงงานของคุณมีมิเตอร์ไฟฟ้ากี่ตัว? คำถามนี้กำลังเปลี่ยนคำตอบด้วย AI คำถามฟังดูง่าย แต่แทบทุกโรงงานในไทยตอบเหมือนกัน — มิเตอร์หลักจากการไฟฟ้าหนึ่งตัว แล้วก็จบ เวลาใบแจ้งค่าไฟขึ้นเลข ฝ่ายวิศวกรรมก็นั่งเทียนหาสาเหตุกันแบบเดา ๆ ว่าเดือนนี้เครื่องจักรตัวไหนกินไฟมากขึ้น คอมเพรสเซอร์? ชิลเลอร์? หรือเตาอบที่ช่วงนี้รันเวลาเพิ่ม? คำตอบที่แท้จริงมักถูกฝังอยู่ในรูปคลื่นของข้อมูลที่เราไม่เคยแยกแยะ NILM (Non-Intrusive Load Monitoring) หรือ Energy Disaggregation คือเทคโนโลยีที่ตอบคำถามนี้โดยไม่ต้องติดมิเตอร์ย่อยทุกเครื่องจักร หลักการคือ อ่านสัญญาณกำลังไฟฟ้ารวมจากจุดเดียว แล้วใช้อัลกอริทึม "แยกสลาย" กลับเป็นโหลดย่อยของแต่ละอุปกรณ์ — เหมือนฟังเพลงประสานเสียงแล้วบอกได้ว่าตอนนี้ใครกำลังร้องเสียงดังเกินใคร Smart Meter Gateway — ประตูข้อมูลพลังงานระดับอุปกรณ์ที่ NILM ใช้เป็นแหล่งสัญญาณ (ภาพ: Wikimedia Commons) ต้นกำเนิดจากงานวิจัยปี 1992 ที่กลับมาฮอตในยุค IIoT แนวคิด NILM เริ่มจากงานวิจัยคลาสสิกของ George Hart แห่ง MIT ในปี 1992 ซึ่งพิสูจน์ว่า "ลายเซ็นไฟฟ้า" (load signature) ของอุปกรณ์แต่ละชนิด — รูปแบบการเปลี่ยนขึ้น-ลงของกำลังจริง (kW) และกำลังปฏิกิริยา (kVAR) ตอนเปิด-ปิด — นั้นแตกต่างกันเพียงพอที่จะใช้ระบุตัวอุปกรณ์ได้ มอเตอร์อินดักชันมี surge สูงตอนสตาร์ท ส่วนเตาความร้อนมีรูปคลื่นแบนราบเป็นขั้นบันได งานวิจัยทบทวนวรรณกรรมชั้นนำ (Kaselimi และคณะ, 2022) แบ่งวิวัฒนาการของ NILM เป็น 3 ยุค: ยุคแรก คือการคิดคณิตศาสตร์พื้นฐานด้วย combinatorial optimization และ factorial hidden Markov model (FHMM), ยุคกลาง คือการทดลอง deep learning อย่าง sequence-to-sequence และ CNN ที่แม่นยำขึ้นบนชุดข้อมูลสาธารณะ และ ยุคปัจจุบัน ที่งานวิจัยหันมาเน้นความ "น่าเชื่อถือได้จริง" (trustworthiness) — ความสามารถถ่ายโอนโมเดลข้ามสถานที่ (transferability) และความซับซ้อนที่ต้องลดลงเพื่อให้รันได้จริงในสภาพแวดล้อมโรงงาน หลักการทำงาน: จากสัญญาณเดียวสู่ N โหลด pipework ของ NILM มี 4 ขั้นตอนหลัก: เก็บสัญญาณ — อ่านค่ากำลังรวมจากมิเตอร์อัจฉริยะหรือ power quality analyzer ที่จุดจ่ายหลัก ความถี่ตั้งแต่ 1 ครั้ง/วินาที (1 Hz)…
Read More
บทวิเคราะห์: Prescriptive Maintenance (RxM) — เมื่อระบบบำรุงรักษาไม่ใช่แค่ทำนาย แต่บอกว่าควรทำอะไร

บทวิเคราะห์: Prescriptive Maintenance (RxM) — เมื่อระบบบำรุงรักษาไม่ใช่แค่ทำนาย แต่บอกว่าควรทำอะไร

Article
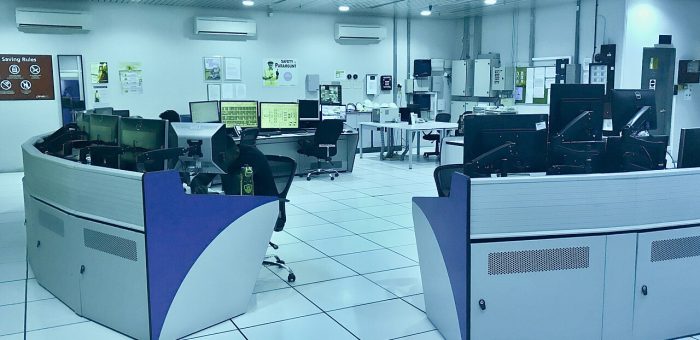
ทุกสายการผลิตเคยเจอคำถามนี้: ระบบแจ้งเตือนว่า "สัญญาณสั่นสะเทือนผิดปกติ" แล้วต่อไปล่ะ? ใครต้องไปดู ต้องซ่อมตอนไหน ถ้ารอก่อนจะเสียผลผลิตเท่าไร ถ้าหยุดเครื่องตอนนี้จะกระทบออร์เดอร์คือไหน — Prescriptive Maintenance (RxM) คือคำตอบที่อุตสาหกรรมกำลังเปลี่ยนไปหาในปี 2026 โดยมีรายงานจาก Hannover Messe ปีนี้ระบุว่า "Predictive Maintenance กำลังกลายเป็น Prescriptive" เป็นหนึ่งใน 12 เทรนด์หลักของปี ห้องควบคุมกลาง — จุดที่การแจ้งเตือนจาก predictive system ต้องถูกแปลงเป็นการตัดสินใจ ซึ่งยังเป็นงานของมนุษย์เต็มตัว (ภาพ: Z22 / Wikimedia Commons, CC BY-SA 4.0) ปัญหาของ Predictive: บอกว่า "จะเกิดอะไร" แต่ไม่บอกว่า "ควรทำอะไร" Predictive Maintenance ที่แข็งแรงแล้วหลายโรงงานยังคงเจอระยะสุดท้ายที่ติดอยู่ที่คน: โมเดลทำนายเก่ง แต่การแปลง prediction ให้เป็นการตัดสินใจยังต้องพึ่งประสบการณ์วิศวกร วิศวกรต้องชั่งน้ำหนักสภาพเครื่องจักรกับตารางผลิต อะไหล่พร้อมหรือไม่ และความสำคัญของสินทรัพย์แต่ละตัว ช่องว่างนี้คือสิ่งที่ RxM มาปิด — จากงานวิเคราะห์เชิงลึกของผู้ให้บริการ CMMS ระดับโลก: "ช่องว่างระหว่างสองกลยุทธ์นี้ไม่ใช่เซ็นเซอร์เพิ่มหรือ dashboard ที่สวยขึ้น แต่คือทีมของคุณได้รับข้อมูลที่ยังต้องตีความ หรือได้รับการตัดสินใจที่ปฏิบัติได้ทันที" RxM ทำงานอย่างไร: 3 ชั้นโครงสร้าง เพื่อให้คำแนะนำที่ "ตัดสินใจแทนได้" ระบบ RxM ต้องมี 3 ชั้นทำงานร่วมกัน ตามการวิเคราะห์ของผู้ให้บริการ CMMS ชั้นนำ: Condition Monitoring หลายโหมดต่อเนื่อง — เก็บสัญญาณ vibration, ultrasound, temperature และ magnetic field ด้วยความละเอียดพอจะเห็น failure signature ระยะต้นทั่วทั้ง fleet เครื่องจักร Automated Diagnostics — ระบุ failure mode เฉพาะเจาะจง ไม่ใช่แค่ "มีบางอย่างเปลี่ยน" การรู้ว่า vibration เพิ่มคือข้อมูล แต่การรู้ว่าแพทเทิร์นนั้นตรงกับ stage-two inner race bearing defect คือจุดเริ่มของการตัดสินใจ Prescription Layer — นำการวินิจฉัยไปชั่งน้ำหนักกับตัวแปรเชิงปฏิบัติการ (ตารางผลิต อะไหล่ในคลัง ความสำคัญของสินทรัพย์ แรงงาน ต้นทุนพลังงาน) แล้วส่งคืนเป็นคำแนะนำเฉพาะพร้อมผลลัพธ์ที่คาดหวัง หลายระบบใช้ digital…
Read More
Case Study: Physical AI ในโรงงานจริง — เมื่อ Georgia Tech ช่วยผู้ผลิตอะไหล่รถยนต์ลด Scrap Rate 50% ใน 45 วัน

Case Study: Physical AI ในโรงงานจริง — เมื่อ Georgia Tech ช่วยผู้ผลิตอะไหล่รถยนต์ลด Scrap Rate 50% ใน 45 วัน

Article
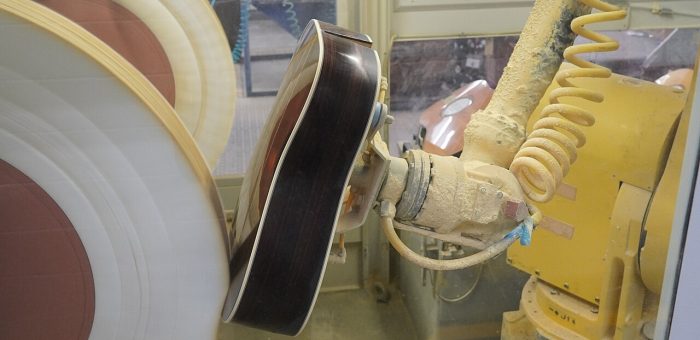
ตลาด PCB ของสหรัฐฯ เหลือเพียง 4% ของโลก และการพึ่งพาการแปรรูปหายากธาตุจากต่างประเทศเพิ่มความเสี่ยงเชิงกลยุทธ์ — นี่คือที่มาของสิ่งที่ Georgia Tech Manufacturing Institute (GTMI) เปิดตัวในปี 2026: สิ่งอำนวยความสะดวกนำร่อง Advanced Manufacturing Pilot Facility (AMPF) สถานที่ใช้ร่วมกันแห่งแรกในมหาวิทยาลัยวิจัยของสหรัฐฯ ที่ "ทำจริง" ในสิ่งที่หน่วยงานรัฐเพิ่งเริ่มให้ทุนวิจัย ผลลัพธ์ที่โดดเด่นที่สุด: อัตราเศษวัสดุเสีย (scrap rate) ของผู้ผลิตอะไหล่รถยนต์รายใหญ่ถูกลดลงครึ่งหนึ่งภายใน 45 วัน แขนกลอุตสาหกรรมทำงานจริงบนไลน์ผลิต — Physical AI ทำให้เครื่องจักรตัดสินใจปรับตัวเองได้ระดับเครื่อง (ภาพ: Henrysz / Wikimedia Commons, CC BY 4.0) ปัญหา: ข้อมูลมีเต็มคลัง แต่ไม่มีใครวิเคราะห์ทันเวลา IAC Group ผู้ผลิตชิ้นส่วนภายในรถยนต์ที่มีโรงงานกระจายทั่วสหรัฐฯ เม็กซิโก และอื่นๆ ประสบปัญหาคลาสสิกของยุค IIoT: "มีข้อมูลการผลิตมหาศาลอยู่แล้ว แต่วิเคราะห์เองไม่ทันการผลิต" — ประธานเจ้าหน้าที่ฝ่ายปฏิบัติการ Tom Boney เล่าว่าบริษัทแข่งขันทุกวันกับโรงงานในภูมิภาคต้นทุนต่ำ และต้องการความช่วยเหลือด้านสมองและพลังคำนวณที่องค์กรสร้างเองไม่ได้ โครงการแรกเลือกกระบวนการผลิตสารยึดติด (adhesive manufacturing) ที่ซับซ้อน ณ โรงงานในเมืองแวนซ์ รัฐแอละแบมา ซึ่งมีข้อมูลการผลิตเก็บมาแล้วมากมาย แต่ขาดทั้งพลังคำนวณและโมเดล AI ที่จะใช้ข้อมูลนั้นแบบเรียลไทม์ วิธีทำ: Physical AI + Mobile Robot ลงพื้นโรงงานจริง ทีมนักวิจัยและนักศึกษาระดับดุษฎีบัณฑิตของ Georgia Tech เชื่อมระบบของสถาบันตรงเข้ากับเครื่องจักรในโรงงาน และทำงานเคียงข้างพนักงานหน้าเครื่อง หัวใจของ AMPF คือการตีพิมพ์ Physical AI สู่สภาพแวดล้อมการผลิตจริง: เรียนรู้เครื่องจักรจากสัญญาณหลากหลาย — ระบบ AI วิเคราะห์สัญญาณออปติคอล ความร้อน เสียง และกระบวนการผลิตนับพันชุดต่อเนื่อง เพื่อหาแพทเทิร์น ปรับปรุงสมรรถนะ และตรวจจับความผิดปกติ เหตุผลที่ต้องทำแบบเรียลไทม์ — การพิมพ์ชิ้นส่วนจากผงโลหะพิเศษราคาสูงยิ่ง หรือซูเปอร์อัลลอยตัวใหม่ที่พัฒนาขึ้นเอง ความล้มเหลวของกระบวนการไม่ใช่ทางเลือกที่ยอมรับได้ คนกำหนดการทดลอง คนแปลผล — ในห้องปฏิบัติการ R&D โปรแกรมเครื่องจักรครั้งเดียวแล้วเปลี่ยนนับล้านครั้ง AI และหุ่นยนต์เคลื่อนที่จัดตารางผลิตและขนย้ายวัสดุอัตโนมัติ ขณะที่มนุษย์คือผู้ออกแบบการทดลองและแปลผล การสาธิต Smart Manufacturing — เชื่อมการค้นพบวัสดุ กระบวนการผลิต และการตรวจสอบคุณภาพไว้ในพื้นที่เดียว (ภาพ: Science and Technology Facilities…
Read More
12 เทรนด์เทคโนโลยีอุตสาหกรรมจาก Hannover Messe 2026: วิเคราะห์จาก 400 บูธ และ 300 สัมภาษณ์ — โรงงานไทยควรเริ่มจากตรงไหน

12 เทรนด์เทคโนโลยีอุตสาหกรรมจาก Hannover Messe 2026: วิเคราะห์จาก 400 บูธ และ 300 สัมภาษณ์ — โรงงานไทยควรเริ่มจากตรงไหน

Article
งาน Hannover Messe 2026 (20–24 เมษายน 2026 เมืองฮาโนเวอร์ ประเทศเยอรมนี) จบไปแล้วหลายเดือน แต่สัญญาณที่ได้จากงานกลับชัดเจนขึ้นเรื่อยๆ ว่าอุตสาหกรรมการผลิตกำลังเปลี่ยนผ่านไปตรงไหน — IoT Analytics ส่งทีมวิเคราะห์ 12 คนลงพื้นที่ เดินสำรวจกว่า 400 บูธ สัมภาษณ์เชิงลึกมากกว่า 300 ราย และสรุปออกมาเป็นรายงาน 197 หน้า ชี้ 12 เทรนด์เทคโนโลยีอุตสาหกรรมสำคัญประจำปี บทความนี้พาไล่ทีละเทรนด์ พร้อมมุมมองว่าโรงงานไทยควรเอาอะไรไปใช้จริง บรรยากาศงาน Hannover Messe — งานแสดงสินค้าอุตสาหกรรมที่ใหญ่ที่สุดในโลก (ภาพ: Olaf Kosinsky / Wikimedia Commons, CC BY-SA 3.0 DE) บริบทปี 2026: ความตึงเครียดระหว่าง AI กับข้อมูลที่เชื่อถือได้ ประเด็นกลางที่ IoT Analytics จับได้จากงานปีนี้คือ "ความตึงเครียด" ระหว่างสองฝั่ง — ผู้ขายเทคโนโลยีรีบผลักดันให้ AI ตัดสินใจอัตโนมัติบนสายการผลิตเพื่อสร้างรายได้ใหม่ ขณะที่คนส่วนใหญ่ในภาคการผลิตยังไม่ได้แก้ปัญหาพื้นฐาน คือ ข้อมูลที่เชื่อถือได้และมีบริบท (contextualized data) ที่จำเป็นต่อการให้ AI ตัดสินใจอย่างปลอดภัย ตัวเลขจากงานสะท้อนภาพนี้ชัด: ผู้เข้าชมราว 110,000 คน และผู้แสดงสินค้าราว 3,000 ราย ต่ำกว่าระดับก่อนโควิด — แต่คุณภาพผู้เข้าร่วมสูงมาก เต็มไปด้วยผู้บริหารระดับสูงด้านวิศวกรรมของกลุ่มอุตสาหกรรมใหญ่ๆ ทั่วโลก ไล่ทีละเทรนด์: 12 สัญญาณจากฮาโนเวอร์ ฮอลล์จัดแสดงสินค้าของงาน — ปีละ 3,000 ผู้แสดงสินค้าจากทั่วโลก (ภาพ: Ra Boe / Wikimedia Commons, CC BY-SA 3.0 DE) # เทรนด์ สิ่งที่เกิดขึ้นจริงบนพื้นงาน ผลกระทบต่อโรงงานไทย 1Agentic AIการคุยกันเลย Generative AI ไปสู่ AI Agent ที่ลงมือทำงานเองในกระบวนการผลิตเริ่มที่งานเอกสารและการจัดตารางผลิตก่อน ยังไม่ต้องรีบปล่อยให้คุมสายการผลิต 2Physical AIML ย้ายจากเซิร์ฟเวอร์ลงสู่เครื่องจักร ตัดสินใจเรียลไทม์ระดับเครื่องงานควบคุมคุณภาพและปรับสภาพเครื่องอัตโนมัติที่ต้องการ latency ต่ำ 3Humanoid Robotเข้าสู่ระยะ Early-stage Pilot ในโรงงานจริงติดตามผลนำร่องต่างประเทศได้ แต่ยังห่างการใช้งานกระจาย 4Industrial Foundation Modelผู้ให้บริการอุตสาหกรรมเริ่มสร้างโมเดล AI เฉพาะโดเมน…
Read More
Remaining Useful Life (RUL): คำถามสุดท้ายของ Predictive Maintenance ที่โมเดลใหญ่ตอบไม่ได้

Remaining Useful Life (RUL): คำถามสุดท้ายของ Predictive Maintenance ที่โมเดลใหญ่ตอบไม่ได้

Article
คำถามที่ยากที่สุดของ Predictive Maintenance ไม่ใช่ "เสียหรือยัง" แต่คือ "เหลือเวลาอีกนานเท่าไร" ตลอดหลายปีที่ผ่านมา Predictive Maintenance ในโรงงานส่วนใหญ่หยุดอยู่ที่คำถามแรก: เครื่องจักรตัวนี้ "ผิดปกติหรือไม่" — ซึ่ง Anomaly Detection ตอบได้ค่อนข้างดีแล้ว แต่คำถามที่มีผลต่อการวางแผนจริงๆ คือคำถามที่สอง: "ควรจัดซ่อมเมื่อไร" จัดเร็วเกินไปเสียโอกาสใช้งานชิ้นส่วนเต็มอายุ จัดช้าเกินไปก็กลายเป็น downtime ที่วางแผนไม่ได้ คำตอบของคำถามนี้มีชื่อเฉพาะในวงการวิศวกรรมความน่าเชื่อถือ: Remaining Useful Life (RUL) หรืออายุการใช้งานที่เหลืออยู่ RUL คือหัวใจของสาขา Prognostics and Health Management (PHM) ซึ่งเป็นขั้นสูงสุดของการบำรุงรักษาเชิงพยากรณ์ — ขณะที่ diagnostics บอกว่า "เกิดอะไรขึ้น" prognostics บอกว่า "จะไปต่ออีกนานแค่ไหน" ความต่างนี้คือความต่างระหว่างการรู้ว่าแบริ่งเริ่มมีรอย กับการรู้ว่าแบริ่งนั้นจะทนได้อีก 12 วันหรือ 12 ชั่วโมง ซึ่งนำไปสู่การตัดสินใจที่ต่างกันโดยสิ้นเชิง เครื่องยนต์เทอร์โบแฟน — กลุ่มเครื่องจักรที่งานวิจัย RUL ทำมากที่สุด เพราะความเสียหายระหว่างการใช้งานรุนแรงเกินจะรอให้เกิดขึ้น (ภาพ: Wikimedia Commons) จุดเปลี่ยน 2026: เมื่อ benchmark กลับหน้าไม่เป็นที่คาด เดือนเมษายน 2026 มีงานวิจัยเปรียบเทียบเทคนิค RUL ตีพิมพ์บน arXiv (Goel et al., 2026) ที่ให้ผลลัพธ์ "สะเทือนวงการ" ไม่ใช่เพราะตัวเลขสวย แต่เพราะมันตอกย้ำบทเรียนที่วิศวกรสาย reliability สงสัยกันมานาน งานวิจัยนี้ทดสอบบนชุดข้อมูลมาตรฐาน NASA C-MAPSS turbofan ซึ่งเป็น benchmark ที่ใช้กันทั่วโลกมาเกือบ 20 ปี โดยเปรียบเทียบ 3 ตระกูลวิธีบน subset FD001 และ FD003 ภายใต้ preprocessing เดียวกัน: โมเดล ตระกูล RMSE (FD001) RMSE (FD003) Ridge RegressionClassical (raw features)—— LSTM single-layer (Goel et al. 2026)Deep Learning14.9314.20 Deep LSTM (Zheng et al.)Deep Learning16.1416.18 1D CNNDeep Learning16.9715.68 XGBoostClassical…
Read More
Hybrid Twin: เมื่อ Physics-based Model จับมือ Machine Learning เพื่อโมเดลที่แม่นและทนทานกว่า

Hybrid Twin: เมื่อ Physics-based Model จับมือ Machine Learning เพื่อโมเดลที่แม่นและทนทานกว่า

Article
ในโครงการทำ Predictive Twin หลายโครงการที่เราเห็นล้มเหลว มีจุดตายตรงกันคือเลือกใช้ Machine Learning เพียงอย่างเดียว โมเดลทำนายแม่นยำในช่วงทดสอบ แต่พอเครื่องจักรเปลี่ยนสภาวะทำงาน ความแม่นยำก็ไถลลงจนใช้งานจริงไม่ได้ ในทางกลับกัน โมเดลฟิสิกส์ที่แม่นยำสุดๆ ก็มีข้อจำกัดเรื่องเวลาคำนวณและต้นทุนการสร้าง คำตอบที่งานวิจัยอุตสาหกรรมหันไปใช้กันมากขึ้นคือ Hybrid Twin — การผสานจุดแข็งของสองโลกเข้าไว้ในโมเดลเดียว ปัญหา: ทำไมโมเดลชนิดเดียวไม่พอ ลองนึกภาพการทำนายอุณหภูมิแบริ่งของมอเตอร์ไฟฟ้าขนาดใหญ่ วิธีฟิสิกส์ (Physics-based) คือสร้างโมเดลความร้อนและการสั่นสะเทือนจากสมการถ่ายเทความร้อนและพลศาสตร์ วิธีนี้เชื่อถือได้สูงเมื่ออยู่ในเงื่อนไขที่โมเดลออกแบบมา วิศวกรอธิบายได้ว่าทำไมค่าทำนายเป็นเช่นนั้น แต่การสร้างโมเดล FEA หรือ CFD ที่ละเอียดขึ้น มัคช์กับเครื่องจักรจริง ต้องใช้เวลาคำนวณนานและทรัพยากรจำนวนมาก ที่สำคัญข้อผิดพลาดเล็กๆ ในค่าสัมประสิทธิ์ เช่น สัมประสิทธิ์การนำความร้อนของวัสดุ สะสมกันเป็นความคลาดเคลื่อนของผลลัพธ์ ส่วนวิธีข้อมูล (Data-driven) อย่าง Deep Learning เรียนรู้จากข้อมูลเซ็นเซอร์จริงหลายหมื่นจุด ทำนายได้เร็วและแม่นในสภาวะที่เคยเห็น แต่โมเดลไม่เข้าใจกลไกเบื้องหลัง เมื่อเจอสภาวะใหม่ที่ไม่เคยมีในชุดข้อมูลฝึก เช่น เปลี่ยนวัตถุดิบ เปลี่ยนอัตราการผลิต หรือแว่วเสียงแปลกประหลาด โมเดลก็เดาผิดได้อย่างมั่นใจ งานวิจัยที่ตีพิมพ์ในวารสาร Procedia CIRP ปี 2022 เรียกปัญหานี้ว่าช่องว่างระหว่างสองกระบวนทัศน์ และเสนอว่าการผสานกันคือทางออกที่ยั่งยืนกว่า การจำลองทางฟิสิกส์อย่าง crash-test simulation แม่นยำแต่ต้องแลกกับเวลาคำนวณ — ที่มา: Wikimedia Commons (CC BY-SA) แนวทางแก้: โครงสร้างของ Hybrid Twin หลักคิดของ Hybrid Twin มีสามชั้นต่อกัน ชั้นแรกคือโมเดลฟิสิกส์แบบลดทอน (Reduced-order Model) ที่ย่อส่วนจากโมเดล FEA/CFD เต็มรูปแบบให้คำนวณได้เร็วขึ้นหลายเท่าตัว โดยยอมรับความคลาดเคลื่อนเล็กน้อย ชั้นที่สองคือโมเดลแทรกแซง (Correction Model) ที่เป็น Machine Learning หน้าที่เดียวคือเรียนรู้ "ส่วนต่าง" ระหว่างค่าทำนายของโมเดลฟิสิกส์กับค่าจริงจากเซ็นเซอร์ และชั้นที่สามคือวงจรสอบเทียบอัตโนมัติที่อัปเดตโมเดลแทรกแซงอย่างต่อเนื่องเมื่อข้อมูลใหม่ไหลเข้ามา โครงสร้าง Hybrid Twin: โมเดลฟิสิกส์ให้ความเข้าใจกลไก ML ชดเชยส่วนต่างจากข้อมูลจริง — ภาพวาดโดยทีม Honey Corporation ผลลัพธ์ที่ได้คือระบบที่ทำนายเร็วเท่า Machine Learning แต่ยังคงความน่าเชื่อถือนอกเงื่อนไขที่เคยเห็น เพราะเมื่อสภาวะเปลี่ยน โมเดลฟิสิกส์ยังจับพฤติกรรมหลักได้ ส่วน ML แค่ปรับค่าชดเชย แนวทางนี้ถูกนำไปใช้จริงในงานวิจัยระดับสากล เช่น โครงการ Horizon Europe ที่ใช้แนวคิด hybrid modeling ผสาน Digital Twin กับการผลิตจริง และงานวิจัยในวารสาร Journal of Engineering…
Read More
Acoustic Emission Monitoring: ดักฟังคลื่นเงียบจากวัสดุเพื่อพยากรณ์ความเสียหายก่อนเกิด

Acoustic Emission Monitoring: ดักฟังคลื่นเงียบจากวัสดุเพื่อพยากรณ์ความเสียหายก่อนเกิด

Article
เมื่อวัสดุเครื่องจักรเริ่มแตกร้าว ก่อนที่ตาเราจะเห็น หรือก่อนที่เซ็นเซอร์สั่นสะเทือนจะตรวจจับได้ วัสดุนั้นกำลัง "เคยชิน" คลื่นความเค้น (stress wave) ความถี่สูงออกมาเบาๆ เทคนิคที่ดักฟังคลื่นเงียบนี้คือ Acoustic Emission (AE) Monitoring — หนึ่งในเทคโนโลยี Non-Destructive Testing (NDT) ที่ทรงพลังที่สุดของวงการ Predictive Maintenance Acoustic Emission คืออะไร? Acoustic Emission (AE) คือปรากฏการณ์ที่วัสดุปล่อยคลื่นยืดหยุ่นชั่วขณะ (transient elastic wave) ออกมาเมื่อเกิดการเปลี่ยนแปลงโครงสร้างภายใน เช่น การเกิดรอยร้าว (crack initiation/propagation) การหลุดร่อง (delamination) การเสียรูปแบบพลาสติก (plastic deformation) หรือการรั่วของก๊าซ/ของเหลว คลื่นเหล่านี้มีความถี่อยู่ในย่าน 100 kHz ถึง 1 MHz (สูงกว่าเสียงที่หูมนุษย์ได้ยิน) และถูกตรวจจับด้วย เซ็นเซอร์เพียโซอิเล็กทริก (piezoelectric sensor) ที่แปลงคลื่นแรงดันเป็นสัญญาณไฟฟ้า เซ็นเซอร์เพียโซอิเล็กทริกแบบที่ใช้ในงาน Acoustic Emission Monitoring — แกนกลางคือวัสดุเซรามิกที่แปลงคลื่นความเค้นเป็นสัญญาณไฟฟ้า (ภาพ: Wikimedia Commons, CC BY-SA 4.0) สิ่งที่ทำให้ AE แตกต่างจากเทคนิค NDT อื่นอย่าง Ultrasonic Testing คือการที่ AE เป็นระบบ "Passive" — ไม่ปล่อยพลังงานเข้าไปกระตุ้น แต่ ดักฟัง สิ่งที่วัสดุปล่อยออกมาเอง นั่นหมายความว่า AE บอกได้ว่ารอยร้าวนั้น "กำลังเติบโตอยู่จริง" หรือไม่ ซึ่งเป็นข้อมูลสำคัญที่ตรวจการณ์แบบ snapshot มอบไม่ได้ พารามิเตอร์สำคัญที่วิศวกรต้องอ่านออก สัญญาณ AE แต่ละ "Hit" จะถูกสกัดเป็นพารามิเตอร์หลายตัวที่สะท้อนลักษณะของแหล่งกำเนิด: พารามิเตอร์ ความหมาย สื่อถึงอะไร Amplitude (dB) ค่าสูงสุดของสัญญาณ (มักวัด 40–100 dB) ความรุนแรงของเหตุการณ์ — ค่าสูงมักชี้การแตกร้าวรุนแรง Energy พื้นที่ใต้รูปคลื่น (μV²·s) พลังงานรวม — เกี่ยวข้องกับขนาดความเสียหาย Counts จำนวนครั้งที่สัญญาณข้าม threshold ความซับซ้อนของคลื่น — รอยร้าวมักให้ counts สูง Duration / Rise Time ระยะเวลาของสัญญาณ / เวลาขึ้นสู่…
Read More
Knowledge Distillation สำหรับ Industrial AI: เทคนิคบีบอัดโมเดล AI ขนาดใหญ่ให้วิ่งบน Edge Device

Knowledge Distillation สำหรับ Industrial AI: เทคนิคบีบอัดโมเดล AI ขนาดใหญ่ให้วิ่งบน Edge Device

Article
Knowledge Distillation สำหรับ Industrial AI: เทคนิคบีบอัดโมเดล AI ขนาดใหญ่ให้วิ่งบน Edge Device ในยุคที่โมเดล Deep Learning มีขนาดใหญ่ขึ้นเรื่อยๆ (บางโมเดลมีพารามิเตอร์นับพันล้าน) การ Deploy ลงบน Edge Device ในโรงงานที่มีทรัพยากรจำกัด (RAM 512 MB – 4 GB, CPU พลังต่ำ) จึงเป็นความท้าทายใหญ่ Knowledge Distillation (KD) คือเทคนิคที่แก้ปัญหานี้โดยการ "ถ่ายทอดความรู้" จากโมเดลใหญ่ (Teacher) ไปยังโมเดลเล็ก (Student) โดยรักษาประสิทธิภาพไว้ใกล้เคียงเดิม หลักการพื้นฐานของ Knowledge Distillation KD ได้แรงบันดาลใจจากกระบวนการเรียนการสอนในชีวิตจริง ครูที่มีความรู้ลึกซึ้ง (Teacher Model) สอนนักเรียนที่มีความจำจำกัด (Student Model) ให้เข้าใจเนื้อหาแกนกลางได้โดยไม่ต้องรู้ทุกอย่างแบบครู กระบวนการนี้ทำงานผ่านกลไกที่เรียกว่า Soft Labels ปกติโมเดล Classification จะให้ผลลัพธ์เป็น Hard Label (เช่น "ตำหนิประเภท A = 100%") แต่ Teacher Model จะให้ผลเป็น Soft Label ที่อยู่ในรูป Probability Distribution (เช่น "ตำหนิ A = 70%, ตำหนิ B = 25%, ปกติ = 5%") ข้อมูลเหล่านี้เรียกว่า Dark Knowledge — มันเก็บข้อมูลความสัมพันธ์ระหว่างคลาสที่ Hard Label สูญเสียไป สูตรการทำงานของ KD Loss Function ของ Student Model ประกอบด้วย 2 ส่วน: L_total = α × L_hard(y_true, y_student) + (1-α) × T² × L_soft(y_teacher, y_student) โดยที่: L_hard = Cross-Entropy Loss กับ Ground Truth (เหมือนการ Train ปกติ) L_soft =…
Read More