บทวิเคราะห์: Uncertainty Quantification — ทำไม Digital Twin ที่ดีต้องบอกว่า “ตัวเลขนี้เชื่อได้แค่ไหน”

บทวิเคราะห์: Uncertainty Quantification — ทำไม Digital Twin ที่ดีต้องบอกว่า “ตัวเลขนี้เชื่อได้แค่ไหน”

Article
เมื่อดิจิทัลทวินบอกว่า "อุณหภูมิจะเป็น 78°C ใน 30 นาที" — คุณควรเชื่อแค่ไหน? ค่าทำนายที่แม่นยำดูเหมือนของดี แต่ในโลกอุตสาหกรรม ตัวเลขเดียวที่ไม่บอกความมั่นใจคือข้อมูลครึ่งๆ กลางๆ ลองนึกภาพสองระบบ: ระบบ A ทำนายอุณหภูมิ 78°C, ระบบ B ทำนาย 78°C ± 6°C พร้อมช่วงความเชื่อมั่น 95% — ทั้งคู่ให้ตัวเลขกลางเดียวกัน แต่การนำไปใช้ตัดสินใจหยุดสายการผลิตหรือไม่ต่างกันคนละเรื่อง นี่คือเหตุผลที่ Uncertainty Quantification (UQ) กำลังกลายเป็นเกณฑ์ใหม่ของดิจิทัลทวินระดับมืออาชีพ ผลลัพธ์การจำลองเชิงตัวเลข ( finite element simulation) — เมื่อพารามิเตอร์ตั้งต้นไม่แน่นอน ผลลัพธ์ที่ได้ก็เป็นการกระจาย ไม่ใช่ค่าเดียว (ที่มา: Wikimedia Commons, CC BY-SA 3.0) ทำไมตัวเลขเดียวจึงไม่พออีกต่อไป รายงานฉบับสำคัญ Foundational Research Gaps and Future Directions for Digital Twins ของ National Academies of Sciences, Engineering, and Medicine (สหรัฐฯ, 2024) ระบุชัดเจนว่า uncertainty quantification ต้องเป็นส่วนหนึ่งของการออกแบบดิจิทัลทวินตั้งแต่ต้น ไม่ใช่ของตกแต่งท้ายโครงการ เพราะความไม่แน่นอนในระบบ twin มีหลายชั้นมากกว่าที่คิด: ชนิดความไม่แน่นอน ต้นกำเนิด ตัวอย่างในโรงงาน Aleatoric ความสุ่มตามธรรมชาติของกระบวนการ ความแปรปรวนของวัตถุดิบแต่ละล็อต, ความผันแปรของอุณหภูมิแวดล้อม Epistemic ความรู้ที่ยังไม่ครบถ้วน สัมประสิทธิ์สึกหรอที่ยังวัดไม่ได้, พฤติกรรมเครื่องจักรที่ยังไม่เคยเจอในข้อมูล Model การทำให้เป็นโมเดล (assumptions, สมการอย่างง่าย) สมการถ่ายเทความร้อนที่ตัดรายละเอียดมุมตายของหม้อต้มออก Numerical ข้อจำกัดของการคำนวณ ขนาด mesh ที่หยาบเกินไปเพื่อให้คำนวณทันเวลาจริง Data / Sensor ความคลาดเคลื่อนของการวัด เซ็นเซอร์อุณหภูมิความแม่นยำ ±0.5°C, ค่า drift หลังใช้งาน, สัญญาณรบกวน ประเด็นสำคัญที่มักถูกมองข้าม: สองชนิดแรกต้องจัดการคนละวิธี Aleatoric เป็นธรรมชาติของกระบวนการ ลดไม่ได้แต่บรรยายได้ด้วยการกระจายความน่าจะเป็น ส่วน Epistemic ลดได้ด้วยการเก็บข้อมูลเพิ่มหรือทดลองเพิ่ม — การแยกแยะให้ออกว่า error ที่เห็นมาจากไหน จึงกำหนดว่าควรลงทุนซื้อเซ็นเซอร์แม่นขึ้น (แก้ data) หรือปรับโมเดล (แก้ model) หรือทั้งคู่ เครื่องมือหลักของ UQ ในงานอุตสาหกรรม…
Read More
Edge Analytics ในโรงงานอุตสาหกรรม: วิเคราะห์ข้อมูลทันใจที่ตู้คอนโทรล ก่อนส่งขึ้นคลาวด์

Edge Analytics ในโรงงานอุตสาหกรรม: วิเคราะห์ข้อมูลทันใจที่ตู้คอนโทรล ก่อนส่งขึ้นคลาวด์

Article
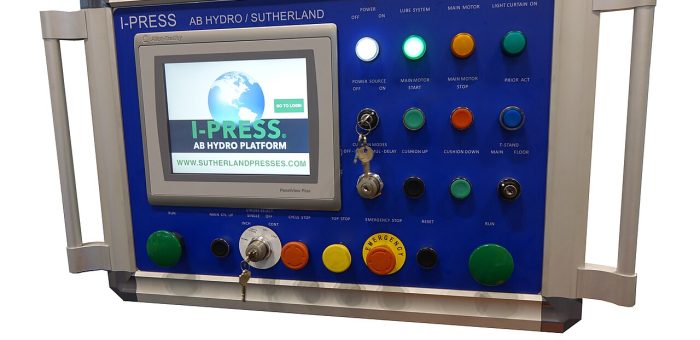
Edge Analytics คืออะไร — ในโรงงานสมัยใหม่ เซ็นเซอร์และเครื่องจักรหนึ่งแห่งสามารถผลิตข้อมูลได้วันละหลายกิกะไบต์ การส่งข้อมูลดิบทั้งหมดขึ้นคลาวด์ก่อนค่อยประมวลผลไม่ใช่คำตอบอีกต่อไป ทั้งจากค่า bandwidth, latency และความเสี่ยงเมื่ออินเทอร์เน็ตขาดหาย Edge Analytics คือการนำกระบวนการวิเคราะห์ข้อมูล — ตั้งแต่การกรองสัญญาณ คำนวณค่าสถิติ ไปจนถึงโมเดล AI — มาวางไว้ที่ edge of the network ใกล้กับแหล่งกำเนิดข้อมูล ไม่ว่าจะเป็น Edge Gateway ในตู้คอนโทรล คอมพิวเตอร์อุตสาหกรรมข้างสายการผลิต หรือเซิร์ฟเวอร์ในโรงงานเอง ผลลัพธ์คือการตัดสินใจเกิดขึ้นภายใน มิลลิวินาที แทนที่จะต้องรอไป-กลับคลาวด์หลายร้อยมิลลิวินาที ซึ่งเป็นความต่างระหว่าง "หยุดเครื่องทันเวลา" กับ "เสียชิ้นงานทั้งล็อต" แผงควบคุมอัตโนมัติที่เก็บ historical data ของเครื่อง press — จุดที่ Edge Analytics ทำงานจริง ก่อนข้อมูลจะถูกส่งขึ้นคลาวด์ (ภาพ: Wikimedia Commons) ทำไมปี 2026 ต้องพูดถึง Edge Analytics อีกครั้ง ตัวเลขสองชุดอธิบายได้ดีที่สุด รายงานของ IoT Analytics (Industry 4.0 & Smart Manufacturing Market Report 2026–2030) ระบุว่าตลาด Smart Manufacturing ทั่วโลกปี 2025 มีมูลค่า 175,000 ล้านดอลลาร์ และจะเติบโตด้วย CAGR 9.3% ไปแตะ 274,000 ล้านดอลลาร์ในปี 2030 ขณะที่ Gartner คาดการณ์ตลาด edge computing โลกจะขยายจาก 131,000 ล้านดอลลาร์ (2023) สู่ 511,000 ล้านดอลลาร์ภายในปี 2033 — เกือบ 4 เท่าใน 10 ปี แรงขับเคลื่อนที่แท้จริงไม่ใช่ตัวเทคโนโลยีเอง แต่เป็นสามแรงกดดันที่โรงงานไทยกำลังเผชิญ: (1) ปริมาณข้อมูลจาก IIoT sensor ที่เพิ่มขึ้นแบบทวีคูณจนส่งขึ้นคลาวด์ทั้งหมดไม่คุ้ม (2) งานที่ต้องการความเร็วระดับมิลลิวินาที เช่น การตรวจจับความผิดปกติของ vibration signature และ (3) นโยบาย data residency ที่บังคับให้ข้อมูลอ่อนไหวบางประเภทอยู่ในประเทศ สถาปัตยกรรม 3 ชั้นของ Edge Analytics Edge…
Read More
AI Security ในโรงงานอุตสาหกรรม: เมื่อ AI ที่ปกป้องสายการผลิต กลายเป็นเป้าหมายของผู้โจมตี

AI Security ในโรงงานอุตสาหกรรม: เมื่อ AI ที่ปกป้องสายการผลิต กลายเป็นเป้าหมายของผู้โจมตี

Article
เมื่อ AI เข้ามาอยู่ในสายการผลิต ใครจะเป็นคนเฝ้า AI ของคุณ? สองปีที่ผ่านมา โรงงานไทยต่างรีบดึง AI เข้าไปอยู่ในทุกจุดของสายการผลิต ตั้งแต่กล้องตรวจสอบคุณภาพบนสายพาน โมเดลทำนายการเสียหายของเครื่องจักร ไปจนถึงผู้ช่วย AI ที่ช่วยแนะนำการตั้งค่าพารามิเตอร์เครื่องจักร แต่มีคำถามหนึ่งที่หลายองค์กรยังไม่เคยตอบตัวเอง — ถ้า AI ตัวนั้นถูกโจมตี ใครจะรู้ตัว และรู้ได้อย่างไร รายงานดัชนีภัยคุกคามไซเบอร์ระดับโลกปี 2025 ระบุว่าอุตสาหกรรมการผลิตครองสัดส่วนการโจมตีทางไซเบอร์ถึง 17% ของทั้งหมดในปี 2025 เพิ่มขึ้นจาก 9% เมื่อปีก่อน ขณะที่ผลสำรวจผู้ผลิตทั่วโลกช่วงต้นปี 2026 พบว่า 40% ของผู้ผลิตส่วนใหญ่ระบุว่าความมั่นคงปลอดภัยไซเบอร์เป็นอุปสรรคอันดับ 1 ของการนำ AI มาใช้ — พวกเขามองเห็นความเสี่ยง แต่ทางออกที่ถูกต้องไม่ใช่การใช้ AI ให้น้อยลง หากคือการออกแบบระบบ AI ที่ "ปลอดภัยตั้งแต่ต้นทาง" (Security by Design) สายการผลิตอัตโนมัติสมัยใหม่มี AI ฝังอยู่ในทุกจุดตัดสินใจ — ตั้งแต่กล้องตรวจคุณภาพจนถึงการควบคุมเครื่องจักร (ภาพ: Wikimedia Commons, Public Domain) AI ในโรงงานถูกโจมตีได้จากทางไหนบ้าง? เส้นแบ่งระหว่าง "ปัญญาประดิษฐ์" กับ "ช่องโหว่ความปลอดภัย" ในโรงงานบางครั้งบางเกินไป การโจมตี AI ในสภาพแวดล้อมอุตสาหกรรมไม่ได้มากับไฟล์ malware ที่ antivirus สแกนเจอ หากมากับการบิดเบือน "ข้อมูล" และ "กระบวนการตัดสินใจ" ของ AI เอง ซึ่งเป็นมุมที่ทีม IT แบบดั้งเดิมมักมองข้าม เวกเตอร์การโจมตี กลไกการโจมตี ผลกระทบต่อสายการผลิต Adversarial Examples เพิ่มสัญญาณรบกวนขนาดเล็กที่ตามนุษย์มองไม่เห็น ทำให้โมเดล Computer Vision จำแนกชิ้นงานพลาด ชิ้นงานบกพร่องเล็ดลอดถึงลูกค้า หรือชิ้นงานดีถูกทิ้งเป็น scrap ทั้งที่เครื่องจักรปกติดี Model Poisoning แทรกข้อมูลปลอมเข้าชุดข้อมูลเทรน เช่น ป้ายกำกับผิดในระบบติดป้ายอัตโนมัติ จนโมเดลเรียนรู้ว่าความผิดปกติคือเรื่องปกติ โมเดล "เงียบๆ โง่ลง" อัตราการจับ scrap ค่อยๆ ตกลงเป็นเดือนโดยไม่มีใครรู้ตัว Data Evasion ปรับสภาพสัญญาณจากเซ็นเซอร์ เช่น ออฟเซ็ตอุณหภูมิเล็กน้อย ให้พ้นช่วงตรวจจับของโมเดล Anomaly Detection ความผิดพลาดของเครื่องจักรถูก "ทำให้มองไม่เห็น" จนเกิดความเสียหายจริง Prompt Injection ฝังคำสั่งแอบแฝงในเอกสารทางเทคนิค คู่มือ หรือ work…
Read More
บทวิเคราะห์: Model Drift — เมื่อ AI ตรวจสอบคุณภาพในโรงงานเงียบๆ โง่ลง และวิธีตรวจจับด้วย PSI / Jensen-Shannon / Wasserstein ก่อนที่ Scrap Rate จะบอกคุณเอง

บทวิเคราะห์: Model Drift — เมื่อ AI ตรวจสอบคุณภาพในโรงงานเงียบๆ โง่ลง และวิธีตรวจจับด้วย PSI / Jensen-Shannon / Wasserstein ก่อนที่ Scrap Rate จะบอกคุณเอง

Article
มีความล้มเหลวของ AI ในโรงงานอีกแบบหนึ่งที่เงียบกว่า outage และอันตรายกว่า bug — โมเดล vision ตรวจสอบคุณภาพที่เคยแม่นยำ 99% ในวัน go-live ค่อยๆ เสื่อมสภาพทีละนิดจนวันหนึ่ง scrap rate เริ่มไต่ขึ้นโดยไม่มี error message ใดๆ ปรากฏ ระบบยังเปิดอยู่ โมเดลยังตอบ แต่คำตอบนั้นเลื่อนจากความจริงไปเรื่อยๆ ปรากฏการณ์นี้คือ model drift และมันคือเหตุผลว่าทำไมโครงการ AI ในโรงงานจำนวนมากถึง “ตายหลังการผลิต” ทั้งที่ผ่าน UAT มาอย่างสวยงาม ทำไมโมเดลในโรงงานถึงเสื่อมเร็วกว่าที่คิด สภาพแวดล้อมการผลิตคือเครื่องจักรผลิต drift ชั้นเยี่ยม เปลี่ยน supplier วัสดุดิบเจอครั้งเดียว การกระจายของสีและ texture ในภาพตรวจสอบก็เปลี่ยน เครื่องจักรร้อนขึ้นตามอายุการใช้งาน ลำแสงกล้องสปอตไลต์เลือนลง แสงธรรมชาติเปลี่ยนตามฤดูกาล หรือแม้แต่การเปลี่ยนผู้ปฏิบัติงานก็เปลี่ยนพฤติกรรมการวางชิ้นงานต่อสายพาน ทุกอย่างที่โมเดลไม่เคยเห็นตอนเทรนคือ drift ที่กำลังจะเกิด ประเด็นสำคัญที่หลายทีมพลาดคือ drift ไม่ได้แค่ “เกิดขึ้นได้” แต่เกิดขึ้น แน่นอน — คำถามมีเพียงว่าจะเร็วแค่ไหนและคุณจะรู้ตัวก่อนหรือหลังความเสียหาย และในเชิงปฏิบัติ เมื่อ label จริง (ground truth) ใน production หาได้ยากหรือช้า การเฝ้าดูการกระจายของข้อมูลนำเข้าจึงกลายเป็นสัญญาณตัวแทน (proxy signal) ที่ดีที่สุดที่เรามี แยกให้ออก: Data Drift vs Concept Drift ก่อนจะเฝ้าระวัง ต้องเข้าใจว่า drift มีสองตระกูลใหญ่ที่สาเหตุและวิธีรักษาต่างกัน ถ้าสับสนสองอย่างนี้จะแก้ผิดทาง แผนภาพ: Data Drift (ซ้าย) คือการกระจายของ input เลื่อนแต่ความสัมพันธ์ input-output ยังเดิม / Concept Drift (ขวา) คือความสัมพันธ์นั้นเองเปลี่ยนไป (ที่มา: Honey Corporation) Data drift (หรือ covariate shift) คือการกระจายของ input features เปลี่ยนไปจากตอนเทรน — P(x) เปลี่ยน แต่ความสัมพันธ์ระหว่าง input กับ output ยังเหมือนเดิม ตัวอย่างโรงงานคือเปลี่ยน supplier วัสดุ ทำให้ค่าการสะท้อนแสงในภาพเลื่อนไปทางใดทางหนึ่ง ส่วน concept drift รุนแรงกว่า — ความสัมพันธ์ระหว่าง input กับ…
Read More
Case Study: Federated Learning ในงาน Metal Additive Manufacturing — เมื่อ 3 โรงงานร่วมมือเทรนโมเดลตรวจจับ Defect โดยไม่ส่งข้อมูลดิบออกนอกไซต์

Case Study: Federated Learning ในงาน Metal Additive Manufacturing — เมื่อ 3 โรงงานร่วมมือเทรนโมเดลตรวจจับ Defect โดยไม่ส่งข้อมูลดิบออกนอกไซต์

Article
โจทย์คลาสสิกของ AI ในโรงงานคือ “ข้อมูลไม่พอเทรน” เครื่องจักรแต่ละตัวผลิต defect ที่หลากหลายและหายาก การเก็บชุดข้อมูลตัวอย่างที่ครอบคลุมทุกรูปแบบความผิดพลาดในไซต์เดียวอาจใช้เวลาเป็นปี ทางออกที่ตรงไปตรงมาคือรวมข้อมูลจากหลายโรงงานเข้าด้วยกัน — แต่แผนภาพสถานการณ์ของข้อมูล สูตรการผลิต และภาพถ่ายชิ้นงานจริง มักถูกจัดเป็นความลับทางการค้าที่แบ่งปันกันไม่ได้ บทความนี้ถอดบทเรียนจากงานวิจัยจริงที่ใช้ Federated Learning (FL) แก้ปัญหานี้ในงาน Metal Additive Manufacturing (การพิมพ์โลหะสามมิติ) ปัญหา: โมเดลตรวจ defect ที่ “ฉลาดเฉพาะบ้านตัวเอง” ในกระบวนการพิมพ์โลหะด้วยเลเซอร์ (Laser-Based Powder Bed Fusion) defect เกิดจากปัจจัยเชิงกายภาพมากมาย — พลังงานเลเซอร์, ความหนาผงโลหะ, อุณหภูมิแผ่นรองรับ และพฤติกรรมของ melt pool ระหว่างการพิมพ์ แต่ละไซต์ผลิตมีเครื่องพิมพ์คนละรุ่น ใช้ผงโลหะคนละล็อต และเจอ defect pattern ที่ไม่เหมือนกัน ผลคือโมเดลที่เทรนจากข้อมูลไซต์เดียว (Isolated Learning) ทำนายได้ดีในบ้านตัวเองแต่พลาดเมื่อเจอรูปแบบใหม่ ขณะที่การรวมศูนย์ข้อมูล (Centralized Learning) กระทบทั้งความเป็นส่วนตัวและขนาดข้อมูลที่ต้องเคลื่อนย้าย ทางออก: เทรนร่วมกันโดยข้อมูลไม่ต้องย้ายบ้าน Federated Learning กลับสูตรการเทรนแบบเดิม แทนที่จะย้าย “ข้อมูล” ไปหาโมเดล ก็ส่ง “โมเดล” ไปหาข้อมูล แต่ละโรงงาน (client) เทรนโมเดลสำเนาของตัวเองด้วยข้อมูลในพื้นที่ แล้วส่งเฉพาะ ค่าน้ำหนักที่อัปเดต (weight updates) กลับไปยังเซิร์ฟเวอร์กลาง เซิร์ฟเวอร์รวม (aggregate) การอัปเดตจากทุกไซต์ด้วยอัลกอริทึมอย่าง FedAvg ให้กลายเป็นโมเดลร่วม (global model) แล้วส่งกลับไปให้ทุกไซต์ในรอบถัดไป วนซ้ำแบบนี้จนโมเดลลู่เข้า แผนภาพ: วงจร Federated Learning — client เทรนในพื้นที่ ส่งเฉพาะ weight updates ขึ้นเซิร์ฟเวอร์กลางเพื่อ aggregate ด้วย FedAvg แล้วรับ global model กลับมา (ที่มา: Honey Corporation) ความต่างจากการเทรนรวมศูนย์เห็นได้ชัดเมื่อเปรียบเทียบว่า “อะไรเดินทางออกจากโรงงาน” ในแบบรวมศูนย์ ชุดข้อมูลดิบทั้งก้อนต้องออกจากทุกไซต์ไปอยู่บนเซิร์ฟเวอร์เดียว แต่ในแบบ federated สิ่งเดียวที่ออกจากไซต์คือพารามิเตอร์โมเดลขนาดกิโลไบต์ถึงหลักเมกะไบต์ต่อรอบ ข้อมูลภาพ melt pool หรือสูตรกระบวนการที่อ่อนไหวยังอยู่หลังไฟร์วอลล์ของเจ้าของข้อมูลเหมือนเดิม แผนภาพ: Centralized vs Federated — ซ้ายคือ raw data ทั้งหมดออกจากทุกไซต์ ขวาคือเฉพาะ model parameters เดินทาง…
Read More
TinyML ในโรงงานอุตสาหกรรม: ฝาก AI ลงไมโครคอนโทรลเลอร์ขนาด KB เพื่อตรวจสุขภาพเครื่องจักรแบบ Real-time โดยไม่ต้องพึ่งคลาวด์

TinyML ในโรงงานอุตสาหกรรม: ฝาก AI ลงไมโครคอนโทรลเลอร์ขนาด KB เพื่อตรวจสุขภาพเครื่องจักรแบบ Real-time โดยไม่ต้องพึ่งคลาวด์

Article
หลายโรงงานที่เริ่มใช้ AI ตรวจสอบสถานะเครื่องจักรมักเจอทางตันเดียวกัน คือสถาปัตยกรรมแบบ “ส่งข้อมูลขึ้นคลาวด์แล้วค่อยวิเคราะห์” ทำงานได้ดีในห้องทดลอง แต่เมื่อลงสนามจริงกับเซ็นเซอร์หลายร้อยจุด ปัญหาที่ตามมาคือค่า bandwidth, latency หลายร้อยมิลลิวินาที และความเสี่ยงเมื่ออินเทอร์เน็ตขาดกลางคัน คำตอบที่วงวิศวกร embedded เลือกใช้มากขึ้นเรื่อยๆ ในปี 2026 คือ TinyML — การฝากโมเดล Machine Learning ที่ผ่านการบีบอัดลงไปรันบนไมโครคอนโทรลเลอร์ (MCU) ที่มี RAM เพียงหลักร้อยกิโลไบต์ กินไฟระดับมิลลิวัตต์ และตัดสินใจได้เองที่ขอบเครือข่ายโดยไม่ต้องส่งข้อมูลดิบออกไปไหนเลย TinyML คืออะไร และทำไมโรงงานควรสนใจ TinyML คือสาขาย่อยของ Machine Learning ที่เน้นการ deploy และรันโมเดลบนอุปกรณ์ embedded ที่มีทรัพยากรจำกัด เช่น ไมโครคอนโทรลเลอร์ที่มี RAM เพียง “หลักสิบถึงหลักร้อยกิโลไบต์” flash จำกัด ไม่มี GPU และมักรันบน bare-metal หรือ RTOS เบาๆ ข้อจำกัดพวกนี้บังคับให้ทุกการตัดสินใจทางวิศวกรรมต้องแม่นยำ ตั้งแต่เลือกสถาปัตยกรรมโมเดลไปจนถึงวิธี quantize น้ำหนักโมเดล เหตุผลที่แนวทางนี้โตเร็วในภาคอุตสาหกรรมชัดเจนมาก: การทำ inference บนตัวอุปกรณ์เองช่วยรักษาความเป็นส่วนตัวของข้อมูล (ไม่ต้องส่ง raw data ขึ้นคลาวด์), ยืดอายุแบตเตอรี่ และทำให้ระบบตรวจจับความผิดปกติทำงานต่อได้แม้เน็ตหลุด สำหรับโรงงานที่มีจุดวัดในพื้นที่ห่างไกลหรือสภาพแวดล้อมรุนแรง TinyML จึงเป็นเสมือน “ผู้เชี่ยวชาญที่ประจำอยู่ในเครื่องจักร” 24 ชั่วโมง แผนภาพ: TinyML pipeline — เซ็นเซอร์ส่งสัญญาณเข้า preprocessing (FFT/Filter) แล้วป้อนเข้าโครงข่ายประสาทเทียมขนาดเล็กบน MCU ที่ตัดสินใจส่ง alert เองโดยไม่ผ่านคลาวด์ (ที่มา: Honey Corporation) อาหารสมองของ TinyML: Quantization หัวใจที่ทำให้โมเดล AI ลงไปอยู่ใน MCU ได้คือเทคนิคบีบอัด โมเดล image classification สถาปัตยกรรมยอดนิยมขนาด 50 เลเยอร์ในความละเอียดเต็ม (FP32) มีขนาดราว 100 MB เมื่อแปลงเป็น INT8 ด้วย Post-Training Quantization (PTQ) จะเหลือประมาณ 5 MB และเมื่อปรับให้เหมาะกับงานเฉพาะแบบ TinyML แล้ว ขนาดที่ทำได้จริงคือระดับ 500 KB — เล็กลงราว 200 เท่าจากต้นฉบับ พอที่จะฝากลง flash…
Read More
NILM (Non-Intrusive Load Monitoring): อ่านทะลุโหลดไฟฟ้าทั้งโรงงานจากมิเตอร์ตัวเดียวด้วย AI

NILM (Non-Intrusive Load Monitoring): อ่านทะลุโหลดไฟฟ้าทั้งโรงงานจากมิเตอร์ตัวเดียวด้วย AI

Article
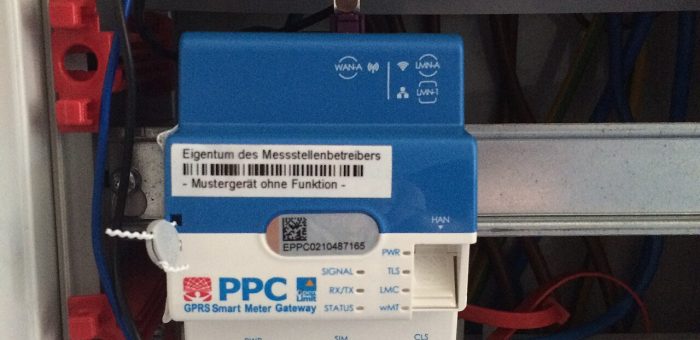
โรงงานของคุณมีมิเตอร์ไฟฟ้ากี่ตัว? คำถามนี้กำลังเปลี่ยนคำตอบด้วย AI คำถามฟังดูง่าย แต่แทบทุกโรงงานในไทยตอบเหมือนกัน — มิเตอร์หลักจากการไฟฟ้าหนึ่งตัว แล้วก็จบ เวลาใบแจ้งค่าไฟขึ้นเลข ฝ่ายวิศวกรรมก็นั่งเทียนหาสาเหตุกันแบบเดา ๆ ว่าเดือนนี้เครื่องจักรตัวไหนกินไฟมากขึ้น คอมเพรสเซอร์? ชิลเลอร์? หรือเตาอบที่ช่วงนี้รันเวลาเพิ่ม? คำตอบที่แท้จริงมักถูกฝังอยู่ในรูปคลื่นของข้อมูลที่เราไม่เคยแยกแยะ NILM (Non-Intrusive Load Monitoring) หรือ Energy Disaggregation คือเทคโนโลยีที่ตอบคำถามนี้โดยไม่ต้องติดมิเตอร์ย่อยทุกเครื่องจักร หลักการคือ อ่านสัญญาณกำลังไฟฟ้ารวมจากจุดเดียว แล้วใช้อัลกอริทึม "แยกสลาย" กลับเป็นโหลดย่อยของแต่ละอุปกรณ์ — เหมือนฟังเพลงประสานเสียงแล้วบอกได้ว่าตอนนี้ใครกำลังร้องเสียงดังเกินใคร Smart Meter Gateway — ประตูข้อมูลพลังงานระดับอุปกรณ์ที่ NILM ใช้เป็นแหล่งสัญญาณ (ภาพ: Wikimedia Commons) ต้นกำเนิดจากงานวิจัยปี 1992 ที่กลับมาฮอตในยุค IIoT แนวคิด NILM เริ่มจากงานวิจัยคลาสสิกของ George Hart แห่ง MIT ในปี 1992 ซึ่งพิสูจน์ว่า "ลายเซ็นไฟฟ้า" (load signature) ของอุปกรณ์แต่ละชนิด — รูปแบบการเปลี่ยนขึ้น-ลงของกำลังจริง (kW) และกำลังปฏิกิริยา (kVAR) ตอนเปิด-ปิด — นั้นแตกต่างกันเพียงพอที่จะใช้ระบุตัวอุปกรณ์ได้ มอเตอร์อินดักชันมี surge สูงตอนสตาร์ท ส่วนเตาความร้อนมีรูปคลื่นแบนราบเป็นขั้นบันได งานวิจัยทบทวนวรรณกรรมชั้นนำ (Kaselimi และคณะ, 2022) แบ่งวิวัฒนาการของ NILM เป็น 3 ยุค: ยุคแรก คือการคิดคณิตศาสตร์พื้นฐานด้วย combinatorial optimization และ factorial hidden Markov model (FHMM), ยุคกลาง คือการทดลอง deep learning อย่าง sequence-to-sequence และ CNN ที่แม่นยำขึ้นบนชุดข้อมูลสาธารณะ และ ยุคปัจจุบัน ที่งานวิจัยหันมาเน้นความ "น่าเชื่อถือได้จริง" (trustworthiness) — ความสามารถถ่ายโอนโมเดลข้ามสถานที่ (transferability) และความซับซ้อนที่ต้องลดลงเพื่อให้รันได้จริงในสภาพแวดล้อมโรงงาน หลักการทำงาน: จากสัญญาณเดียวสู่ N โหลด pipework ของ NILM มี 4 ขั้นตอนหลัก: เก็บสัญญาณ — อ่านค่ากำลังรวมจากมิเตอร์อัจฉริยะหรือ power quality analyzer ที่จุดจ่ายหลัก ความถี่ตั้งแต่ 1 ครั้ง/วินาที (1 Hz)…
Read More
บทวิเคราะห์: Prescriptive Maintenance (RxM) — เมื่อระบบบำรุงรักษาไม่ใช่แค่ทำนาย แต่บอกว่าควรทำอะไร

บทวิเคราะห์: Prescriptive Maintenance (RxM) — เมื่อระบบบำรุงรักษาไม่ใช่แค่ทำนาย แต่บอกว่าควรทำอะไร

Article
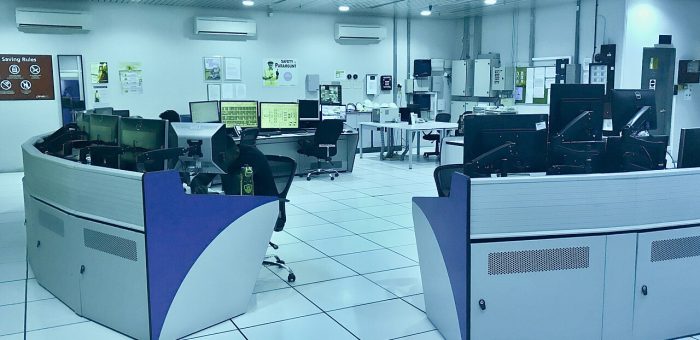
ทุกสายการผลิตเคยเจอคำถามนี้: ระบบแจ้งเตือนว่า "สัญญาณสั่นสะเทือนผิดปกติ" แล้วต่อไปล่ะ? ใครต้องไปดู ต้องซ่อมตอนไหน ถ้ารอก่อนจะเสียผลผลิตเท่าไร ถ้าหยุดเครื่องตอนนี้จะกระทบออร์เดอร์คือไหน — Prescriptive Maintenance (RxM) คือคำตอบที่อุตสาหกรรมกำลังเปลี่ยนไปหาในปี 2026 โดยมีรายงานจาก Hannover Messe ปีนี้ระบุว่า "Predictive Maintenance กำลังกลายเป็น Prescriptive" เป็นหนึ่งใน 12 เทรนด์หลักของปี ห้องควบคุมกลาง — จุดที่การแจ้งเตือนจาก predictive system ต้องถูกแปลงเป็นการตัดสินใจ ซึ่งยังเป็นงานของมนุษย์เต็มตัว (ภาพ: Z22 / Wikimedia Commons, CC BY-SA 4.0) ปัญหาของ Predictive: บอกว่า "จะเกิดอะไร" แต่ไม่บอกว่า "ควรทำอะไร" Predictive Maintenance ที่แข็งแรงแล้วหลายโรงงานยังคงเจอระยะสุดท้ายที่ติดอยู่ที่คน: โมเดลทำนายเก่ง แต่การแปลง prediction ให้เป็นการตัดสินใจยังต้องพึ่งประสบการณ์วิศวกร วิศวกรต้องชั่งน้ำหนักสภาพเครื่องจักรกับตารางผลิต อะไหล่พร้อมหรือไม่ และความสำคัญของสินทรัพย์แต่ละตัว ช่องว่างนี้คือสิ่งที่ RxM มาปิด — จากงานวิเคราะห์เชิงลึกของผู้ให้บริการ CMMS ระดับโลก: "ช่องว่างระหว่างสองกลยุทธ์นี้ไม่ใช่เซ็นเซอร์เพิ่มหรือ dashboard ที่สวยขึ้น แต่คือทีมของคุณได้รับข้อมูลที่ยังต้องตีความ หรือได้รับการตัดสินใจที่ปฏิบัติได้ทันที" RxM ทำงานอย่างไร: 3 ชั้นโครงสร้าง เพื่อให้คำแนะนำที่ "ตัดสินใจแทนได้" ระบบ RxM ต้องมี 3 ชั้นทำงานร่วมกัน ตามการวิเคราะห์ของผู้ให้บริการ CMMS ชั้นนำ: Condition Monitoring หลายโหมดต่อเนื่อง — เก็บสัญญาณ vibration, ultrasound, temperature และ magnetic field ด้วยความละเอียดพอจะเห็น failure signature ระยะต้นทั่วทั้ง fleet เครื่องจักร Automated Diagnostics — ระบุ failure mode เฉพาะเจาะจง ไม่ใช่แค่ "มีบางอย่างเปลี่ยน" การรู้ว่า vibration เพิ่มคือข้อมูล แต่การรู้ว่าแพทเทิร์นนั้นตรงกับ stage-two inner race bearing defect คือจุดเริ่มของการตัดสินใจ Prescription Layer — นำการวินิจฉัยไปชั่งน้ำหนักกับตัวแปรเชิงปฏิบัติการ (ตารางผลิต อะไหล่ในคลัง ความสำคัญของสินทรัพย์ แรงงาน ต้นทุนพลังงาน) แล้วส่งคืนเป็นคำแนะนำเฉพาะพร้อมผลลัพธ์ที่คาดหวัง หลายระบบใช้ digital…
Read More
Case Study: Physical AI ในโรงงานจริง — เมื่อ Georgia Tech ช่วยผู้ผลิตอะไหล่รถยนต์ลด Scrap Rate 50% ใน 45 วัน

Case Study: Physical AI ในโรงงานจริง — เมื่อ Georgia Tech ช่วยผู้ผลิตอะไหล่รถยนต์ลด Scrap Rate 50% ใน 45 วัน

Article
ตลาด PCB ของสหรัฐฯ เหลือเพียง 4% ของโลก และการพึ่งพาการแปรรูปหายากธาตุจากต่างประเทศเพิ่มความเสี่ยงเชิงกลยุทธ์ — นี่คือที่มาของสิ่งที่ Georgia Tech Manufacturing Institute (GTMI) เปิดตัวในปี 2026: สิ่งอำนวยความสะดวกนำร่อง Advanced Manufacturing Pilot Facility (AMPF) สถานที่ใช้ร่วมกันแห่งแรกในมหาวิทยาลัยวิจัยของสหรัฐฯ ที่ "ทำจริง" ในสิ่งที่หน่วยงานรัฐเพิ่งเริ่มให้ทุนวิจัย ผลลัพธ์ที่โดดเด่นที่สุด: อัตราเศษวัสดุเสีย (scrap rate) ของผู้ผลิตอะไหล่รถยนต์รายใหญ่ถูกลดลงครึ่งหนึ่งภายใน 45 วัน แขนกลอุตสาหกรรมทำงานจริงบนไลน์ผลิต — Physical AI ทำให้เครื่องจักรตัดสินใจปรับตัวเองได้ระดับเครื่อง (ภาพ: Henrysz / Wikimedia Commons, CC BY 4.0) ปัญหา: ข้อมูลมีเต็มคลัง แต่ไม่มีใครวิเคราะห์ทันเวลา IAC Group ผู้ผลิตชิ้นส่วนภายในรถยนต์ที่มีโรงงานกระจายทั่วสหรัฐฯ เม็กซิโก และอื่นๆ ประสบปัญหาคลาสสิกของยุค IIoT: "มีข้อมูลการผลิตมหาศาลอยู่แล้ว แต่วิเคราะห์เองไม่ทันการผลิต" — ประธานเจ้าหน้าที่ฝ่ายปฏิบัติการ Tom Boney เล่าว่าบริษัทแข่งขันทุกวันกับโรงงานในภูมิภาคต้นทุนต่ำ และต้องการความช่วยเหลือด้านสมองและพลังคำนวณที่องค์กรสร้างเองไม่ได้ โครงการแรกเลือกกระบวนการผลิตสารยึดติด (adhesive manufacturing) ที่ซับซ้อน ณ โรงงานในเมืองแวนซ์ รัฐแอละแบมา ซึ่งมีข้อมูลการผลิตเก็บมาแล้วมากมาย แต่ขาดทั้งพลังคำนวณและโมเดล AI ที่จะใช้ข้อมูลนั้นแบบเรียลไทม์ วิธีทำ: Physical AI + Mobile Robot ลงพื้นโรงงานจริง ทีมนักวิจัยและนักศึกษาระดับดุษฎีบัณฑิตของ Georgia Tech เชื่อมระบบของสถาบันตรงเข้ากับเครื่องจักรในโรงงาน และทำงานเคียงข้างพนักงานหน้าเครื่อง หัวใจของ AMPF คือการตีพิมพ์ Physical AI สู่สภาพแวดล้อมการผลิตจริง: เรียนรู้เครื่องจักรจากสัญญาณหลากหลาย — ระบบ AI วิเคราะห์สัญญาณออปติคอล ความร้อน เสียง และกระบวนการผลิตนับพันชุดต่อเนื่อง เพื่อหาแพทเทิร์น ปรับปรุงสมรรถนะ และตรวจจับความผิดปกติ เหตุผลที่ต้องทำแบบเรียลไทม์ — การพิมพ์ชิ้นส่วนจากผงโลหะพิเศษราคาสูงยิ่ง หรือซูเปอร์อัลลอยตัวใหม่ที่พัฒนาขึ้นเอง ความล้มเหลวของกระบวนการไม่ใช่ทางเลือกที่ยอมรับได้ คนกำหนดการทดลอง คนแปลผล — ในห้องปฏิบัติการ R&D โปรแกรมเครื่องจักรครั้งเดียวแล้วเปลี่ยนนับล้านครั้ง AI และหุ่นยนต์เคลื่อนที่จัดตารางผลิตและขนย้ายวัสดุอัตโนมัติ ขณะที่มนุษย์คือผู้ออกแบบการทดลองและแปลผล การสาธิต Smart Manufacturing — เชื่อมการค้นพบวัสดุ กระบวนการผลิต และการตรวจสอบคุณภาพไว้ในพื้นที่เดียว (ภาพ: Science and Technology Facilities…
Read More
12 เทรนด์เทคโนโลยีอุตสาหกรรมจาก Hannover Messe 2026: วิเคราะห์จาก 400 บูธ และ 300 สัมภาษณ์ — โรงงานไทยควรเริ่มจากตรงไหน

12 เทรนด์เทคโนโลยีอุตสาหกรรมจาก Hannover Messe 2026: วิเคราะห์จาก 400 บูธ และ 300 สัมภาษณ์ — โรงงานไทยควรเริ่มจากตรงไหน

Article
งาน Hannover Messe 2026 (20–24 เมษายน 2026 เมืองฮาโนเวอร์ ประเทศเยอรมนี) จบไปแล้วหลายเดือน แต่สัญญาณที่ได้จากงานกลับชัดเจนขึ้นเรื่อยๆ ว่าอุตสาหกรรมการผลิตกำลังเปลี่ยนผ่านไปตรงไหน — IoT Analytics ส่งทีมวิเคราะห์ 12 คนลงพื้นที่ เดินสำรวจกว่า 400 บูธ สัมภาษณ์เชิงลึกมากกว่า 300 ราย และสรุปออกมาเป็นรายงาน 197 หน้า ชี้ 12 เทรนด์เทคโนโลยีอุตสาหกรรมสำคัญประจำปี บทความนี้พาไล่ทีละเทรนด์ พร้อมมุมมองว่าโรงงานไทยควรเอาอะไรไปใช้จริง บรรยากาศงาน Hannover Messe — งานแสดงสินค้าอุตสาหกรรมที่ใหญ่ที่สุดในโลก (ภาพ: Olaf Kosinsky / Wikimedia Commons, CC BY-SA 3.0 DE) บริบทปี 2026: ความตึงเครียดระหว่าง AI กับข้อมูลที่เชื่อถือได้ ประเด็นกลางที่ IoT Analytics จับได้จากงานปีนี้คือ "ความตึงเครียด" ระหว่างสองฝั่ง — ผู้ขายเทคโนโลยีรีบผลักดันให้ AI ตัดสินใจอัตโนมัติบนสายการผลิตเพื่อสร้างรายได้ใหม่ ขณะที่คนส่วนใหญ่ในภาคการผลิตยังไม่ได้แก้ปัญหาพื้นฐาน คือ ข้อมูลที่เชื่อถือได้และมีบริบท (contextualized data) ที่จำเป็นต่อการให้ AI ตัดสินใจอย่างปลอดภัย ตัวเลขจากงานสะท้อนภาพนี้ชัด: ผู้เข้าชมราว 110,000 คน และผู้แสดงสินค้าราว 3,000 ราย ต่ำกว่าระดับก่อนโควิด — แต่คุณภาพผู้เข้าร่วมสูงมาก เต็มไปด้วยผู้บริหารระดับสูงด้านวิศวกรรมของกลุ่มอุตสาหกรรมใหญ่ๆ ทั่วโลก ไล่ทีละเทรนด์: 12 สัญญาณจากฮาโนเวอร์ ฮอลล์จัดแสดงสินค้าของงาน — ปีละ 3,000 ผู้แสดงสินค้าจากทั่วโลก (ภาพ: Ra Boe / Wikimedia Commons, CC BY-SA 3.0 DE) # เทรนด์ สิ่งที่เกิดขึ้นจริงบนพื้นงาน ผลกระทบต่อโรงงานไทย 1Agentic AIการคุยกันเลย Generative AI ไปสู่ AI Agent ที่ลงมือทำงานเองในกระบวนการผลิตเริ่มที่งานเอกสารและการจัดตารางผลิตก่อน ยังไม่ต้องรีบปล่อยให้คุมสายการผลิต 2Physical AIML ย้ายจากเซิร์ฟเวอร์ลงสู่เครื่องจักร ตัดสินใจเรียลไทม์ระดับเครื่องงานควบคุมคุณภาพและปรับสภาพเครื่องอัตโนมัติที่ต้องการ latency ต่ำ 3Humanoid Robotเข้าสู่ระยะ Early-stage Pilot ในโรงงานจริงติดตามผลนำร่องต่างประเทศได้ แต่ยังห่างการใช้งานกระจาย 4Industrial Foundation Modelผู้ให้บริการอุตสาหกรรมเริ่มสร้างโมเดล AI เฉพาะโดเมน…
Read More