How-to: วางระบบ Energy Harvesting สำหรับเซ็นเซอร์ IIoT ไร้สายใน 6 ขั้นตอน — เลิกเปลี่ยนแบตเตอรี่เซ็นเซอร์นับพันจุด

How-to: วางระบบ Energy Harvesting สำหรับเซ็นเซอร์ IIoT ไร้สายใน 6 ขั้นตอน — เลิกเปลี่ยนแบตเตอรี่เซ็นเซอร์นับพันจุด

Article
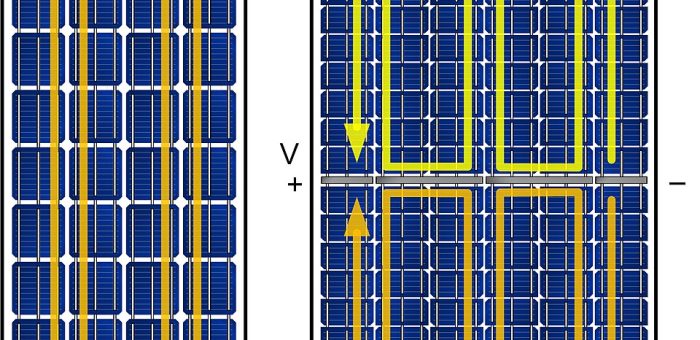
โครงการเซ็นเซอร์ IIoT ไร้สายจำนวนมากไม่ได้ตายเพราะเทคโนโลยีเซ็นเซอร์ — แต่ตายเพราะ งบเปลี่ยนแบตเตอรี่ เซ็นเซอร์ 500 จุดที่เปลี่ยนแบตทุก 2 ปี เฉลี่ยวันละ 1 จุดตลอดปี หมายถึงแรงงานบำรุงรักษาที่ปีนขึ้นเครื่องจักร ปิดสายการผลิต และข้อมูลที่หายช่วงเซ็นเซอร์ตายโดยไม่มีใครรู้ Energy Harvesting คือทางออกที่เปลี่ยนโจทย์นี้จาก "ดูแลแบตเตอรี่" เป็น "ออกแบบพลังงานให้เซ็นเซอร์หล่อเลี้ยงตัวเอง" แนวคิดไม่ใช่เรื่องใหม่ — งานวิจัยด้าน Wireless Sensor Network ของ NECTEC และมหาวิทยาลัยไทยหลายแห่งกล่าวถึงการเก็บเกี่ยวพลังงานจากสภาพแวดล้อมมานานกว่าทศวรรษ แต่จุดที่เปลี่ยนไปในปี 2026 คืออุปกรณ์เชิงพาณิชย์ใช้งานได้จริงและราคาเข้าถึงได้ เพราะไมโครคอนโทรลเลอร์รุ่นใหม่ทำงานในโหมด Sleep ที่กระแสหน่วยไมโครแอมป์ และเซ็นเซอร์เฉพาะทางที่ตื่นทำงานเฉพาะเมื่อมีเหตุการณ์ โมดูลเซลล์แสงอาทิตย์ขนาดเล็กคือแหล่งเก็บเกี่ยวพลังงานที่พบมากที่สุดในงานอุตสาหกรรม (ภาพ: Wikimedia Commons) 3 แหล่งพลังงานหลักในโรงงาน — เลือกให้ถูกกับจุดติดตั้ง แหล่งพลังงานกำลังที่ได้จริงเหมาะกับจุดติดตั้ง พลังงานความร้อน (TEG)มิลลิวัตต์ถึงหลักสิบมิลลิวัตต์ ที่ ΔT 20-80°Cท่อไอน้ำ ไอเสีย มอเตอร์ ตัวเครื่องจักรร้อน พลังงานความสั่นสะเทือน (Piezoelectric)ระดับไมโครวัตต์ถึงมิลลิวัตต์ ขึ้นกับ Resonanceตัวเครื่องจักรหมุนต่อเนื่อง โครงเหล็กใกล้แบริ่ง แสงในอาคาร (Indoor PV)ไมโครวัตต์ถึงมิลลิวัตต์ ตามความสว่างห้องควบคุม คลังสินค้ามีไฟส่องสว่างตลอด 6 ขั้นตอนวางระบบที่ทำงานได้จริง ขั้นที่ 1 — สำรวจ Energy Budget ก่อนซื้ออุปกรณ์ใดๆ เขียนสมดุลพลังงาน (Power Budget) ของเซ็นเซอร์หนึ่งโหนด: กระแสขณะ Sleep + กระแสขณะวัด + กระแสขณะส่งข้อมูล คูณด้วย Duty Cycle ตัวอย่างที่ใช้ได้จริง: เซ็นเซอร์อุณหภูมิส่งข้อมูลทุก 5 นาทีผ่านโปรโตคอลกระแสต่ำ เฉลี่ยแล้วราว 20-50 µW ขณะที่เซ็นเซอร์วัดความสั่นสะเทือนที่ส่ง Waveform เต็มทุก 10 นาทีอาจต้องการหลักร้อย µW ถึงมิลลิวัตต์ — ตัวเลขนี้คือกรอบตัดสินว่าแหล่งเก็บเกี่ยวพลังงานชนิดใดเพียงพอ ขั้นที่ 2 — วัดพลังงาน ณ จุดติดตั้งจริง ไม่ใช่เดาจาก Datasheet ΔT บนท่อไอน้ำที่วัดด้วยเทปแอมมิเตอร์คู่ หรือค่า Acceleration ของเครื่องจักรที่วัดด้วยอุปกรณ์มาตรฐาน ต้องถูกบันทึกเป็นเวลาอย่างน้อย 1 สัปดาห์ เพราะ datasheet ของ TEG ระบุกำลังที่ ΔT มากๆ แต่ในทางปฏิบัติความต่างอุณหภูมิที่ติดตั้งจริงมักต่ำกว่ามาก ขั้นที่ 3…
Read More
บทวิเคราะห์: หน้างานวิ่งนำ C-suite — Industrial AI Index 2026 เผยช่องว่างควบคุมที่อันตรายกว่าการยอมรับช้า

บทวิเคราะห์: หน้างานวิ่งนำ C-suite — Industrial AI Index 2026 เผยช่องว่างควบคุมที่อันตรายกว่าการยอมรับช้า

Article
กลางเดือนตุลาคม 2026 รายงานสำรวจรายใหม่จากผู้ให้บริการซอฟต์แวร์ Industrial AI รายใหญ่ระดับโลก (เผยแพร่ 13 ตุลาคม 2026) สร้างคำถามที่ไม่สบายใจสำหรับผู้บริหารโรงงานหลายราย: ถ้าทีมหน้างานเป็นฝ่ายขับเคลื่อน AI จริง แล้วผู้บริหารกำลังทำอะไรอยู่? รายงานฉบับนี้สำรวจผู้บริหารอาวุโสกว่า 2,200 คนจาก 14 ประเทศ แล้วพบ "Execution Divide" ชัดเจน — วิศวกร หัวหน้าโรงงาน และผู้รับผิดชอบโลจิสติกส์ คือกลุ่มที่ทำให้ AI เกิดผลเชิงพาณิชย์จริง ขณะที่กรอบ Governance และโครงสร้างการเข้าถึงข้อมูลกลับตามไม่ทัน ตัวเลขจากหน้างาน: ได้ผลจริงและวัดได้ องค์กรกว่า 90% ที่นำ AI อุตสาหกรรมไปใช้งานจริงรายงานผลลัพธ์เชิงประจักษ์ โดยเฉพาะด้านความน่าเชื่อถือของสินทรีย์กร: 93% ปรับปรุงอัตราการทำงาน "ถูกตั้งแต่ครั้งแรก" (First-Time-Right) 90% เพิ่มความพร้อมใช้งานของเครื่องจักร (Asset Availability) 88% ปรับปรุงการส่งมอบตรงตามแผน (On-Time Delivery Adherence) กว่า 50% ของเวลาพนักงานในงานหลักอย่าง Throughput และ Quality Assurance ถูกปลดปล่อยออกมา เวลาที่ได้คืนถูกนำไปใช้ต่อ: 36% ทุ่มให้ความปลอดภัยและการฝึกอบรมบุคลากร, 35% ปรับปรุงประสิทธิภาพเครื่องจักร, 26% เร่ง Continuous Improvement และ 25% ขยายส่วนแบ่งตลาด ห้องควบคุมการผลิต — จุดที่ทีมหน้างานใช้ข้อมูล Operational ตัดสินใจทุกวัน (ภาพ: Wikimedia Commons) ปรากฏการณ์ที่ต้องจับตา: คนหน้างาน "ฝึก AI ให้ทำงานแทน" ก่อนที่ผู้บริหารจะรู้ตัว ข้อมูลที่น่าประหลาดใจที่สุดคือพฤติกรรมของ Frontline ในช่วง 12 เดือนที่ผ่านมา: 43% ฝึกและนำ Agentic Digital Workers (AI Agent ที่ทำงานบางส่วนแทนคนได้) เข้าสู่งานประจำวันจริง 37% อัปสกิลเพื่อนร่วมงานให้ใช้เครื่องมือ AI อุตสาหกรรมในงานประจำวัน 36% ฝึกทีมให้ทำงานร่วมกับ Digital Worker โดยตรง ขณะที่ความพยายามหลักของผู้บริหารช่วงเดียวกันคือ "อัปสกิลตัวเอง" (41%) เพื่อให้เข้าใจ AI — ความสนใจหันเข้าด้านใน มากกว่าเสริมพลังให้หน้างานที่กำลังวิ่งอยู่แล้ว และความมั่นใจของผู้นำ (30%) กลายเป็นอุปสรรคใหญ่ที่สุดของการขยายผล ช่องว่างที่อันตรายกว่า: มั่นใจบนกระดาษ แต่ขาด Controls ที่หน้างาน ปัญหาไม่ใช่การยอมรับ AI…
Read More
บทวิเคราะห์ Cold Spray: ซ่อมเครื่องจักรด้วยผงโลหะความเร็วเหนือเสียง โดยไม่หลอม ไม่บิดเบี้ยว และไม่ต้องห้องก๊าซเฉื่อย

บทวิเคราะห์ Cold Spray: ซ่อมเครื่องจักรด้วยผงโลหะความเร็วเหนือเสียง โดยไม่หลอม ไม่บิดเบี้ยว และไม่ต้องห้องก๊าซเฉื่อย

Article
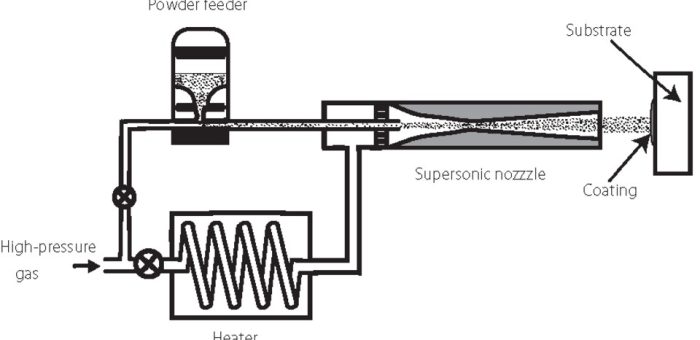
ซ่อมโดยไม่หลอม — ในโลกของ Additive Manufacturing ที่ทุกคนพูดถึงการ "สร้าง" ชิ้นส่วนใหม่ มีสายเทคโนโลยีหนึ่งที่เติบโตเงียบ ๆ จากทิศตรงข้าม คือการ "ซ่อม" ชิ้นส่วนเดิมให้กลับมาใช้งานได้ นั่นคือ Cold Spray (Gas Dynamic Cold Spray) กระบวนการพ่นผงโลหะด้วยความเร็วเหนือเสียงที่ ไม่หลอมโลหะตลอดกระบวนการ — และในมุมของผู้ดูแลสายการผลิต นี่อาจเป็นคำตอบของคำถามที่แพงกว่าการสร้างใหม่ นั่นคือ downtime Cold Spray ถูกคิดค้นโดยนักวิทยาศาสตร์รัสเซียในทศวรรษ 1990 ขณะทดลองเรื่องการกัดกร่อนของผงในอุโมงค์ลม แล้วบังเอิญพบว่าผงโลหะความเร็วสูงเกาะแน่นกับพื้นผิวเป้าหมายจนกลายเป็นเคลือบ เทคโนโลยีนี้ถูกพาไปสู่เชิงพาณิชย์ในทศวรรษเดียวกัน และวันนี้ถูกใช้ซ่อมชิ้นส่วนอากาศยานและอุปกรณ์ทหารเรือสหรัฐในระดับปฏิบัติการจริง หลักการ: พลังงานจลน์แทนความร้อน ขณะที่ thermal spray รุ่นเก่าอย่าง HVOF หรือ plasma spray ต้องหลอมหรือกึ่งหลอมผงก่อนพ่น Cold Spray เร่งผงโลหะขนาด 1–50 ไมโครเมตร ในกระแสก๊าซไนโตรเจนหรือฮีเลียมเหนือเสียง (สูงสุดราว 1,200 ม./วินาที) อุณหภูมิก๊าซไม่เกิน ~900°C ซึ่งต่ำกว่าจุดหลอมของโลหะที่พ่น เมื่ออนุภาคชนพื้นผิวด้วยความเร็วเหนือ critical velocity พลังงานจลน์เปลี่ยนเป็นการเสียรูปพลาสติก อนุภาคกระแทกแบนราบและยึดเกาะด้วยกลไก adiabatic shear instability — โลหะไหลตัวแบบของเหลวที่บริเวณรอยต่อแทบจะเข้าใกล้จุดหลอม ทั้งที่อุณหภูมิกว้างของชิ้นงานยังเย็น แผนภาพหลักการ Cold Spray: ผงโลหะถูกเร่งผ่าน nozzle De Laval จนเหนือเสียง ก่อนยึดเกาะพื้นผิวแบบ solid-state | ที่มา: Wikimedia Commons (CC BY 4.0) ทำไมโลกอุตสาหกรรมถึงหันมาสนใจ เหตุผลที่ Cold Spray ได้แรงผลักดันในช่วงหลายปีมานี้ วงจรมาจากปัญหาจริงของโรงงาน: ความร้อนต่ำ = ไม่บิดเบี้ยว — ชิ้นงาน base แทบไม่โดนความร้อน จึงซ่อมได้โดยไม่ทำให้ dimension ดั้งเดิมเปลี่ยน ไม่ต้อง heat treatment ซ้ำ ไม่ต้องห้องก๊าซเฉื่อย — ต่างจาก laser-based AM ที่ต้อง vacuum หรือก๊าซเฉื่อย Cold Spray ทำงานในบรรยากาศปกติ ทำให้ทำงานกับชิ้นงานใหญ่และถึงขนาด 9×3×1.5 เมตรได้ (เครื่องพิมพ์โลหะ cold spray ที่ใหญ่ที่สุดในโลกใช้หลักการนี้) อัตราการเติมวัสดุสูงถึง 45 กก./ชม. — เร็วกว่า…
Read More
บทวิเคราะห์: Weibull Analysis กับกลยุทธ์บำรุงรักษา — ทำไม β คือคำตอบของคำถาม ‘ควรซ่อมตามเวลา หรือซ่อมตามสภาพ’

บทวิเคราะห์: Weibull Analysis กับกลยุทธ์บำรุงรักษา — ทำไม β คือคำตอบของคำถาม ‘ควรซ่อมตามเวลา หรือซ่อมตามสภาพ’

Article
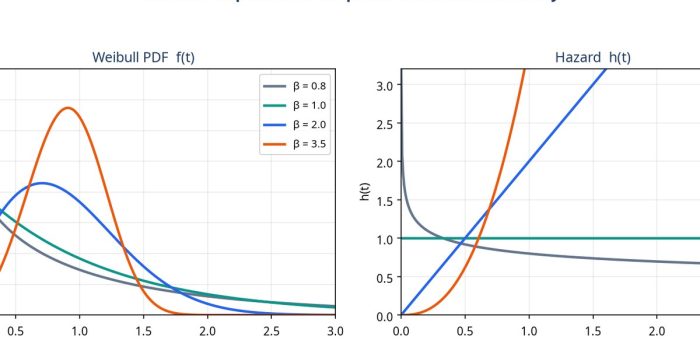
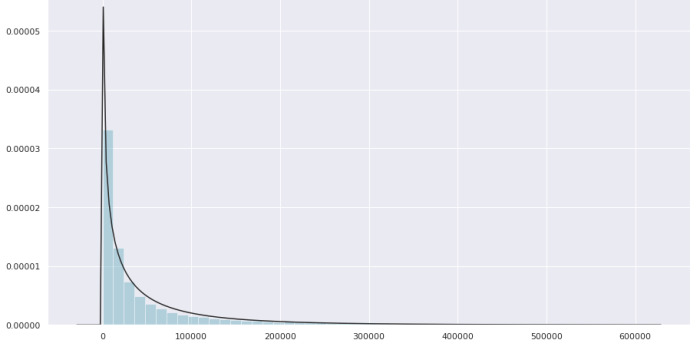
หลายโรงงานตั้ง schedule งาน preventive maintenance (PM) ด้วยเหตุผลเดียว: “เคยทำมาอย่างนี้” ทุก 3 เดือน ทุก 6 เดือน ทุกปี — คำถามคือ ตัวเลขเหล่านี้มีที่มาจากข้อมูลความล้มเหลวจริง หรือเป็นเพียงความเคยชิน? เครื่องมือสถิติที่ตอบคำถามนี้ตรงที่สุดคือ Weibull Analysis — การวิเคราะห์การแจกแจงความล้มเหลวที่ใช้ในอุตสาหกรรมการบินและอวกาศมาตั้งแต่ทศวรรษ 1950 และวันนี้กลายเป็นหัวใจของ data-driven maintenance ในโรงงานอุตสาหกรรมทั่วโลก และเมื่อรวมกับเซ็นเซอร์ IIoT ที่เก็บ condition data ได้ต่อเนื่อง Weibull ไม่ได้แข่งกับ Predictive Maintenance — แต่เป็น ชั้นข้อมูลที่บอกว่าเครื่องจักรแต่ละแบบควรถูกเฝ้าดูแบบไหน Weibull ใน 60 วินาที: สองพารามิเตอร์ที่อธิบายทุกเรื่องราว การแจกแจง Weibull อธิบายด้วยพารามิเตอร์สองตัว: β (beta) shape parameter และ η (eta) characteristic life โดย β บอก “รูปแบบการตาย” ของอุปกรณ์: β < 1: อัตราการล้มเหลวลดลงตามอายุ (Infant Mortality) — พบในอุปกรณ์ใหม่ที่มี defect จากการผลิต/ติดตั้ง β = 1: ล้มเหลวสุ่ม (Random) — ไม่มีอายุขัยที่ “ควรซ่อม” การตั้ง PM เป็นการทำให้แย่ลง (PM ตัวเองคือความเสี่ยง) β > 1: ล้มเหลวเพิ่มตามอายุ (Wear-out) — แน่นอนว่าเครื่องจักรกลไกส่วนใหญ่อยู่ในกลุ่มนี้ และเป็นกลุ่มที่ PM ทำงานได้ดี ภาพประกอบ: ซ้าย: PDF ของ Weibull ที่ β ต่างกัน / ขวา: hazard function — β > 1 คือโซนที่ preventive maintenance มีคุณค่า ส่วน β ≤ 1 คือโซนที่ PM ต้องถูกท้าทาย เมื่อโรงงานเก็บ CMMS Data แต่ไม่เคยวิเคราะห์ ปัญหาที่พบซ้ำๆ ในโรงงานไทย:…
Read More
How-to: ออกแบบระบบ Wireless Vibration Monitoring ตั้งแต่ Fmax ถึง Battery Life — คู่มือ 6 ขั้นตอนสำหรับทีมผู้ดูแลโรงงาน

How-to: ออกแบบระบบ Wireless Vibration Monitoring ตั้งแต่ Fmax ถึง Battery Life — คู่มือ 6 ขั้นตอนสำหรับทีมผู้ดูแลโรงงาน

Article
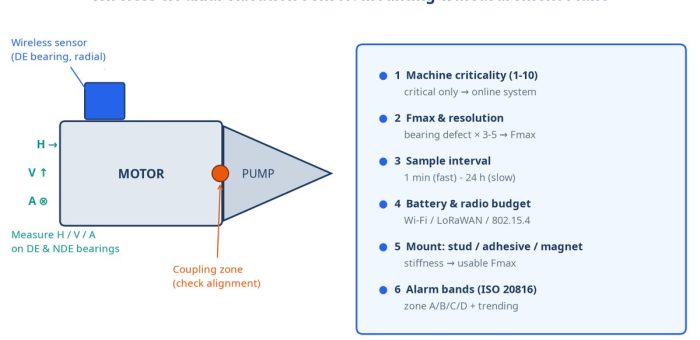
คำถามที่ทีมวิศวกรรมของ Honey Corporation ได้ยินบ่อยที่สุดเมื่อเริ่มโครงการ Predictive Maintenance คือ “เซ็นเซอร์ไร้สายตัวนี้ แบตอยู่ได้กี่ปี” — คำตอบที่ตรงประเด็นไม่ใช่ตัวเลขจากโบรชัวร์ แต่คือ การออกแบบ sampling strategy ให้สอดคล้องกับ failure mode ของเครื่องจักร บทความนี้รวมกระบวนการคิดทั้งหมดเป็น 6 ขั้นตอนที่ทีมใช้จริงในโครงการติดตั้งระบบมอนิเตอริ่งในโรงงานอุตสาหกรรม ขั้นที่ 1 — จัดลำดับเครื่องจักรตาม Criticality ก่อนซื้อเซ็นเซอร์สักตัว อย่าเพิ่งถามว่า “ติดกี่จุด” จนกว่าจะรู้ว่าเครื่องไหน “เสียแล้วเจ็บ” ใช้การประเมิน Criticality แบบ 1-10 ที่พิจารณาทั้ง Safety, Production Impact, Redundancy และ Repair Lead Time: คะแนน 8-10 (Critical): เครื่องหลักไม่มี spare เช่น ปั๊มหลัก boiler feed pump — เหมาะกับระบบ online ต่อเนื่อง คะแนน 5-7 (Essential): มี standby สลับกัน หรือหยุดได้ไม่เกินชั่วโมง — เหมาะกับ wireless วัดเป็นรอบ คะแนน 1-4 (General): มี stock สำรอง เปลี่ยนง่าย — พอด้วย route-based ด้วย handheld ประสบการณ์จากหลายโครงการคือ จำนวนเครื่องวิกฤติจริงมักไม่เกิน 10-15% ของเครื่องจักรทั้งโรงงาน — การเริ่มจากกลุ่มนี้ทำให้โครงการนำร่องเห็นผลเร็วและคุ้มค่าที่สุด ขั้นที่ 2 — คำนวณ Fmax จาก Bearing Frequency ความถี่สูงสุดที่ต้องเก็บ (Fmax) ไม่ใช่ตัวเลขลอยๆ แต่คำนวณจาก ความถี่ความเสียหายของแบริ่ง (BPFO/BPFI/BSF) คูณ 3-5 เท่า เพื่อให้เห็นทั้ง harmonic และ sideband: เครื่องจักร ความเร็วรอบ BPFO โดยประมาณ Fmax ที่แนะนำ Resolution (ล. ต่อรอบ) ปั๊มได้น้ำ / มอเตอร์ 2,950 rpm ~148 Hz 1-2 kHz ( waveform) /…
Read More
Partial Discharge Monitoring: ฟังเสียงกระซิบของฉนวนก่อนที่ตู้สวิตช์เกียร์ MV จะกลายเป็นหน้าข่าว

Partial Discharge Monitoring: ฟังเสียงกระซิบของฉนวนก่อนที่ตู้สวิตช์เกียร์ MV จะกลายเป็นหน้าข่าว

Article
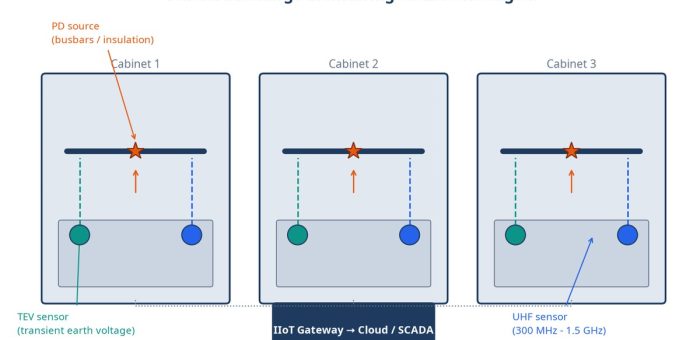
ไฟดับทั้งโรงงานตอนกลางคืน ปฏิบัติการผลิตหยุดนิ่ง 6-8 ชั่วโมง เสียหายของวัตถุดิบในกระบวนการ และค่าแรงช่างกะดึก — นี่คือราคาที่โรงงานหลายแห่งจ่ายไปก่อนจะรู้จักคำว่า Partial Discharge (PD) หรือ “การคายประจุบางส่วน” ปรากฏการณ์เงียบๆ ที่เกิดขึ้นภายในระบบฉนวนของตู้สวิตช์เกียร์แรงกลาง (MV Switchgear) ทุกครั้งที่ความเครียดไฟฟ้า (Electrical Stress) มากกว่าที่ฉนวนจะรับไหว แต่ยังไม่ถึงจุดลัดวงจรเต็มรูปแบบ จุดสำคัญคือ PD เกิดขึ้น เป็นเดือนหรือเป็นปีก่อนความเสียหายรุนแรงเกิดขึ้นจริง — IEEE และ CIGRE รายงานมาต่อเนื่องว่าการเสื่อมสภาพของฉนวนเป็นหนึ่งในสาเหตุอันดับต้นๆ ของความล้มเหลวของสวิตช์เกียร์แรงกลาง และ PD Monitoring แบบถาวร (Online Continuous Monitoring) ช่วยให้ทีมไฟฟ้าเห็นสัญญาณตั้งแต่ระยะแรก ที่ซ่อมแซมยังเป็นเรื่อง “วางแผน” ไม่ใช่ “ดับเพลิง” PD คืออะไร — และทำไมต้องวัดเป็นหน่วย pC PD คือประกายไฟจิ๋วที่เกิดใน “ช่องโหว่” ของฉนวน เช่น ฟองอากาศติดในเรซิน (Void) รอยต่อที่หลุดร่อน หรือขอบแหลมของตัวนำที่สนามไฟฟ้าเข้มข้นเกินไป แต่ละครั้งที่ประกายเกิด มันปล่อยประจุออกมาเป็นพัลส์สั้นๆ (นาโนวินาที) ที่วัดได้เป็น picocoulomb (pC) ตามมาตรฐาน IEC 60270 ซึ่งเป็นเกณฑ์สากลของการวัด PD แบบดั้งเดิม (Conventional PD Measurement) แต่ปริมาณประจุเพียงอย่างเดียวไม่พอตัดสิน ตัวชี้วัดที่สำคัญไม่แพ้กันคือ อัตราการเพิ่มขึ้นของ PD Activity ตามเวลา (Trend) — ตู้ที่ PD คงที่ 200 pC มาสามปี กับตู้ที่กระโดดจาก 100 เป็น 800 pC ในสองเดือน คนละเรื่องกันสิ้นเชิง ระบบมอนิเตอริ่งสมัยใหม่จึงเน้นเก็บแนวโน้มต่อเนื่องแทนการดูค่าจุดเดียว (Spot Measurement) 3 เทคโนโลยีเซ็นเซอร์หลัก: TEV, UHF และ Acoustic เพราะสัญญาณ PD เป็นพัลส์ความถี่สูงมาก การ “ดักฟัง” จึงมีได้หลายช่องทาง แต่ละแบบมีจุดแข็งต่างกัน — โครงการจริงมักใช้ผสมกัน: วิธีวัด หลักการ ช่วงความถี่ จุดแข็ง ข้อจำกัด TEV (Transient Earth Voltage) ดักความต่างศักย์ชั่วขณะบนผิวโลหะของตู้ 3-100 MHz ติดตั้งภายนอกตู้ ไม่ต้องดับไฟ สัญญาณเบาบาง อ่านเป็น dB ไม่ใช่…
Read More
Case Study: ไม่มีข้อมูล เท่ากับ ไม่มีสินค้า — Cold Chain 2026 กับ IoT Temperature Monitoring ที่ช่วยกู้การส่งมอบ

Case Study: ไม่มีข้อมูล เท่ากับ ไม่มีสินค้า — Cold Chain 2026 กับ IoT Temperature Monitoring ที่ช่วยกู้การส่งมอบ

Article
กรณีศึกษาจากสนามจริง: ผู้ประกอบการคลังสินค้าควบคุมอุณหภูมิแห่งหนึ่งในภาคตะวันออกของไทยเคยเจอสถานการณ์ที่ผู้ประกอบการ Cold Chain ทั่วโลกกำลังเผชิญในปี 2026 — ลูกค้าต่างประเทศขอ evidence ว่าสินค้าอยู่ในช่วงอุณหภูมิที่กำหนด ตลอดทั้งการเดินทาง ไม่ใช่แค่ตอนรับ-ส่งของ และเมื่อระบบเก่าแสดง Temperature Log ไม่ได้เพราะข้อมูลถูกเก็บแยกในแต่ละรถ แต่ละคลัง ผลลัพธ์คือการส่งมอบถูกปฏิเสธ พร้อมความเสี่ยงเสียชื่อเสียงที่ใหญ่กว่ามูลค่าสินค้าเสียหายเองหลายเท่า นี่ไม่ใช่เรื่องเฉพาะราย บทวิเคราะห์จาก Cold Chain Exhibition 2026 ชี้ว่ากฎระเบียบด้านการตรวจสอบย้อนกลับ (Traceability) และเอกสารดิจิทัลที่เข้มงวดขึ้น กำลังเปลี่ยนโฉมอุตสาหกรรมทั้งหมด โดยสรุปสถานการณ์ไว้ตรงๆ ว่า "ในยุคนี้ ไม่มีข้อมูล เท่ากับ ไม่มีสินค้า" (No data means no product) คลังสินค้าควบคุมอุณหภูมิ — ศัตรูที่แท้จริงไม่ใช่แค่ความเย็นที่หลุด แต่คือข้อมูลที่พิสูจน์ไม่ได้ว่าความเย็นไม่เคยขาด (ที่มา: Danny Gershoni, CC BY-SA 4.0) Problem: จุดอ่อน 3 ด่านของ Cold Chain แบบเดิม ด่าน สิ่งที่เกิดขึ้นจริง ผลกระทบ ในคลัง อุณหภูมิวัดด้วยเทอร์โมมิเตอร์แบบกระดาษ/ดิจิทัลแยกชิ้น คนเดินจดบันทึกวันละ 2-3 รอบ ช่วงที่ไม่มีคนจด (กลางคืน/ช่วงพักกะ) ไร้หลักฐาน หากคอมเพรสเซอร์ขัดข้อง 30 นาที ไม่มีใครรู้ ระหว่างขนส่ง Data Logger แบบใช้แล้วทิ้ง อ่านค่าได้เฉพาะเมื่อถึงปลายทาง รู้ว่าสินค้าพังตอนรับมอบแล้ว แก้ไขไม่ได้ เรียกคืนไม่ได้ เอกสาร Temperature Report ทำมือจากไฟล์แยกหลายแหล่ง ตอบ Audit ไม่ทันการณ์ ลูกค้า/หน่วยงานกำกับขอเอกสารย้อนหลัง 6 เดือน ต้องใช้คนไล่ทีละไฟล์เป็นวัน Solution: สถาปัตยกรรม Real-Time Monitoring 4 ชั้น แนวทางที่ผู้นำตลาด Cold Chain ใช้ตามบทวิเคราะห์ปี 2026 คือการลงทุนใน 4 องค์ประกอบที่ทำงานร่วมกัน: IoT Sensors ต่อเนื่อง — เซ็นเซอร์อุณหภูมิ/ความชื้นส่งข้อมูลทุก 1-5 นาที ทั้งในคลังและบนรถขนส่ง แทนการจดบันทึกด้วยมือ Cloud Integration — ข้อมูลจากทุกจุดไหลรวมสู่แพลตฟอร์มกลาง เชื่อมกับ WMS (จัดการคลัง), TMS (จัดการขนส่ง) และ ERP ให้เป็นชุดเดียว Exception Alerts — ระบบแจ้งเตือนเฉพาะเมื่อค่าเบี่ยงเบนจากช่วงกำหนด…
Read More
บทวิเคราะห์: Weibull Analysis — เปลี่ยนประวัติซ่อมที่นอนนิ่งใน CMMS ให้เป็นรอบเปลี่ยนอะไหล่ที่มีที่มา

บทวิเคราะห์: Weibull Analysis — เปลี่ยนประวัติซ่อมที่นอนนิ่งใน CMMS ให้เป็นรอบเปลี่ยนอะไหล่ที่มีที่มา

Article
โรงงานส่วนใหญ่ตั้งกำหนดเปลี่ยนอะไหล่จาก "ประสบการณ์" — หัวหน้าช่างบอกว่าปั๊มนี้ควรเปลี่ยนกระบอกสูบทุก 6 เดือน ก็ทำตามมาปีหนึ่ง โดยไม่มีใครเคยถามว่าตัวเลขนั้นมาจากไหน ผลคือโรงงานตกอยู่ใน 2 ขั้ว: เปลี่ยนเร็วเกินจำเป็น (เสียเวลาและอะไหล่) หรือ เปลี่ยนช้าเกินไป (เสียเครื่องจักรและการผลิต) มีเครื่องมือสถิติหนึ่งที่ตอบคำถามนี้ได้แบบมีหลักการ: การวิเคราะห์ Weibull บทความนี้เป็นบทวิเคราะห์ของ Honey Corporation ว่า Weibull Analysis ทำงานอย่างไร อ่านค่า β (Shape Parameter) อย่างไรให้เป็นภาษาบำรุงรักษา และทำไมเราถึงเห็นว่ามันคือทักษะที่ทีม reliability ของโรงงานไทยควรมีในปี 2026 รูปทรงของการแจกแจง Weibull เปลี่ยนไปตามค่า β — ค่าเดียวที่บอกธรรมชาติการพังของอุปกรณ์ทั้งชนิด "พังตอนเก่า" หรือ "พังสุ่มๆ" หรือ "พังตอนใหม่" (ภาพ: Wikimedia Commons) Weibull แก้ปัญหาอะไรในงานบำรุงรักษา ในความเป็นจริง การพังของอุปกรณ์ไม่ได้มาถึงวันครบกำหนดแบบนาฬิกา — มันกระจายตัวเป็นการแจกแจงความน่าจะเป็น Weibull Distribution คือโมเดลสถิติที่อธิบายการกระจาย "เวลาถึงความล้มเหลว" (time-to-failure) ได้แม่นที่สุดรูปแบบหนึ่งในงานวิศวกรรมความน่าเชื่อถือ ด้วยพารามิเตอร์เพียง 2 ตัว: β (Shape Parameter) — บอก "รูปแบบการพัง" ของอุปกรณ์ η (Scale Parameter / Characteristic Life) — บอก "ช่วงอายุที่ 63.2% ของอุปกรณ์พังแล้ว" เมื่อเอาข้อมูลอายุการใช้งานจริงของอุปกรณ์กลุ่มเดียวกัน (จาก CMMS หรือประวัติซ่อม) มา plot บนกระดาษ Weibull probability plot แล้วประมาณค่า β กับ η ทีมบำรุงรักษาจะสามารถตอบคำถามเชิงลึกได้ 3 ข้อ: (1) อุปกรณ์นี้พังแบบสุ่มหรือพังเพราะมานุษย์ของอายุ (2) ควรตั้งรอบเปลี่ยนวันที่เท่าไหร่จึงจะคุมความเสี่ยงได้ (3) ถ้าเป็นการพังแบบสุ่ม การตั้งรอบเปลี่ยนเชิงป้องกันไม่มีประโยชน์เลย — ต้องเปลี่ยนไปใช้การเฝ้าสภาพแทน อ่านค่า β ให้เป็นภาษาบำรุงรักษา ค่า β คือคำทำนายธรรมชาติของความล้มเหลว ตีความได้ตรงๆ แบบนี้: ค่า β ธรรมชาติการพัง นัยต่อกลยุทธ์บำรุงรักษา β < 1พังตอนอายุน้อย (infant mortality) — อัตราการพังลดลงเรื่อยๆ ตามอายุปัญหาอยู่ที่การติดตั้ง/คุณภาพการผลิต/คัดกรอง ไม่ใช่อายุ —…
Read More
How-to: ตั้งศูนย์เพลาด้วยเลเซอร์ 6 ขั้นตอน — กำจัด Misalignment ต้นตอแบริ่งพังซ้ำๆ ที่เปลี่ยนกี่ครั้งก็ไม่หาย

How-to: ตั้งศูนย์เพลาด้วยเลเซอร์ 6 ขั้นตอน — กำจัด Misalignment ต้นตอแบริ่งพังซ้ำๆ ที่เปลี่ยนกี่ครั้งก็ไม่หาย

Article
ในโลกของการบำรุงรักษาเชิงคาดการณ์ ทุกคนพูดถึงเซ็นเซอร์ AI และโมเดลทำนาย แต่มีต้นตอความเสียหายราคาแพงชนิดหนึ่งที่แก้ได้ด้วยเครื่องมือกล้องเลเซอร์ชิ้นเดียวภายในครึ่งวัน: ความคลาดเคลื่อนของศูนย์เพลา (Shaft Misalignment) สถิติสากลด้าน reliability ชี้ตรงกันมาหลายทศวรรษว่า ความคลาดเคลื่อนของศูนย์เพลาคือสาเหตุอันดับต้นของการเสียหายของแบริ่ง ซีล และคู่มือเพลา โดยเฉพาะเครื่องจักรหมุนที่เดินความเร็วสูง บทความนี้เป็นคู่มือแบบ How-to จาก Honey Corporation — อธิบายชนิดของ misalignment, ค่า tolerance ที่ยอมรับได้ตามความเร็วรอบ, และขั้นตอนตั้งศูนย์ด้วยเลเซอร์ 6 ขั้น ที่ทีมช่างของโรงงานทำตามได้จริงตั้งแต่ครั้งแรก คู่มือเพลา (Coupling) เชื่อมมอเตอร์กับชิ้นงาน — จุดเดียวที่ความคลาดเคลื่อนเพียงไม่กี่สิบไมโครเมตรจะถูกขยายเป็นแรงกระแทกนับล้านครั้งต่อชั่วโมง (ภาพ: Wikimedia Commons) Parallel vs Angular: เข้าใจศัตรู 2 แบบก่อนลงมือ Misalignment มี 2 แบบพื้นฐานที่มักเกิดร่วมกัน: Parallel (Offset) Misalignment — ศูนย์เพลาสองข้างขนานกันแต่ไม่อยู่แนวเดียวกัน เหมือนเส้นรถไฟสองสายที่เยื้องกัน ทำให้ coupling หมุนโค้งตลอดรอบ สร้างแรงสั่นความถี่สูงเป็น 2 เท่าของรอบเครื่อง (2×RPM) Angular (Gap) Misalignment — ศูนย์เพลาทำมุมต่อกัน เหมือนบันไดสองขั้นที่ลาดไม่เท่ากัน ทำให้ coupling บิดไป-กลับทุกรอบหมุน สร้างแรง axial vibration ที่ความถี่ 1×RPM และ 2×RPM ผสมกัน ในสนามจริงเกือบทุกกรณีคือแบบผสม — มีทั้ง offset และ angular ซ่อนอยู่ในหลายระนาบ ซึ่งเป็นเหตุผลที่การตั้งศูนย์ด้วยสายเทปหรือน้ำมันตรวจสอบขั้นพื้นฐานไม่เพียงพออีกต่อไปสำหรับเครื่องจักรสมัยใหม่ ตาราง Tolerance: ตัวเลขที่ต้องจำก่อนเปิดกล่องเครื่องมือ หลักการสำคัญ: ยิ่งเครื่องหมุนเร็ว ยิ่งต้องแม่น — ความคลาดเคลื่อนที่โรงงานจำนวนมากใช้กันจนชินคือค่าที่เขียนตามอกเขามาโดยไม่ได้คิด ตารางอ้างอิงที่ใช้กันทั่วไปในวงการตั้งศูนย์เลเซอร์ (ตามแนวทางมาตรฐานสากล เช่น แนวค่าที่ใช้กันในอุตสาหกรรมตามความเร็วรอบเครื่องจักร) มีหน้าตาแบบนี้: ความเร็วเครื่อง (RPM) Offset ที่ยอมรับ (mm) Angularity ที่ยอมรับ (mm/100mm) ผลกระทบถ้าเกิน 6000.200.20แบริ่งอายุสั้นลงเล็กน้อย เสียงดังขึ้น 1,8000.100.10แบริ่งร้อน น้ำมันรั่วที่ซีล เสียง 2×RPM ชัด 3,6000.050.05แบริ่งพังก่อนอายุมาก คู่มือเพลาสึก พลังงานสูญเปล่า แบริ่งความเร็วสูง / กังหัน0.02–0.030.02ความเสียหายรวดเร็ว อาจพังภายในหลักสิบชั่วโมง หมายเหตุ: ค่าข้างต้นเป็นค่าอ้างอิงทั่วไป — ผู้ผลิต coupling แต่ละรายและผู้ผลิตเครื่องจักรอาจกำหนดค่าเฉพาะที่เข้มงวดกว่านี้ ให้ยึดตามเอกสารของอุปกรณ์จริงเสมอ How-to:…
Read More
Case Study: DGA และ Duval Triangle ชี้ขาดสุขภาพหม้อแปลง 115/22 kV — จากก๊าซในน้ำมันสู่แผนซ่อมที่ตรงจุด

Case Study: DGA และ Duval Triangle ชี้ขาดสุขภาพหม้อแปลง 115/22 kV — จากก๊าซในน้ำมันสู่แผนซ่อมที่ตรงจุด

Article
หม้อแปลงกำลัง (Power Transformer) คืออุปกรณ์ที่แพงที่สุดชิ้นหนึ่งในสถานีรับไฟของโรงงาน และเป็นชิ้นเดียวที่เมื่อพัง มักพังแบบ "ไม่มี spare รออยู่" คำถามคลาสสิกของทีมไฟฟ้าโรงงานจึงเป็นเสมอ: "หม้อแปลงตัวนี้ยังอยู่ได้อีกนานแค่ไหน หรือควรเตรียมแผนเปลี่ยนแล้ว?" — เครื่องมือที่ตอบคำถามนี้ได้ดีที่สุดในโลกวิศวกรรมไฟฟ้า คือ DGA หรือ Dissolved Gas Analysis การตรวจวิเคราะห์ก๊าซที่ละลายในน้ำมันหม้อแปลง บทความนี้เล่าแบบ case study จริงจากงานวิจัยที่ตีพิมพ์ในวารสารวิชาการเทคโนโลยีอุตสาหกรรม มจพ.เหนือ ที่ใช้ผลตรวจน้ำมันหม้อแปลง 115/22 kV ขนาด 50 MVA ของการไฟฟ้าส่วนภูมิภาค มาวิเคราะห์ด้วยวิธี Duval Triangle เพื่อชี้ขาดสภาพความผิดปกติในห้อง OLTC (On-Load Tap Changer) — พร้อมถอดบทเรียนว่าโรงงานอุตสาหกรรมจะนำแนวทางเดียวกันไปใช้อย่างไร หม้อแปลงกำลังแรงสูง — หนึ่งในสินทรัพย์ที่มีมูลค่าสูงที่สุดของโรงงาน และต้องการเครื่องมือตรวจสุขภาพที่แม่นยำกว่าการมองภายนอก (ภาพ: Wikimedia Commons) หลักการ: หม้อแปลง "บอกความจริง" ผ่านก๊าซที่มันผลิต ฉนวนน้ำมันแร่ในหม้อแปลงมีปฏิกิริยาตอบสนองต่อความร้อนและประกายไฟแบบมีตรรกะสูง — เมื่อเกิดความผิดปกติเช่นความร้อนสูงเฉพาะจุด (thermal fault) หรืออาร์คไฟฟ้า โมเลกุลของน้ำมันและกระดาษฉนวนจะแตกตัวและปล่อยก๊าซเจาะจงชนิดออกมา ก๊าซเหล่านี้ละลายอยู่ในน้ำมันและเก็บตัวอยู่เงียบๆ จนเราดึงตัวอย่างไปตรวจ เหมือนการตรวจเลือดที่เผยโรคภายในของคน สัญลักษณ์สำคัญที่วิศวกรต้องจำให้ขึ้นใจ: ก๊าซ ต้นกำเนิด ชี้ว่าอะไรเมื่อค่าสูง Hydrogen (H₂)การแตกตัวของน้ำในน้ำมัน / coronaPartial Discharge หรือความร้อนต่ำ Methane (CH₄)การแตกตัวของน้ำมันที่อุณหภูมิปานกลางThermal fault ในน้ำมือ 150–300°C Ethylene (C₂H₄)การแตกตัวที่อุณหภูมิสูงมากThermal fault รุนแรง >300°C เช่น จุดเชื่อมหลวม Acetylene (C₂H₂)เกิดจากอาร์คไฟฟ้าเท่านั้น (อุณหภูมิ >700°C)Arcing — สัญญาณอันตรายระดับต้องทำการทันที CO และ CO₂การสลายตัวของกระดาษฉนวนเซลลูโลสฉนวนกระดาษเสื่อม — ความเสียหายที่ย้อนกลับไม่ได้ Case Study: พิสูจน์สภาพ OLTC หม้อแปลง 115/22 kV ด้วย Duval Triangle สถานการณ์: งานวิจัยของมจพ.เหนือ (วารสารวิชาการเทคโนโลยีอุตสาหกรรม ปีที่ 9 ฉบับที่ 2) นำประวัติผลตรวจน้ำมันในห้อง OLTC ของหม้อแปลง 115/22 kV 50 MVA หลายตัวมาวิเคราะห์ โดยโจทย์คือ OLTC เป็นอุปกรณ์กลไกที่สับเปลี่ยนแท็ปภายใต้โหลดทุกวัน จึงสึกหรอเร็วและตรวจสภาพยาก วิธีทำ: ทีมวิจัยนำค่าก๊าซหลัก 3 ตัว…
Read More