บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

Article
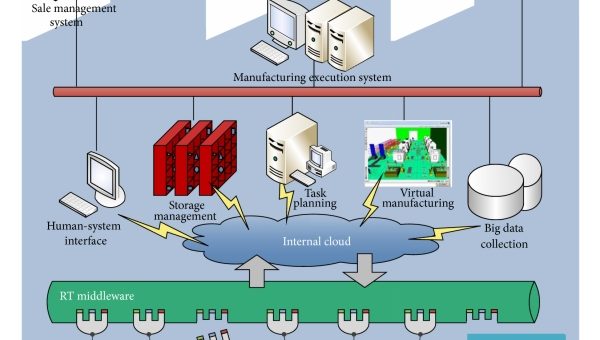
โมเดล AI ทำนายความเสียหายของเครื่องจักร (Predictive Maintenance) ตัวหนึ่งในโรงงานสิ่งทอทำงานได้แม่นยำมากในปีแรก แต่ปีที่สองความแม่นยำเริ่มถดลง เพราะสภาพเครื่องจักรเปลี่ยน โหลดการผลิตเปลี่ยน และพฤติกรรม "ปกติ" ของเครื่องจักรเลื่อนไปจากเดิม นี่คือปัญหา Model Drift ที่ทุกโรงงานต้องเจอ และเป็นคำถามเปิดของวงการว่า Digital Twin จะช่วยแก้ได้จริงหรือไม่ บทวิเคราะห์นี้มองปัญหาจากมุมวิศวกรรม ไม่ใช่มุมการตลาด ปัญหา Model Drift ในโรงงาน: ทำไมโมเดลเก่าเร็วจนน่าใจหาย โมเดล Anomaly Detection ส่วนใหญ่เรียนรู้จากข้อมูลในอดีต แล้วตั้งสมมติฐานว่าอนาคตจะคล้ายอดีต แต่ในโรงงานจริง ไม่มีอะไรนิ่ง: ชิ้นส่วนสึกหรอ, สูตรผลิตเปลี่ยน, ผู้ปฏิบัติงานเปลี่ยนวิธีเดินเครื่อง, อุณหภูมิแวดล้อมตามฤดูกาล หรือแม้แต่การซ่อมบำรุงที่ "ปรับ" พฤติกรรมเครื่องจักรไปโดยสิ้นเชิง ผลคือเกิดการแจ้งเตือนเท็จ (False Alarm) เพิ่มขึ้นเรื่อยๆ จนทีมซ่อมบำรุงเริ่มกด "Dismiss" โดยไม่อ่าน — และวันหนึ่ง Alarm จริงก็ถูกกดไปพร้อมกับพวกเท็จ แนวทางแก้แบบดั้งเดิมคือ การเทรนซ้ำ (Retraining) ด้วยข้อมูลใหม่ แต่คำถามคือใครจะ Label ข้อมูลว่าอะไรคือ "ปกติ" ในสถานการณ์ใหม่ และต้องรอนานแค่ไหนจึงจะมีข้อมูลเพียงพอ เพราะความเสียหายจริงเกิดไม่บ่อยนัก แนวคิดใหม่: Fleet Learning ผ่าน Digital Twin แนวคิดที่กำลังได้รับความสนใจคือการใช้ Digital Twin เป็น "ผู้เรียนรู้ร่วมกัน" ของกลุ่มเครื่องจักรลักษณะเดียวกัน แทนที่จะปล่อยให้แต่ละเครื่องเรียนรู้ลำพัง: สถาปัตยกรรม Smart Factory ยุคใหม่เชื่อมทุกชั้นข้อมูลเข้าด้วยกัน — Fleet Learning เป็นการขยายแนวคิดนี้สู่กลุ่มเครื่องจักรข้ามไซต์ (ภาพ: Wikimedia Commons, CC BY 4.0) หลักการคือ เมื่อเครื่องจักร A ในไซต์ 1 เจอ Failure Mode ใหม่และถูกบันทึกไว้ใน Twin ของมัน ความรู้นั้นสามารถถ่ายทอด (Transfer) ไปยังโมเดลของเครื่องจักร B, C, D ที่อยู่คนละไซต์แต่มีลักษณะเดียวกันได้ทันที เครื่องจักรอื่นๆ จึง "รู้" ล่วงหน้าโดยไม่ต้องเจอเองก่อน นี่คือความต่างสำคัญจากการเทรนโมเดลแบบเก่าที่ต้องรอเครื่องเสียจริงทีละตัวเพื่อสะสมประสบการณ์ วิเคราะห์กลไกทางเทคนิค: Twin ช่วยแก้ Drift ได้อย่างไร กลไก วิธีการทำงาน ข้อดี ข้อจำกัดที่ต้องยอมรับ Simulation Augmentationใช้ Twin จำลองสถานการณ์ที่ยังไม่เคยเกิดจริง สร้างข้อมูล Synthetic สำหรับเทรนโมเดลได้ข้อมูล Failure…
Read More
How-to: สร้าง Digital Twin ของระบบควบคุมเครื่องจักรเก่า — ถอด Logic สู่ Behavioral Twin ใน 6 ขั้นตอน

How-to: สร้าง Digital Twin ของระบบควบคุมเครื่องจักรเก่า — ถอด Logic สู่ Behavioral Twin ใน 6 ขั้นตอน

Article
โรงงานที่มีเครื่องจักรอายุ 10–20 ปีกำลังเจอปัญหาเดียวกัน: ระบบควบคุมเก่า อะไหล่หายาก และไม่มีใครกล้าแตะ Logic ที่เขียนไว้สมัยคนละยุค — เพราะแก้แล้วไลน์อาจหยุดทั้งวัน บทความนี้คือคู่มือทีละขั้น การสร้าง Digital Twin ของระบบควบคุมเครื่องจักรเก่า เพื่อทดสอบทุกอย่างในโลกเสมือนก่อนแตะโลกจริง แม้เครื่องจักรตัวนั้นจะอายุ 15 ปีแล้วก็ตาม ทำไมต้องเป็น Twin ของ "ระบบควบคุม" ไม่ใช่แค่หน้าตาเครื่องจักร Digital Twin ของเครื่องจักรเก่ามี 2 ระดับ ระดับแรกคือ 3D Model ที่สวยงามเหมาะกับการนำเสนอ ระดับที่สองคือ Behavioral Twin ที่จำลองพฤติกรรมการควบคุมจริง: Logic การทำงาน, Sequence การเริ่มเครื่อง, Interlock, และการตอบสนองต่อคำสั่ง ระดับที่สองนี่แหละที่มีคุณค่าทางวิศวกรรม เพราะมันทำให้คุณทดลองแก้ Logic, ทดสอบ Patch ใหม่ และฝึกคน โดยไม่เสี่ยงหยุดไลน์ผลิตจริง ระบบ SCADA เก่าของโรงงานจำนวนมากยังใช้งานอยู่ แต่ Logic ที่ซ่อนอยู่ด้านหลังคือความเสี่ยงเมื่อผู้พัฒนาดั้งเดิมไม่อยู่แล้ว — Twin ช่วยถอดรหัสนี้ได้ (ภาพ: Wikimedia Commons, CC0) ภาพรวมก่อนเริ่ม: สิ่งที่ต้องมี ขั้นตอน สิ่งที่ได้ ระยะเวลาอ้างอิง* 1. ตรวจจับ Logic เดิมคลัง Logic ที่ถอดออกมาได้ครบ1–2 สัปดาห์ 2. สร้าง Behavioral Modelโมเดลจำลองพฤติกรรมเครื่องจักร2–4 สัปดาห์ 3. เชื่อมข้อมูลจริง (Soft Sensor)ข้อมูลสถานะเครื่องจักรเก่าแบบเรียลไทม์1–3 สัปดาห์ 4. Validate ด้วยข้อมูลจริงค่าความคลาดเคลื่อนของโมเดลที่ยอมรับได้ต่อเนื่อง 5. ทดลองแก้ Logic บน TwinPatch ที่ทดสอบแล้วว่าปลอดภัยตามโจทย์ 6. Deploy + ฝึกทีมทีมใหม่ที่เข้าใจเครื่องจักรเก่าต่อเนื่อง *ระยะเวลาขึ้นกับความซับซ้อนของเครื่องจักรและความสมบูรณ์ของเอกสารเดิม ขั้นที่ 1: ถอด Logic เดิมออกจากเครื่องจักร (Logic Extraction) เริ่มจากดึงโปรแกรมควบคุม (Ladder Diagram, Function Block) ออกจาก PLC เดิมให้ได้มากที่สุด ปัญหาคือหลายโรงงานสูญเสีย Source Code ต้นฉบับ เหลือแค่ไฟล์ Compile แล้ว หรือระบบเก่าจน Software สำหรับเปิดไม่รองรับ OS ปัจจุบัน แนวทางที่ใช้ได้จริง: Reverse Engineering…
Read More
How-to: ทำ Explainable AI (SHAP/LIME) ให้โมเดล Predictive Maintenance — 5 ขั้นตอนทำให้ช่างเชื่อ AI จริงๆ

How-to: ทำ Explainable AI (SHAP/LIME) ให้โมเดล Predictive Maintenance — 5 ขั้นตอนทำให้ช่างเชื่อ AI จริงๆ

Article
โมเดล AI ทำนายความเสียหายของเครื่องจักรได้แม่นระดับ 90%+ แต่พอถูกถามว่า “ทำไมถึงบอกว่าเครื่องนี้เสี่ยง” กลับตอบไม่ได้ — นี่คือปัญหา black box ที่ทำให้ AI จำนวนมากติดอยู่ใน pilot ไม่มีวันถูกใช้จริงในสายการผลิต วิศวกรซ่อมบำรุงจะไม่มีวันเชื่อคำสั่งหยุดเครื่องที่ไม่มีเหตุผลรองรับ และผู้จัดการโรงงานก็ไม่กล้าเสี่ยงตัดสินใจตามตัวเลขที่อธิบายไม่ได้ บทความนี้เป็นคู่มือปฏิบัติ 5 ขั้นตอน สำหรับเพิ่มความโปร่งใสให้โมเดล predictive maintenance ด้วยเทคนิค Explainable AI (XAI) ปัญหา: ความแม่นยำไม่ใช่ข้ออ้างของความไว้วางใจ สถานการณ์มาตรฐานที่เราพบบ่อย: ทีม data scientist สร้างโมเดล gradient boosting ทำนายความเสี่ยงแบริ่งพังใน 14 วัน ได้ F1 สูงมากใน test set แต่พอ deploy จริง ช่างเทคนิคกลับแค่ “ดูเลข” แล้วเดินผ่าน เพราะโมเดลไม่เคยบอกว่าสัญญาณมาจากไหน — ความร้อน? การสั่น? หรือค่าไฟฟ้าที่ปนเปื้อน? ผลคือระบบถูกละเลยจนถูกถอดออกในที่สุด งานวิจัยด้าน XAI ในภาคอุตสาหกรรมชี้ตรงกันว่า การนำ AI ไปใช้กับงาน maintenance ล้มเหลวไม่ใช่เพราะโมเดลไม่แม่น แต่เพราะ คนในสายการผลิตไม่มีเครื่องมือตรวจสอบเหตุผลของโมเดลได้ ซึ่ง XAI แก้ปัญหานี้ตรงจุด 2 เทคนิคหลัก: LIME และ SHAP โมเดล gradient boosting หรือ neural network รุ่นใหม่แม่นกว่า linear model มาก แต่แลกมาด้วยความอธิบายไม่ได้ XAI จึงเข้ามาเป็น “สะพาน” ระหว่างความแม่นกับความเข้าใจ: LIME (Local Interpretable Model-agnostic Explanations) — สร้างโมเดลลินแมร์ตัวจิ๋วมาลอกเลียนพฤติกรรมของโมเดลใหญ่ “ในบริเวณใกล้” การทำนายหนึ่งๆ แล้วอ่านค่าสัมประสิทธิ์ จะรู้ทันทีว่า feature ไหนดันความน่าจะเป็นขึ้น ตัวไหนฉุดไว้ SHAP (SHapley Additive exPlanations) — ยืมแนวคิด Shapley value จากทฤษฎีเกม คำนวณ “ส่วนแบ่งความดีความชั่ว” ของ feature แต่ละตัวอย่างเป็นธรรม โดยเฉลี่ยผลจากทุก combination ที่เป็นไปได้ ให้ค่าที่ consistent และมีหลักทฤษฎีรองรับ โครงสร้าง hidden layer ของ neural network…
Read More
บทวิเคราะห์ Motor Current Signature Analysis (MCSA): เมื่อมอเตอร์คือเซ็นเซอร์ของตัวเอง — Pole Pass Frequency และ Sideband dB

บทวิเคราะห์ Motor Current Signature Analysis (MCSA): เมื่อมอเตอร์คือเซ็นเซอร์ของตัวเอง — Pole Pass Frequency และ Sideband dB

Article
บทวิเคราะห์: ทำไมสัญญาณที่ "พร้อมใช้" ที่สุดในโรงงาน กลับถูกมองข้ามมานานที่สุด ในโลกของ Condition Monitoring เราคุ้นเคยกับการติดเซ็นเซอร์วัดการสั่นสะเทือนบนตัวมอเตอร์ ติดเทอร์มอคัปเปิลวัดอุณหภูมิ หรือส่งน้ำมันเข้าห้องแล็บ แต่มีสัญญาณหนึ่งที่พร้อมใช้งานอยู่แล้วในทุกมอเตอร์ไฟฟ้า โดยไม่ต้องติดอะไรเพิ่มเลย — กระแสไฟฟ้าที่ไหลเข้าสู่ขดลวดสเตเตอร์ นี่คือจุดเริ่มต้นของเทคนิคที่ชื่อว่า Motor Current Signature Analysis (MCSA) หลักการง่ายๆ คือแรงบิดของมอเตอร์เหนี่ยวนำสัมพันธ์โดยตรงกับกระแสโรเตอร์ เมื่อชิ้นส่วนกลไกภายในเริ่มผิดปกติ ไม่ว่าจะเป็นแท่งนำของโรเตอร์หลุด ความไม่สมดุลของช่องอากาศ (Airgap Eccentricity) หรือแม้แต่โหลดกลไกที่กระตุก เฟร์ชชูเรชันของความเร็วรอบนั้นจะถูกสะท้อนกลับมาปรากฏเป็น Sideband รอบๆ ความถี่ไฟฟ้าในสเปกตรัมของกระแส นั่นคือเหตุผลที่นักวิเคราะห์บอกว่า "มอเตอร์คือเซ็นเซอร์ของตัวเอง" ขดลวดสเตเตอร์ — จุดที่สัญญาณกลไกทั้งหมดของมอเตอร์และโหลดถูก "มอดูเลต" ลงบนกระแสไฟฟ้า กลายเป็นข้อมูลวินิจฉัยที่เข้าถึงได้จากหน้าปัดเดียว | ภาพ: public domain คณิตศาสตร์ที่โรงงานควรรู้: Pole Pass Frequency สูตรสำคัญที่สุดของ MCSA คือการหา Pole Pass Frequency (PPF) ซึ่งกำหนดโดย: Slip (s) = (Ns - Nr) / Ns # Ns = synchronous speed, Nr = rated speed PPF = Slip × P × f_line # P = number of pole pairs Sideband = f_line ± n x PPF # n = 1, 2, 3, ... ตัวอย่างเชิงตัวเลข: มอเตอร์ 4 โพล (2 pole pairs) ความถี่ไฟฟ้า 50 Hz ความเร็วพร้อมนามมาตรฐาน 1,470 rpm จะมี Synchronous Speed 1,500 rpm คำนวณ Slip = 2% ดังนั้น PPF = 0.02 × 2…
Read More
Case Study: Oil Analysis กับระบบไฮดรอลิคที่ ISO 4406 เกินเกณฑ์ — จาก 21/19/16 สู่ 17/15/12 ใน 6 เดือน

Case Study: Oil Analysis กับระบบไฮดรอลิคที่ ISO 4406 เกินเกณฑ์ — จาก 21/19/16 สู่ 17/15/12 ใน 6 เดือน

Article
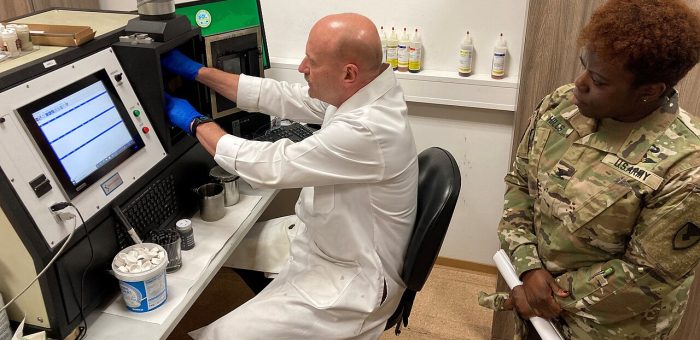
บทนำ: เมื่อ "เดือนดาว" เริ่มจากขวดน้ำมันเพียงขวดเดียว โรงงานผลิตชิ้นส่วนยนต์แห่งหนึ่งใน ระยะคุมภัย 1 ปี พบว่าเครื่องจักรไฮดรอลิคหยุดกะทันหันบ่อยครั้งขึ้นเรื่อยๆ จนกระทั่งช่างเทคนิคเริ่มชินกับคำว่า "อีกแล้ว" ทุกครั้งที่ไฟสัญญาณเตือนเครื่องตัดกำลังบนเครื่อง Press ขนาดใหญ่กะพริบ ฝ่ายบำรุงรักษาใช้แนวทาง Run-to-Failure มาตลอด เพราะ "เครื่องอื่นก็เป็นแบบนี้" และการหยุดเพื่อตรวจสภาพถือเป็นการรบกวนสายการผลิต จุดเปลี่ยนมาถึงเมื่อทีมวิศวกรเสนอแผนนำร่องที่แทบไม่ต้องลงทุนอะไรเลย: เก็บตัวอย่างน้ำมันส่งตรวจแล็บ ตามรอบเวลาที่กำหนด และติดตามผลเป็นตัวเลข ไม่ใช่ความรู้สึก ห้องแล็บวิเคราะห์น้ำมันอุตสาหกรรม — ผลวิเคราะห์จากที่นี่คือ "ผลตรวจเลือด" ของเครื่องจักร ที่บอกทั้งสุขภาพน้ำมันและสุขภาพชิ้นส่วนภายใน | ภาพ: U.S. Army, public domain ปัญหา: ทำไมการเปลี่ยนน้ำมันตามเวลาจึงไม่พอ โรงงานส่วนใหญ่เปลี่ยนน้ำมันตามรอบเวลา (Time-Based) เช่น ทุก 4,000 ชั่วโมงการทำงาน ซึ่งเป็นวิธีที่ง่ายและถูกต้องตามคู่มือ แต่มีข้อจำกัดสองด้าน ด้านแรกคือน้ำมันที่ยังใช้งานได้ดีถูกทิ้งก่อนวัยอันควร ด้านที่สองและอันตรายกว่าคือน้ำมันที่ "เสียก่อนเวลา" จากการปนเปื้อนน้ำ ความร้อนสูง หรืออนุภาคโลหะ ไม่ได้ถูกพบจนกว่าความเสียหายจะเกิดขึ้นแล้ว ในกรณีของโรงงานชิ้นส่วนยนต์นี้ ผลวิเคราะห์รอบแรกจากเครื่อง Press ตัวหลักพบค่าความสะอาดตามมาตรฐาน ISO 4406 อยู่ที่ 21/19/16 ในขณะที่ค่าเป้าหมายของระบบไฮดรอลิคแรงดันสูงควรอยู่ที่ 18/16/13 หรือดีกว่า ตัวเลขสามชั้นนี้แทนจำนวนอนุภาคต่อมิลลิลิตร ที่ขนาดมากกว่า 4 ไมครอน, 6 ไมครอน และ 14 ไมครอนตามลำดับ — โดยแต่ละเลขคือลอการิทึมของจำนวนอนุภาค (เลขเพิ่ม 1 = อนุภาคเพิ่มประมาณ 2 เท่า) น้ำมันไฮดรอลิค — ตัวกลางถ่ายทอดพลังงานที่ต้องการ "ความสะอาด" มากกว่าที่หลายโรงงานคิด เพราะอนุภาคแข็งขนาด 1–5 ไมครอนเข้าไปเกาะในช่องว่างภายในวาล์ว | ภาพ: public domain ทางแก้: โปรแกรม Oil Analysis 4 ขั้นตอน ทีมวิศวกรร่วมกับห้องแล็บออกแบบโปรแกรมตรวจสอบน้ำมันเชิงรุก 4 ขั้นตอน: จัดทำรายการเครื่องจักรและ Baseline — เก็บตัวอย่างน้ำมันจากทุกถังสำคัญ พร้อมระบุจุดเก็บตัวอย่างมาตรฐานให้ช่างทุกคนใช้จุดเดียวกันเพื่อความเปรียบเทียบได้ กำหนดเกณฑ์เป้าหมาย (Target Cleanliness) — ระบบไฮดรอลิคแรงดันสูงกำหนดที่ 18/16/13, Gearbox ที่ 17/15/12, น้ำมันหล่อลื่นแบริ่งที่ 16/14/11 เก็บตัวอย่างตามรอบสม่ำเสมอ — เครื่องวิกฤตทุกเดือน, เครื่องสำคัญทุก 3 เดือน โดยเก็บขณะเครื่องกำลังทำงานหรือหลังหยุดไม่เกิน 15 นาที ปฏิบัติตามผล (Act…
Read More
Vibration Analysis: อ่านลายเซ็นความถี่จากเครื่องจักรก่อนที่มันจะพัง — Deep Dive จาก FFT ถึง ISO 20816

Vibration Analysis: อ่านลายเซ็นความถี่จากเครื่องจักรก่อนที่มันจะพัง — Deep Dive จาก FFT ถึง ISO 20816

Article
ทำไม "เสียงเครื่องจักร" จึงโกหกคุณได้ แต่ "ค่าการสั่นสะเทือน" โกหกไม่ได้ ช่างเทคนิคที่เก่งที่สุดในโรงงานมักบอกได้ว่าเครื่องจักรกำลังจะพัง "จากเสียง" — แต่หูมนุษย์มีข้อจำกัดสองข้อที่ยอมรับกันในวงวิศวกรรมเครื่องกล ข้อแรกคือหูคนได้ยินตั้งแต่ 20 Hz ถึงราว 20,000 Hz ในขณะที่สัญญาณบ่งชี้ความเสียหายระยะแรกของลูกสูบมักเกิดที่ความถี่ต่ำกว่านั้น ข้อสองคือสมองมนุษย์ "ชิน" กับเสียงที่เพิ่มขึ้นอย่างค่อยเป็นค่อยไปในแต่ละวัน จนกระทั่งวันหนึ่งเครื่องหยุดกลางคัน Vibration Analysis คือการเปลี่ยนสัญญาณการสั่นสะเทือนให้กลายเป็นตัวเลขที่วัดได้ ตรวจสอบซ้ำได้ และเปรียบเทียบข้ามเวลาได้ ด้วยหลักการง่ายๆ ว่า ทุกความผิดปกติเชิงกล มีลายเซ็นความถี่เป็นของตัวเอง ลูกสูบ (Rolling Element Bearing) — แหล่งกำเนิดความถี่บกพร่องที่นำไปคำนวณเป็น BPFO, BPFI, BSF และ FTF ได้ | ภาพ: public domain หลักการ 4 ขั้น: จากคลื่นสั่นสะเทือนสู่การวินิจฉัย ขั้นตอนการวิเคราะห์มาตรฐานในอุตสาหกรรมคือ (1) เก็บสัญญาณด้วยเซ็นเซอร์วัดความเร่ง (Accelerometer) ที่ติดตั้งบนตัวเครื่องจักรใกล้จุดรับน้ำหนัก (2) แปลงสัญญาณแรงดันไฟฟ้าให้เป็นหน่วยความเร่ง g ผ่านตัวเก็บประจุภายในเซ็นเซอร์แบบ Piezoelectric (3) นำข้อมูลดิบผ่านการแปลงฟูเรียร์ (FFT) เพื่อแยกสัญญาณออกเป็นแต่ละความถี่ และ (4) ตีความความถี่ที่โดดออกมาเทียบกับความถี่บกพร่องทางทฤษฎีของเครื่องจักร เซ็นเซอร์ 100 mV/g เป็นสเปกที่พบมากที่สุดในโรงงานอุตสาหกรรม ส่วนความถี่ในการเก็บข้อมูล (Sampling Rate) ต้องเป็นอย่างน้อย 2.56 เท่าของความถี่สูงสุดที่สนใจตามทฤษฎีบทของไนควิสต์ เช่น ต้องการวิเคราะห์ถึง 10 kHz ต้องเก็บข้อมูลที่ 25.6 kHz การติดตั้งเซ็นเซอร์วัดค่าที่จุดสำคัญ ตำแหน่งและวิธีติดตั้ง (แม่เหล็ก/สติ๊ก/ยึดสกรู) มีผลต่อความถี่สูงสุดที่วัดได้จริง | ภาพ: NASA, public domain ตารางลายเซ็นความถี่: อ่านตัวโรคเครื่องจักรให้เป็น ความถี่ที่พบ สาเหตุที่พบบ่อย สิ่งที่ควรตรวจสอบต่อ 1×RPMความไม่สมดุล (Unbalance)น้ำหนักเพิ่มจากเศษวัสดุหรือฝุ่นเป็นก้อนบนใบพัด หรือโรเตอร์โค้งงอ โดยเฟสของสัญญาณจะนิ่งไม่เปลี่ยน 2×RPMเพลาไม่ได้แนว (Misalignment)ตรวจการจัดแนวเพลาด้วยเลเซอร์ ทั้งแนวออฟเซ็ตและแนวมุม BPFO / BPFIลูกสูบเสียหาย (แหวนนอก/ใน)โดยเฉพาะเมื่อมี Sideband ของ FTF ปรากฏร่วมด้วย หมายถึงการสึกหรอลุกลาม ราว 0.42–0.48×RPMฟิล์มน้ำมันไม่เสถียร (Oil Whirl)ตรวจระดับความหนืดน้ำมัน แรงดันน้ำมันหล่อลื่น และ Load ของ Sleeve Bearing — มักพบในเครื่องจักรความเร็วสูง ความถี่ลูกผสม (Line Frequency ×…
Read More
Soft Sensor (เซ็นเซอร์เสมือน): คำนวณค่าที่วัดไม่ได้จากข้อมูลที่มีอยู่แล้ว — หัวใจที่ถูกลืมของ Digital Twin ระดับกระบวนการ

Soft Sensor (เซ็นเซอร์เสมือน): คำนวณค่าที่วัดไม่ได้จากข้อมูลที่มีอยู่แล้ว — หัวใจที่ถูกลืมของ Digital Twin ระดับกระบวนการ

Article
ในโรงงานกระบวนการผลิต (Process Industry) มีค่าบางอย่างที่วิศวกร "อยากรู้" แต่วัดตรงๆ ไม่ได้ หรือวัดได้แต่ช้าเกินไป ซับซ้อนเกินไป หรือเปลืองเกินไป — ไม่ว่าจะเป็นความเข้มข้นของสารในถังปฏิกิริยา คุณภาพของผลิตภัณฑ์กลางกระบวนการ หรืออัตราการไหลมวลในท่อที่มีสารกัดกร่อน วิธีแก้ดั้งเดิมคือหยิบตัวอย่างส่งแล็บ ซึ่งใช้เวลาเป็นชั่วโมง ทำให้ค่าที่ได้ "สะท้อนอดีต" ไม่ใช่สิ่งที่เกิดขึ้นในถังตอนนี้ Soft Sensor (หรือเรียกอีกชื่อว่า Virtual Sensor / Inferential Sensor) คือคำตอบของปัญหานี้ — มันไม่ใช่ฮาร์ดแวร์ แต่เป็น "เซ็นเซอร์ชิ้นใหม่ที่เกิดจากซอฟต์แวร์" โดยนำค่าจากเซ็นเซอร์จริงหลายสิบถึงหลายร้อยตัวที่มีอยู่แล้วในระบบควบคุม มาประมวลผลร่วมกันเพื่อ "คำนวณ" ค่าที่ต้องการนั้นออกมาแบบเรียลไทม์ โดยไม่ต้องติดตั้งอะไรเพิ่มบนท่อหรือถังเลย Soft Sensor ทำงานอย่างไร — หลักการพื้นฐาน หัวใจของ Soft Sensor อยู่ที่แนวคิดทางทฤษฎีการควบคุมที่เรียกว่า State Observer — ระบบที่ใช้สัญญาณที่วัดได้หลายตัว มาประมาณ "สถานะภายใน" (internal state) ของกระบวนการที่มองไม่เห็น ลองนึกภาพถังปฏิกิริยาเคมี: เราวัดอุณหภูมิ ความดัน อัตราการป้อนวัตถุดิบ และกำลังกวนได้ แต่ความเข้มข้นของผลิตภัณฑ์ในถังต้องรอผลแล็บ Soft Sensor จะเรียนรู้ความสัมพันธ์ระหว่างสัญญาณเหล่านี้กับผลแล็บในอดีต แล้วใช้โมเดลนั้นทำนายความเข้มข้นทุก ๆ วินาที แทนที่จะรอชั่วโมงเดียว แผนภาพหลักการทำงานแบบ Predict–Correct ของ Kalman Filter — อัลกอริทึมตระกูล State Observer คลาสสิกที่ถูกนับเป็น Soft Sensor ยุคแรก (ภาพ: Wikimedia Commons, CC BY-SA 3.0) อัลกอริทึมที่ถูกยกให้เป็นตัวอย่างคลาสสิกของ Soft Sensor คือ Kalman Filter — อัลกอริทึมที่รับชุดการวัดที่มี noise เข้ามาต่อเนื่อง แล้วประมาณค่าตัวแปรที่ไม่รู้ค่าออกมาพร้อมช่วงความไม่แน่นอนของการประมาณ ส่วนการ implement ยุคใหม่นิยมใช้ Neural Network หรือ Fuzzy Computing ซึ่งจับความสัมพันธ์แบบไม่เชิงเส้น (non-linear) ที่ซับซ้อนได้ดีกว่าสมการคณิตศาสตร์แบบดั้งเดิม เปรียบเทียบ Soft Sensor กับเซ็นเซอร์จริงและการวิเคราะห์ในแล็บ ประเด็นเปรียบเทียบ เซ็นเซอร์จริง (Hardware Sensor) การเก็บตัวอย่างส่งแล็บ (Lab Analysis) Soft Sensor (Virtual Sensor) ความถี่ของข้อมูล ต่อเนื่อง (วินาที–มิลลิวินาที) ต่ำมาก (ทุก 2–8…
Read More
บทวิเคราะห์: Digital Twin ออกจากห้วงนำร่องปี 2026 — ทำไม Predictive Maintenance กลายเป็น use case แรกที่ขยายสู่ทั้งโรงงาน

บทวิเคราะห์: Digital Twin ออกจากห้วงนำร่องปี 2026 — ทำไม Predictive Maintenance กลายเป็น use case แรกที่ขยายสู่ทั้งโรงงาน

Article
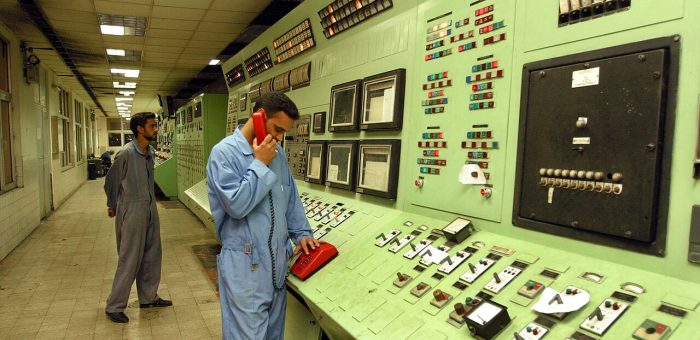
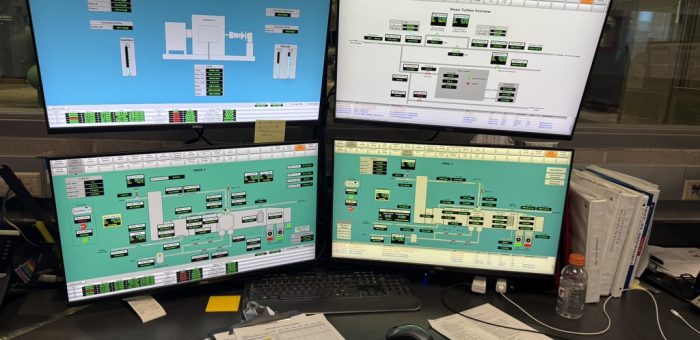
คำถามที่เปลี่ยนไป — สองปีก่อน คำถามที่ผู้บริหารโรงงานถามเรื่อง Digital Twin คือ "มันคุ้มไหม" ปี 2026 คำถามกลายเป็น "จะขยายจากนำร่องสู่ทั้งโรงงานได้อย่างไร" รายงานแนวโน้มอุตสาหกรรมการผลิตปี 2026 จากหลายสำนักวิเคราะห์ระดับโลกสะท้อนภาพเดียวกัน: Digital Twin และ Smart Factory กำลังก้าวพ้นช่วงทดลอง (Pilot Phase) สู่การใช้งานจริงในระดับองค์กร โดยเฉพาะในงานมอนิเตอร์เครื่องจักรเรียลไทม์และการบำรุงรักษาเชิงคาดการณ์ (Predictive Maintenance) การเปลี่ยนแปลงนี้สำคัญเพราะเกือบทศวรรษที่ผ่านมา เทคโนโลยีโรงงานอัจฉริยะติดอยู่ที่ "Pilot Purgatory" — นำร่องเสร็จ ทำได้จริง แต่ขยายไม่ได้ ครั้งนี้ต่างจากเดิมเพราะตัวแปรหลายตัวเปลี่ยนพร้อมกัน ห้องควบคุมโรงงาน — จุดที่ข้อมูลจาก Digital Twin ต้องมาบรรจบเป็นการตัดสินใจจริง ไม่ใช่แค่ภาพสวยบนจอ (ภาพ: Wikimedia Commons) ทำไมครั้งนี้ถึงออกจาก Pilot ได้จริง: 4 ตัวแปรที่พร้อมพร้อมกัน จากที่เราสังเกตจากงานวางระบบให้โรงงานอุตสาหกรรม การออกจากห้วงนำร่องของ Digital Twin ปี 2026 เกิดจากตัวแปร 4 ตัวที่สุกพร้อมกัน: ข้อมูลเรียลไทม์ราคาถูกลงมาก — เซ็นเซอร์วัดอุณหภูมิ แรงสั่นสะเทือน แรงดัน ความเร็วรอบ และพลังงาน พร้อมโปรโตคอลมาตรฐานอย่าง OPC UA (IEC 62541) และ MQTT ทำให้ต้นทุนการ "เติมเซ็นเซอร์" ให้เครื่องจักรเดิมลดลงจนคุ้มค่าในเชิงพาณิชย์ — เฉพาะงานแรงสั่น เซ็นเซอร์เร่งความเร็วแบบ MEMS รุ่นอุตสาหกรรมปัจจุบันสุ่มข้อมูลได้ระดับหลัก kHz เพียงพอต่อการวิเคราะห์ FFT หาความผิดปกติของลูกปืนและเฟืองตามโซนความรุนแรงของมาตรฐาน ISO 10816/20816 Edge Computing เสถียรแล้ว — การประมวลผลที่ตู้คอนโทรลหรือ Edge Gateway ทำให้การตรวจจับความผิดปกติเกิดขึ้นในหลักมิลลิวินาที ไม่ต้องรอขึ้นคลาวด์ ลดภาระแบนด์วิดท์และความเสี่ยงจากเน็ตขาด AI ตรวจจับความผิดปกติได้จริง — โมเดลเรียนรู้พฤติกรรมปกติของเครื่องจักรแต่ละตัว แล้วแจ้งเตือนเมื่อพฤติกรรมเบี่ยงเบน โดยไม่ต้องรอ failure label ที่มีน้อยมากในโรงงานจริง การผสานระบบที่จำเป็นเริ่มเป็นมาตรฐาน — Digital Twin + CMMS (ระบบซ่อมบำรุง) + ERP + Edge + 5G กำลังถูกออกแบบให้ทำงานร่วมกันตั้งแต่ต้น ไม่ใช่ต่อทีหลัง เซ็นเซอร์ IIoT ติดตั้งภาคสนามเพื่อมอนิเตอร์คุณภาพน้ำและอากาศ — โมเดลมูลค่าเดียวกันกับที่ใช้กับแรงสั่น อุณหภูมิ และแรงดันในงานบำรุงรักษาเชิงคาดการณ์ (ภาพ:…
Read More
Smart Materials ในโรงงานอุตสาหกรรม: เมื่อวัสดุกลายเป็นเซ็นเซอร์และ Actuator ไปพร้อมกัน

Smart Materials ในโรงงานอุตสาหกรรม: เมื่อวัสดุกลายเป็นเซ็นเซอร์และ Actuator ไปพร้อมกัน

Article
ถ้ามองย้อนไปสิบปีที่แล้ว "วัสดุ" ในโรงงานคือสิ่งที่ถูกซื้อมา ถูกใช้ และถูกเปลี่ยนเมื่อเสีย — ไม่มีส่วนร่วมในระบบดิจิทัลเลย แต่ในปี 2026 แนวคิดกำลังพลิกไปจากเดิม: วัสดุอัจฉริยะ (Smart Materials) กลายเป็น "โหนดข้อมูลชิ้นหนึ่งของระบบ IIoT" ที่รู้สภาพตัวเอง สื่อสารได้ และตอบสนองต่อสภาพแวดล้อมโดยไม่ต้องรอคำสั่งจากภายนอก รายงานเทรนด์อุตสาหกรรมล่าสุดถึงกับจัดให้ Smart Materials เป็นหนึ่งใน 6 เทรนด์หลักของการผลิตปี 2026 พร้อมคาดการณ์มูลค่าตลาดระดับ 1.33 แสนล้านดอลลาร์ภายในปี 2030 บทความนี้เจาะลึกกลไกทางฟิสิกส์ของวัสดุอัจฉริยะ 4 ตระกูลหลักที่เริ่มใช้งานจริงในภาคอุตสาหกรรม พร้อมชี้จุดที่วิศวกรโรงงานควรประเมินก่อนตัดสินใจนำไปใช้ วัสดุอัจฉริยะต่างจากวัสดุทั่วไปอย่างไร วัสดุทั่วไปมีสมบัติคงที่ (Passive) — แข็งแรงเท่าเดิม นำความร้อนเท่าเดิมไม่ว่าสภาวะรอบตัวจะเปลี่ยนไปแค่ไหน วัสดุอัจฉริยะต่างออกไปตรงที่มีสมบัติที่ ตอบสนองต่อสิ่งเร้า (Stimuli-Responsive) อย่างตั้งใจ ไม่ว่าจะเป็นความร้อน แรงสั่น สนามไฟฟ้า หรือความชื้น เมื่อสิ่งเร้าเปลี่ยน โครงสร้างระดับโมเลกุลของวัสดุจัดตัวใหม่ ทำให้เกิดการเปลี่ยนรูป สร้างประจุไฟฟ้า หรือเปลี่ยนสีอย่างย้อนกลับได้ จุดที่ทำให้เรื่องนี้สำคัญกับคนทำ IIoT คือ เมื่อวัสดุ "ตอบสนอง" ได้เอง เราสามารถอ่านค่าการตอบสนองนั้นออกมาเป็นข้อมูล หรือใช้มันเป็นตัวขับ (Actuator) ได้โดยตรง — วัสดุจึงกลายเป็นทั้งเซ็นเซอร์และอินสตรูเมนต์ในชิ้นเดียว ลดจำนวนอุปกรณ์เสริมที่ต้องติดตั้งบนเครื่องจักร เซ็นเซอร์เพียโซอิเล็กทริกแบบแผ่น — หนึ่งในรูปแบบที่พบมากที่สุดของวัสดุอัจฉริยะในงาน Monitor แรงสั่นสะเทือนเครื่องจักร (ภาพ: Wikimedia Commons) 4 ตระกูลวัสดุอัจฉริยะที่ใช้งานจริงในโรงงาน 1. Piezoelectric — วัสดุที่แปลงแรงกดเป็นไฟฟ้า ผลึกเพียโซอิเล็กทริกเช่น PZT (Lead Zirconate Titanate) จะเกิดประจุไฟฟ้าบนผิวเมื่อถูกกดหรือสั่น หลักการนี้ถูกใช้สองทางคู่ขนานกัน: ทางแรกคือเป็นเซ็นเซอร์วัดแรงสั่นความถี่สูง (เหมาะกับงาน Vibration Analysis ของลูกสูบ ปั๊ม และแบริ่งความเร็วสูงที่สัญญาณอยู่ในย่าน kHz) ทางที่สองคือ Energy Harvesting — ใช้แรงสั่นเหลือทิ้งจากเครื่องจักรสร้างไฟฟ้าระดับมิลลิวัตต์เลี้ยงเซ็นเซอร์ไร้สายแบบไม่ต้องเปลี่ยนแบตเตอรี่ ซึ่งเปลี่ยนเกมการติดตั้งเซ็นเซอร์บนเครื่องจักรหมุนที่เดิมต้องวางสายไฟข้ามจุดหมุน 2. Shape Memory Alloy (SMA) — โลหะที่จำรูปและกลับตัวเองได้ โลหะผสมนิกเกิล-ไทเทเนียม (NiTi) สามารถ "จำ" รูปร่างที่ตั้งโปรแกรมไว้ แล้วกลับไปหารูปนั้นเมื่อได้รับความร้อนหรือกระแสไฟฟ้า ในโรงงาน SMA ถูกใช้ทำ Actuator ขนาดเล็กที่มีอัตราส่วนแรงต่อน้ำหนักสูงและกลไกน้อยชิ้นกว่า ตั้งแต่วาล์วนิวแมติกทดแทน คลัตช์แบบอ่อนตัวเมื่อร้อน (ป้องกัน Overload) ไปจนถึงข้อต่อกันสั่นสะเทือนในโครงสร้างอาคารและงานยานยนต์ กลไก Shape Memory Effect: โครงผลึกเปลี่ยนเฟสระหว่างมาร์เทนไซต์ (เย็น)…
Read More
บทวิเคราะห์: Anti-Surge Control — ทำไม Recycle Valve ตัวเดียวที่เปิดไม่ทันใน 200 มิลลิวินาที ชี้ขาดชะตากรรมของคอมเพรสเซอร์

บทวิเคราะห์: Anti-Surge Control — ทำไม Recycle Valve ตัวเดียวที่เปิดไม่ทันใน 200 มิลลิวินาที ชี้ขาดชะตากรรมของคอมเพรสเซอร์

Article
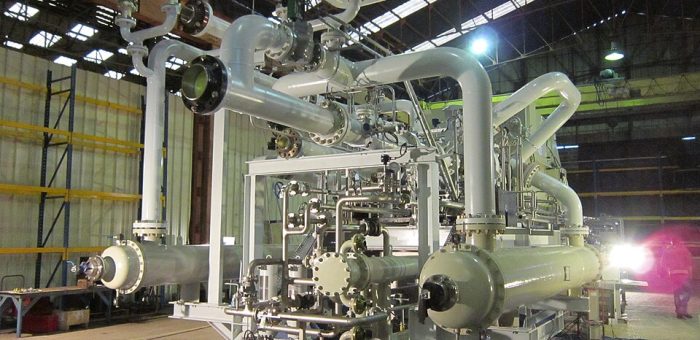
ในบรรดา Loop ควบคุมทั้งหมดในโรงงานโปรเซส มี Loop หนึ่งที่ไม่มีสิทธิ์ล้มเหลว — Anti-Surge Control ของ Centrifugal Compressor เพราะเมื่อเกิด Surge ขึ้นแล้ว แรงสั่นสะเทือนที่กระทบ Impeller, Thrust Bearing และ Dry Gas Seal จะทำลายเครื่องจักรภายในเวลาเพียงไม่กี่วินาที ผลที่ตามมาคือการเปลี่ยน Rotor ทั้งชุดและเวลาหยุดผลิตที่ยาวนานต่อทุกเหตุการณ์ บทวิเคราะห์นี้ถอดรหัสว่า Surge เกิดขึ้นได้อย่างไร และเพราะเหตุใดหัวใจของการป้องกันจึงอยู่ที่วาล์วตัวเดียวที่ต้องเปิดทันภายในระดับร้อยมิลลิวินาที Centrifugal Compressor ติดตั้งบน Skid พร้อมระบบประกอบ — หน้างานจริงในอุตสาหกรรมโปรเซส (ภาพ: Wikimedia Commons) Surge คืออะไร: วินาทีที่แรงดันไหลย้อนกลับ Centrifugal Compressor เสถียรเฉพาะเมื่อ Flow สูงกว่าค่าต่ำสุดของแต่ละความเร็วรอบและอัตราส่วนความดัน เมื่อ Flow ตกต่ำกว่าจุดนั้น (Surge Point) เครื่องจะไม่สามารถรักษา Differential Pressure ไว้ได้ แก๊สแรงดันสูงด้าน Discharge จะไหลย้อนกลับผ่านเครื่อง ความดันคายตัว เครื่องจักรสร้าง Flow ใหม่ชั่วขณะ แล้ววงจรก็ซ้ำไปซ้ำมา — นี่คือ Surge โดยในเครื่องขนาดเล็กวงรอบการไหลย้อนเกิดที่ความถี่ราว 10–20 Hz สร้างแรงกระชากซ้ำๆ บนชิ้นส่วนหมุนทั้งหมด ความน่ากลัวของ Surge อยู่ที่ความเร็วในการทำลาย: เหตุการณ์เพียง 1–2 วินาทีก็เพียงพอจะทำให้ใบพัดเกิด Fatigue Cracking จากการสั่นพ้อง Thrust Bearing รับแรงเพลามหาศาลระหว่างการไหลย้อน และ Dry Gas Seal เสียหายจากการกลับด้านของ Differential Pressure หลายเหตุการณ์ที่รายงานต่อกันมาจบด้วยการเปลี่ยน Rotor ทั้งชุด Surge Control Line: เส้นเบี่ยง 10–15% ที่ซ่อนความหมายไว้ Anti-Surge Controller คำนวณจุดทำงานของเครื่องแบบ Real-time (มักพล็อตเป็น Head vs Flow หรือ Pressure Ratio vs Reduced Flow) แล้วเทียบกับ Surge Limit Line ที่เก็บไว้ในตัวควบคุม ทางปฏิบัติจะวาง Surge Control Line แบบเว้นระยะ Flow Margin ประมาณ 10–15%…
Read More