Control Valve และ Smart Positioner: Final Control Element ที่ถูกมองข้าม — เมื่อ Control Loop ที่แก้ไม่ได้ส่วนใหญ่ มีต้นตออยู่ที่วาล์ว

Control Valve และ Smart Positioner: Final Control Element ที่ถูกมองข้าม — เมื่อ Control Loop ที่แก้ไม่ได้ส่วนใหญ่ มีต้นตออยู่ที่วาล์ว

Article
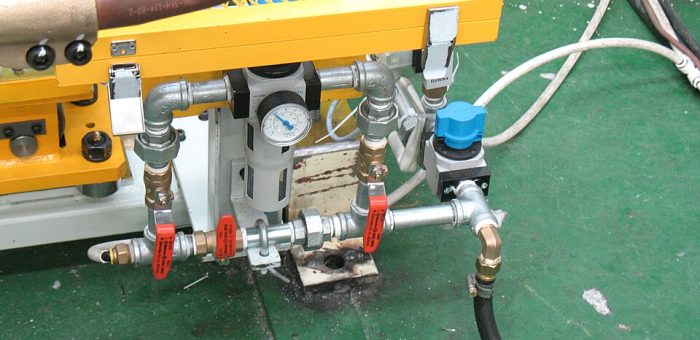
ในโลกของ Process Automation หลายคนให้ความสำคัญกับ DCS, PID Algorithm และ Advanced Process Control แต่มักลืมว่าคำสั่งควบคุมทั้งหมดต้องผ่านอุปกรณ์กลไกชิ้นเดียวก่อนถึงกระบวนการผลิตจริง — Control Valve ประสบการณ์จากโครงการจริงหลายแห่งชี้ตรงกันว่า เมื่อ Control Loop หนึ่งแกว่งไม่หยุด ทั้งที่ Tuning ถูกต้องแล้ว สาเหตุมักไม่ได้อยู่ที่ตัวควบคุม แต่อยู่ที่วาล์วที่มี Hysteresis สูง, Stem Friction หรือ Positioner ที่หมดอายุการใช้งาน Final Control Element: จุดที่ Signal ไฟฟ้ากลายเป็นการไหลจริง Control Loop ปิด (Closed Loop) ประกอบด้วย 3 ส่วนหลัก: Sensor/Transmitter ที่วัดค่า Process Variable, Controller ที่คำนวณ Output และ Final Control Element ที่ลงมือปรับกระบวนการจริง ในอุตสาหกรรมโปรเซส ส่วนสุดท้ายนี้คือ Control Valve นั่นเอง — รับสัญญาณ 4–20 mA จาก Controller แปลงเป็นตำแหน่ง Stem แล้วเปลี่ยนอัตราการไหลของ Fluid ในท่อ ประเด็นสำคัญคือ วาล์วเป็นชิ้นส่วนกลไกที่เคลื่อนไหวต่อเนื่องเพียงชิ้นเดียวใน Loop ทั้งหมด Transmitter ไม่มีชิ้นส่วนหมุน 100 รอบ/วินาที แต่วาล์วอาจต้องขยับตำแหน่งหลายพันครั้งต่อวันในโหมดควบคุมที่แรง ความเสียดสีที่สะสมจึงเป็นตัวแปรที่เปลี่ยนไปตลอดเวลา และเป็นสาเหตุที่ Loop Performance ถดลงโดยไม่มีใครสังเกตเห็น Control Valve พร้อม Positioner ติดตั้งในโรงงานโปรเซสจริง — สังเกต Actuator ด้านบนและ Positioner ที่ยึดอยู่กับ Yoke (ภาพ: Wikimedia Commons) Positioner ไม่ใช่ "อุปกรณ์เสริม" แต่คือสมองของวาล์ว Positioner ทำหน้าที่เปรียบเทียบ Setpoint ตำแหน่งจาก Controller กับตำแหน่งจริงของ Stem แล้วปรับแรงดันอากาศเข้า Actuator จนกว่าตำแหน่งจริงจะตรงกับคำสั่ง — โดยพื้นฐานแล้ว Positioner คือ Controller ตัวที่สองที่ทำงานอยู่ในระดับตำแหน่ง (Position Loop) ซ้อนอยู่กับ Process Loop หลัก วาล์วที่ไม่มี…
Read More
TinyML ในโรงงานอุตสาหกรรม: ฝาก AI ลงไมโครคอนโทรลเลอร์ขนาด KB เพื่อตรวจสุขภาพเครื่องจักรแบบ Real-time โดยไม่ต้องพึ่งคลาวด์

TinyML ในโรงงานอุตสาหกรรม: ฝาก AI ลงไมโครคอนโทรลเลอร์ขนาด KB เพื่อตรวจสุขภาพเครื่องจักรแบบ Real-time โดยไม่ต้องพึ่งคลาวด์

Article
หลายโรงงานที่เริ่มใช้ AI ตรวจสอบสถานะเครื่องจักรมักเจอทางตันเดียวกัน คือสถาปัตยกรรมแบบ “ส่งข้อมูลขึ้นคลาวด์แล้วค่อยวิเคราะห์” ทำงานได้ดีในห้องทดลอง แต่เมื่อลงสนามจริงกับเซ็นเซอร์หลายร้อยจุด ปัญหาที่ตามมาคือค่า bandwidth, latency หลายร้อยมิลลิวินาที และความเสี่ยงเมื่ออินเทอร์เน็ตขาดกลางคัน คำตอบที่วงวิศวกร embedded เลือกใช้มากขึ้นเรื่อยๆ ในปี 2026 คือ TinyML — การฝากโมเดล Machine Learning ที่ผ่านการบีบอัดลงไปรันบนไมโครคอนโทรลเลอร์ (MCU) ที่มี RAM เพียงหลักร้อยกิโลไบต์ กินไฟระดับมิลลิวัตต์ และตัดสินใจได้เองที่ขอบเครือข่ายโดยไม่ต้องส่งข้อมูลดิบออกไปไหนเลย TinyML คืออะไร และทำไมโรงงานควรสนใจ TinyML คือสาขาย่อยของ Machine Learning ที่เน้นการ deploy และรันโมเดลบนอุปกรณ์ embedded ที่มีทรัพยากรจำกัด เช่น ไมโครคอนโทรลเลอร์ที่มี RAM เพียง “หลักสิบถึงหลักร้อยกิโลไบต์” flash จำกัด ไม่มี GPU และมักรันบน bare-metal หรือ RTOS เบาๆ ข้อจำกัดพวกนี้บังคับให้ทุกการตัดสินใจทางวิศวกรรมต้องแม่นยำ ตั้งแต่เลือกสถาปัตยกรรมโมเดลไปจนถึงวิธี quantize น้ำหนักโมเดล เหตุผลที่แนวทางนี้โตเร็วในภาคอุตสาหกรรมชัดเจนมาก: การทำ inference บนตัวอุปกรณ์เองช่วยรักษาความเป็นส่วนตัวของข้อมูล (ไม่ต้องส่ง raw data ขึ้นคลาวด์), ยืดอายุแบตเตอรี่ และทำให้ระบบตรวจจับความผิดปกติทำงานต่อได้แม้เน็ตหลุด สำหรับโรงงานที่มีจุดวัดในพื้นที่ห่างไกลหรือสภาพแวดล้อมรุนแรง TinyML จึงเป็นเสมือน “ผู้เชี่ยวชาญที่ประจำอยู่ในเครื่องจักร” 24 ชั่วโมง แผนภาพ: TinyML pipeline — เซ็นเซอร์ส่งสัญญาณเข้า preprocessing (FFT/Filter) แล้วป้อนเข้าโครงข่ายประสาทเทียมขนาดเล็กบน MCU ที่ตัดสินใจส่ง alert เองโดยไม่ผ่านคลาวด์ (ที่มา: Honey Corporation) อาหารสมองของ TinyML: Quantization หัวใจที่ทำให้โมเดล AI ลงไปอยู่ใน MCU ได้คือเทคนิคบีบอัด โมเดล image classification สถาปัตยกรรมยอดนิยมขนาด 50 เลเยอร์ในความละเอียดเต็ม (FP32) มีขนาดราว 100 MB เมื่อแปลงเป็น INT8 ด้วย Post-Training Quantization (PTQ) จะเหลือประมาณ 5 MB และเมื่อปรับให้เหมาะกับงานเฉพาะแบบ TinyML แล้ว ขนาดที่ทำได้จริงคือระดับ 500 KB — เล็กลงราว 200 เท่าจากต้นฉบับ พอที่จะฝากลง flash…
Read More
Dark Factory ยุค 2026: เทคโนโลยี 5 ชั้นที่ทำให้โรงงานผลิตต่อเนื่อง 30 วันโดยไม่มีคนเฝ้า

Dark Factory ยุค 2026: เทคโนโลยี 5 ชั้นที่ทำให้โรงงานผลิตต่อเนื่อง 30 วันโดยไม่มีคนเฝ้า

Article
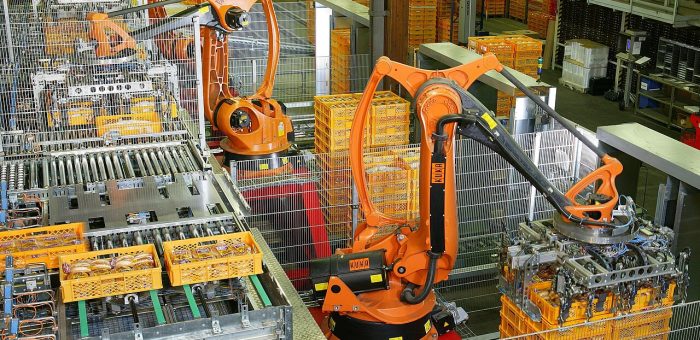
แนวคิดที่กลับมาเป็นข่าวอีกครั้งในปี 2026 คำว่า "Dark Factory" หรือ "Lights-Out Manufacturing" ไม่ใช่แนวคิดใหม่ แต่ในปี 2026 มันกลับมาเป็นหัวข้อสนทนาของวงการผลิตอีกครั้ง เพราะเทคโนโลยีที่จำเป็นต้นทุนต่ำลงและแข็งแรงขึ้นจนแนวคิดนี้เปลี่ยนจาก "การทดลอง" เป็น "กลยุทธ์การแข่งขัน" ของผู้ผลิตจริงหลายราย สิ่งที่เปลี่ยนไปคือชั้นของเทคโนโลยีที่ทำให้โรงงานรันได้โดยไม่ต้องมีคนเฝ้า ทั้งหุ่นยนต์ที่ปรับตัวได้ เซ็นเซอร์ IIoT ที่เข้าถึงง่ายขึ้น และซอฟต์แวร์ orchestration ที่เชื่อมทุกอย่างเข้าด้วยกัน นิยามสั้นๆ: Dark Factory คือโรงงานที่ทำงานโดยไม่ต้องมีคนอยู่หน้างาน เครื่องจักรและหุ่นยนต์จัดการกระบวนการทั้งหมดตั้งแต่ป้อนวัตถุดิบ ประกอบ ตรวจสอบ จนถึงบรรจุ มนุษย์เข้ามาเฉพาะเมื่อต้องดูแลระบบจากระยะไกล หรือทำ maintenance ตามแผน ส่วนชื่อ "มืด" มาจากการที่ไม่ต้องเปิดไฟ เปิดแอร์ หรือสร้างสวัสดิการให้คน จึงประหยัดพลังงานและพื้นที่ได้อีกส่วน หุ่นยนต์อุตสาหกรรมทำงานจัดเรียงสินค้าบนพาเลท — งานซ้ำซากปริมาณมากคือจุดเริ่มต้นที่พบมากที่สุดของ lights-out operation (ภาพ: Wikimedia Commons) โรงงานจริงที่ปิดไฟแล้ว ยังผลิตได้ 30 วัน กรณีศึกษาที่ถูกอ้างถึงมากที่สุดคือโรงงานผู้ผลิตหุ่นยนต์ในเมืองโอชิโนะ ประเทศญี่ปุ่น ซึ่งใช้หุ่นยนต์ประกอบหุ่นยนต์ตัวอื่นด้วยกันเอง โดยมีรายงานว่าสายการผลิตสามารถ รันแบบไม่มีคนเฝ้าต่อเนื่องได้นานถึง 30 วัน จุดยืนคือการออกแบบเครื่องจักรแบบ modular มาตรฐานเดียวกันทั้งไลน์ ควบคุมสภาพแวดล้อมการผลิตอย่างเข้มงวด และใช้ predictive maintenance คาดการณ์ปัญหาล่วงหน้า วิศวกรเข้ามาเฉพาะตามแผนบำรุงรักษาและตรวจสอบ อีกตัวอย่างที่มักถูกพูดถึงคือโรงงานเครื่องใช้ไฟฟ้าในเมืองดรัคเติน ประเทศเนเธอร์แลนด์ ที่ผลิตเครื่องโกนหนวดด้วย หุ่นยนต์ 128 ตัว กับคนเพียง 9 คน ที่ดูแลเรื่องคุณภาพ จุดเด่นคือระบบ modular cell + vision-guided ที่สลับผลิตรุ่นต่างๆ ได้เร็ว และ predictive maintenance ที่เห็นสัญญาณความเสียหายล่วงหน้าถึง 72 ชั่วโมง ขณะที่อุตสาหกรรมเซมิคอนดักเตอร์ 300 มิลลิเมตรคือ dark factory โดยความจำเป็น — คนคือแหล่งปนเปื้อน (contamination) ที่ใหญ่ที่สุดในห้องสะอาด จึงต้องใช้ AMHS (ระบบลำเลียงวัสดุอัตโนมัติ) และ FOUP เคลื่อนย้ายวาเฟอร์ผ่านขั้นตอนนับร้อยโดยไม่มีมือมนุษย์แตะ แขนกลอุตสาหกรรมยุคใหม่ออกแบบให้สอนงานได้ง่ายและปรับเปลี่ยนงานได้เร็ว — เงื่อนไขสำคัญของ hybrid lights-out (ภาพ: Wikimedia Commons) เทคโนโลยีเบื้องหลัง: ชั้นต่อชั้นที่ต้องครบ Lights-out ไม่ได้แปลว่าซื้อหุ่นยนต์มาวางแล้วจบ แต่คือการเรียงชั้นเทคโนโลยีให้ต่อกันครบ ดังนี้: ชั้นเทคโนโลยี หน้าที่ ตัวอย่างเทคโนโลยี 1. Executionทำงานแทนแรงงานคน ทั้งจับ…
Read More
บทวิเคราะห์: Prescriptive Maintenance (RxM) — เมื่อระบบบำรุงรักษาไม่ใช่แค่ทำนาย แต่บอกว่าควรทำอะไร

บทวิเคราะห์: Prescriptive Maintenance (RxM) — เมื่อระบบบำรุงรักษาไม่ใช่แค่ทำนาย แต่บอกว่าควรทำอะไร

Article
ทุกสายการผลิตเคยเจอคำถามนี้: ระบบแจ้งเตือนว่า "สัญญาณสั่นสะเทือนผิดปกติ" แล้วต่อไปล่ะ? ใครต้องไปดู ต้องซ่อมตอนไหน ถ้ารอก่อนจะเสียผลผลิตเท่าไร ถ้าหยุดเครื่องตอนนี้จะกระทบออร์เดอร์คือไหน — Prescriptive Maintenance (RxM) คือคำตอบที่อุตสาหกรรมกำลังเปลี่ยนไปหาในปี 2026 โดยมีรายงานจาก Hannover Messe ปีนี้ระบุว่า "Predictive Maintenance กำลังกลายเป็น Prescriptive" เป็นหนึ่งใน 12 เทรนด์หลักของปี ห้องควบคุมกลาง — จุดที่การแจ้งเตือนจาก predictive system ต้องถูกแปลงเป็นการตัดสินใจ ซึ่งยังเป็นงานของมนุษย์เต็มตัว (ภาพ: Z22 / Wikimedia Commons, CC BY-SA 4.0) ปัญหาของ Predictive: บอกว่า "จะเกิดอะไร" แต่ไม่บอกว่า "ควรทำอะไร" Predictive Maintenance ที่แข็งแรงแล้วหลายโรงงานยังคงเจอระยะสุดท้ายที่ติดอยู่ที่คน: โมเดลทำนายเก่ง แต่การแปลง prediction ให้เป็นการตัดสินใจยังต้องพึ่งประสบการณ์วิศวกร วิศวกรต้องชั่งน้ำหนักสภาพเครื่องจักรกับตารางผลิต อะไหล่พร้อมหรือไม่ และความสำคัญของสินทรัพย์แต่ละตัว ช่องว่างนี้คือสิ่งที่ RxM มาปิด — จากงานวิเคราะห์เชิงลึกของผู้ให้บริการ CMMS ระดับโลก: "ช่องว่างระหว่างสองกลยุทธ์นี้ไม่ใช่เซ็นเซอร์เพิ่มหรือ dashboard ที่สวยขึ้น แต่คือทีมของคุณได้รับข้อมูลที่ยังต้องตีความ หรือได้รับการตัดสินใจที่ปฏิบัติได้ทันที" RxM ทำงานอย่างไร: 3 ชั้นโครงสร้าง เพื่อให้คำแนะนำที่ "ตัดสินใจแทนได้" ระบบ RxM ต้องมี 3 ชั้นทำงานร่วมกัน ตามการวิเคราะห์ของผู้ให้บริการ CMMS ชั้นนำ: Condition Monitoring หลายโหมดต่อเนื่อง — เก็บสัญญาณ vibration, ultrasound, temperature และ magnetic field ด้วยความละเอียดพอจะเห็น failure signature ระยะต้นทั่วทั้ง fleet เครื่องจักร Automated Diagnostics — ระบุ failure mode เฉพาะเจาะจง ไม่ใช่แค่ "มีบางอย่างเปลี่ยน" การรู้ว่า vibration เพิ่มคือข้อมูล แต่การรู้ว่าแพทเทิร์นนั้นตรงกับ stage-two inner race bearing defect คือจุดเริ่มของการตัดสินใจ Prescription Layer — นำการวินิจฉัยไปชั่งน้ำหนักกับตัวแปรเชิงปฏิบัติการ (ตารางผลิต อะไหล่ในคลัง ความสำคัญของสินทรัพย์ แรงงาน ต้นทุนพลังงาน) แล้วส่งคืนเป็นคำแนะนำเฉพาะพร้อมผลลัพธ์ที่คาดหวัง หลายระบบใช้ digital…
Read More
12 เทรนด์เทคโนโลยีอุตสาหกรรมจาก Hannover Messe 2026: วิเคราะห์จาก 400 บูธ และ 300 สัมภาษณ์ — โรงงานไทยควรเริ่มจากตรงไหน

12 เทรนด์เทคโนโลยีอุตสาหกรรมจาก Hannover Messe 2026: วิเคราะห์จาก 400 บูธ และ 300 สัมภาษณ์ — โรงงานไทยควรเริ่มจากตรงไหน

Article
งาน Hannover Messe 2026 (20–24 เมษายน 2026 เมืองฮาโนเวอร์ ประเทศเยอรมนี) จบไปแล้วหลายเดือน แต่สัญญาณที่ได้จากงานกลับชัดเจนขึ้นเรื่อยๆ ว่าอุตสาหกรรมการผลิตกำลังเปลี่ยนผ่านไปตรงไหน — IoT Analytics ส่งทีมวิเคราะห์ 12 คนลงพื้นที่ เดินสำรวจกว่า 400 บูธ สัมภาษณ์เชิงลึกมากกว่า 300 ราย และสรุปออกมาเป็นรายงาน 197 หน้า ชี้ 12 เทรนด์เทคโนโลยีอุตสาหกรรมสำคัญประจำปี บทความนี้พาไล่ทีละเทรนด์ พร้อมมุมมองว่าโรงงานไทยควรเอาอะไรไปใช้จริง บรรยากาศงาน Hannover Messe — งานแสดงสินค้าอุตสาหกรรมที่ใหญ่ที่สุดในโลก (ภาพ: Olaf Kosinsky / Wikimedia Commons, CC BY-SA 3.0 DE) บริบทปี 2026: ความตึงเครียดระหว่าง AI กับข้อมูลที่เชื่อถือได้ ประเด็นกลางที่ IoT Analytics จับได้จากงานปีนี้คือ "ความตึงเครียด" ระหว่างสองฝั่ง — ผู้ขายเทคโนโลยีรีบผลักดันให้ AI ตัดสินใจอัตโนมัติบนสายการผลิตเพื่อสร้างรายได้ใหม่ ขณะที่คนส่วนใหญ่ในภาคการผลิตยังไม่ได้แก้ปัญหาพื้นฐาน คือ ข้อมูลที่เชื่อถือได้และมีบริบท (contextualized data) ที่จำเป็นต่อการให้ AI ตัดสินใจอย่างปลอดภัย ตัวเลขจากงานสะท้อนภาพนี้ชัด: ผู้เข้าชมราว 110,000 คน และผู้แสดงสินค้าราว 3,000 ราย ต่ำกว่าระดับก่อนโควิด — แต่คุณภาพผู้เข้าร่วมสูงมาก เต็มไปด้วยผู้บริหารระดับสูงด้านวิศวกรรมของกลุ่มอุตสาหกรรมใหญ่ๆ ทั่วโลก ไล่ทีละเทรนด์: 12 สัญญาณจากฮาโนเวอร์ ฮอลล์จัดแสดงสินค้าของงาน — ปีละ 3,000 ผู้แสดงสินค้าจากทั่วโลก (ภาพ: Ra Boe / Wikimedia Commons, CC BY-SA 3.0 DE) # เทรนด์ สิ่งที่เกิดขึ้นจริงบนพื้นงาน ผลกระทบต่อโรงงานไทย 1Agentic AIการคุยกันเลย Generative AI ไปสู่ AI Agent ที่ลงมือทำงานเองในกระบวนการผลิตเริ่มที่งานเอกสารและการจัดตารางผลิตก่อน ยังไม่ต้องรีบปล่อยให้คุมสายการผลิต 2Physical AIML ย้ายจากเซิร์ฟเวอร์ลงสู่เครื่องจักร ตัดสินใจเรียลไทม์ระดับเครื่องงานควบคุมคุณภาพและปรับสภาพเครื่องอัตโนมัติที่ต้องการ latency ต่ำ 3Humanoid Robotเข้าสู่ระยะ Early-stage Pilot ในโรงงานจริงติดตามผลนำร่องต่างประเทศได้ แต่ยังห่างการใช้งานกระจาย 4Industrial Foundation Modelผู้ให้บริการอุตสาหกรรมเริ่มสร้างโมเดล AI เฉพาะโดเมน…
Read More
Remaining Useful Life (RUL): คำถามสุดท้ายของ Predictive Maintenance ที่โมเดลใหญ่ตอบไม่ได้

Remaining Useful Life (RUL): คำถามสุดท้ายของ Predictive Maintenance ที่โมเดลใหญ่ตอบไม่ได้

Article
คำถามที่ยากที่สุดของ Predictive Maintenance ไม่ใช่ "เสียหรือยัง" แต่คือ "เหลือเวลาอีกนานเท่าไร" ตลอดหลายปีที่ผ่านมา Predictive Maintenance ในโรงงานส่วนใหญ่หยุดอยู่ที่คำถามแรก: เครื่องจักรตัวนี้ "ผิดปกติหรือไม่" — ซึ่ง Anomaly Detection ตอบได้ค่อนข้างดีแล้ว แต่คำถามที่มีผลต่อการวางแผนจริงๆ คือคำถามที่สอง: "ควรจัดซ่อมเมื่อไร" จัดเร็วเกินไปเสียโอกาสใช้งานชิ้นส่วนเต็มอายุ จัดช้าเกินไปก็กลายเป็น downtime ที่วางแผนไม่ได้ คำตอบของคำถามนี้มีชื่อเฉพาะในวงการวิศวกรรมความน่าเชื่อถือ: Remaining Useful Life (RUL) หรืออายุการใช้งานที่เหลืออยู่ RUL คือหัวใจของสาขา Prognostics and Health Management (PHM) ซึ่งเป็นขั้นสูงสุดของการบำรุงรักษาเชิงพยากรณ์ — ขณะที่ diagnostics บอกว่า "เกิดอะไรขึ้น" prognostics บอกว่า "จะไปต่ออีกนานแค่ไหน" ความต่างนี้คือความต่างระหว่างการรู้ว่าแบริ่งเริ่มมีรอย กับการรู้ว่าแบริ่งนั้นจะทนได้อีก 12 วันหรือ 12 ชั่วโมง ซึ่งนำไปสู่การตัดสินใจที่ต่างกันโดยสิ้นเชิง เครื่องยนต์เทอร์โบแฟน — กลุ่มเครื่องจักรที่งานวิจัย RUL ทำมากที่สุด เพราะความเสียหายระหว่างการใช้งานรุนแรงเกินจะรอให้เกิดขึ้น (ภาพ: Wikimedia Commons) จุดเปลี่ยน 2026: เมื่อ benchmark กลับหน้าไม่เป็นที่คาด เดือนเมษายน 2026 มีงานวิจัยเปรียบเทียบเทคนิค RUL ตีพิมพ์บน arXiv (Goel et al., 2026) ที่ให้ผลลัพธ์ "สะเทือนวงการ" ไม่ใช่เพราะตัวเลขสวย แต่เพราะมันตอกย้ำบทเรียนที่วิศวกรสาย reliability สงสัยกันมานาน งานวิจัยนี้ทดสอบบนชุดข้อมูลมาตรฐาน NASA C-MAPSS turbofan ซึ่งเป็น benchmark ที่ใช้กันทั่วโลกมาเกือบ 20 ปี โดยเปรียบเทียบ 3 ตระกูลวิธีบน subset FD001 และ FD003 ภายใต้ preprocessing เดียวกัน: โมเดล ตระกูล RMSE (FD001) RMSE (FD003) Ridge RegressionClassical (raw features)—— LSTM single-layer (Goel et al. 2026)Deep Learning14.9314.20 Deep LSTM (Zheng et al.)Deep Learning16.1416.18 1D CNNDeep Learning16.9715.68 XGBoostClassical…
Read More
Case Study: เมื่อ Work Order เกิดเอง — เชื่อม IIoT Sensor เข้า CMMS เปลี่ยนซ่อมบำรุงแบบไหน

Case Study: เมื่อ Work Order เกิดเอง — เชื่อม IIoT Sensor เข้า CMMS เปลี่ยนซ่อมบำรุงแบบไหน

Article
ปัญหา: เมื่อ Work Order เกิดช้ากว่าความเสียหาย ลองนึกภาพโรงงานผลิตชิ้นส่วนแห่งหนึ่งที่มีเครื่องจักรหลักกว่า 120 เครื่อง ทีมซ่อมบำรุง 12 คน และระบบบันทึกงานซ่อม ( CMMS ) ที่ใช้มานานกว่าสิบปี ทุกอย่างดูเรียบร้อยบนกระดาษ — แต่ในความจริง กระบวนการซ่อมบำรุงยังคง "รอ" สามสิ่ง: รอช่างเดินตรวจ, รอคนกรอกใบสั่งงาน และรอผู้จัดการอนุมัติ ผลคือเหตุการณ์เสียหายเล็กๆ กลายเป็น downtime ใหญ่เพราะมาถึงหูทีมซ่อมช้าเกินไป ช่างเทคนิคกับเอกสารงานซ่อมหน้าเครื่องจักร — ขั้นตอน "กรอกใบสั่งงาน" ที่ดูเล็กน้อยคือคอขวดที่แท้จริงของการซ่อมบำรุงสมัยใหม่ (ภาพ: Wikimedia Commons / U.S. Air Force, public domain) สิ่งที่เกิดขึ้นที่โรงงานแห่งนี้สะท้อนภาพอุตสาหกรรมกว้างๆ ตามข้อมูลจากการวิเคราะห์ของผู้ให้บริการแพลตฟอร์ม IIoT ปี 2025: การบริหารซ่อมบำรุงแบบดั้งเดิมที่พึ่งการตรวจด้วยตนเอง การซ่อมเมื่อเสีย และตารางซ่อมตามปฏิทิน นำไปสู่ downtime ที่หลีกเลี่ยงได้และต้นทุนสูงเกินจำเป็น ขณะที่การซ่อมบำรุงเชิงพยากรณ์ ( Predictive Maintenance ) ที่ขับเคลื่อนด้วย IoT ช่วยลดต้นทุนซ่อมบำรุงได้ถึง 30% และขจัดการเสียหายกระจาย ( breakdown ) ได้ 70-75% ทางออก: ต่อเซ็นเซอร์เข้ากับ CMMS ให้ Work Order "เกิดเอง" หัวใจของการแก้ปัญหาไม่ใช่การซื้อเซ็นเซอร์เพิ่ม แต่คือการ เชื่อมช่องว่างระหว่างโลกของข้อมูลกับโลกของการปฏิบัติงาน สถาปัตยกรรมที่ใช้แก้ปัญหามี 5 ขั้นตอน ซึ่งล้วนทำงานอัตโนมัติตั้งแต่ขั้นที่ 1 ถึง 4: เซ็นเซอร์เก็บข้อมูล — เซ็นเซอร์ไร้สาย ( vibration, temperature, pressure, humidity ) ตรวจวัดสภาพเครื่องจักรต่อเนื่อง ส่งข้อมูลขึ้นแพลตฟอร์ม — ค่าที่วัดได้ส่งตรงสู่ระบบ CMMS แบบ real-time ผ่านเกตเวย์ IIoT แจ้งเตือนและสร้าง Work Order อัตโนมัติ — เมื่อค่าใดๆ เกินเกณฑ์ที่กำหนด ระบบสร้างใบสั่งงานทันทีโดยไม่ต้องมีคนกรอก ทีมซ่อมรับมือ — ช่างได้รับแจ้งเตือนแบบ real-time ลดเวลาตอบสนองลงอย่างมีนัยสำคัญ ข้อมูลสะสมเป็นฐานของ AI — ข้อมูลย้อนหลังถูก Machine Learning วิเคราะห์หาแนวโน้ม กลายเป็น Predictive Maintenance ที่แท้จริง เซ็นเซอร์วัดการสั่นสะเทือนไร้สายที่ติดตั้งกับเครื่องจักร —…
Read More
Airborne Ultrasound Inspection: ตรวจจับรอยโรคเครื่องจักรด้วยคลื่นเสียงความถี่สูงก่อนใครจะรู้ตัว

Airborne Ultrasound Inspection: ตรวจจับรอยโรคเครื่องจักรด้วยคลื่นเสียงความถี่สูงก่อนใครจะรู้ตัว

Article
ทำไมคลื่นเสียงความถี่สูงถึงเป็น "สัญญาณเตือนภัยล่วงหน้า" ที่โรงงานมักมองข้าม ในโลกของ Predictive Maintenance หลายคนนึกถึง Vibration Analysis และ Infrared Thermography เป็นอันดับแรก แต่มีเทคโนโลยีหนึ่งที่ถูกใช้งานในโรงงานอุตสาหกรรมมานานกว่า 40 ปี กลับถูกใช้ต่ำกว่าศักยภาพจริงอย่างมาก นั่นคือ Airborne Ultrasound Inspection หรือการตรวจวัดคลื่นเสียงความถี่สูง หลักการทำงานเรียบง่ายแต่ทรงพลัง: ทุกปรากฏการณ์ที่เกิดขึ้นก่อนการเสียหายของเครื่องจักร — ไม่ว่าจะเป็น แรงเสียดทาน (friction), ความปั่นป่วนของก๊าซ (turbulence), การกระแทก (impact) หรือ ปรากฏการณ์ไฟฟ้าผิดปกติ — ล้วนปล่อยพลังงานคลื่นเสียงความถี่สูงออกมาในช่วง 20 kHz ขึ้นไป ซึ่งหูมนุษย์ได้ยินไม่ได้ แต่เซ็นเซอร์อัลตร้าโซนิกได้ยิน "ชัดเจน" ระบบแอร์คอมเพรสเซอร์แบบโรตารีสกรูในโรงงาน — จุดที่ระบบอัลตร้าโซนิกล็อกหาจุดรั่วได้เร็วที่สุด เพราะการรั่วของอากาศอัดเกิด "ความปั่นป่วน" ที่ปล่อยคลื่นเสียง 20-100 kHz ออกมา (ภาพ: Wikimedia Commons / public domain) จุดเด่นที่ทำให้อัลตร้าโซนิกแตกต่างจากเทคโนโลยี PdM อื่นคือ ความไวในระยะเริ่มต้นของความเสียหาย หลาย failure mode ปล่อยพลังงานอัลตร้าโซนิกออกมา ก่อนที่ระดับการสั่นสะเทือนจะเพิ่มขึ้น หรือก่อนที่อุณหภูมิพื้นผิวจะร้อนจนมองเห็นด้วยกล้อง Thermography ทำให้เป็นเทคโนโลยี early warning ที่แท้จริง เทคโนโลยี PdM หลักเปรียบเทียบกันแบบมืออาชีพ เทคโนโลยี สัญญาณที่ตรวจจับ จุดแข็ง ข้อจำกัด Ultrasoundคลื่นเสียง 20-100 kHzตรวจจับได้เร็วที่สุดในระยะเริ่มต้น, หาจุดรั่วแม่นยำ, ทำงานขณะเดินเครื่องบอกตำแหน่งเก่งกว่าบอกความรุนแรง Vibrationการสั่นสะเทือน 0-20 kHzวิเคราะห์ failure mode เชิงลึกได้ ( imbalance, misalignment, bearing defect )ต้องติดตั้งเซ็นเซอร์, ต้องมีข้อมูลเชิงลึก Thermographyอุณหภูมิผิว -20 ถึง 1,500°Cเห็นภาพรวมทั้งบริเวณ, non-contactพบปัญหาหลังความร้อนสะสมแล้ว ( ช้ากว่า ) Oil Analysisอนุภาคสึกหรอในน้ำมันยืนยันสาเหตุการสึกหรอได้ชัดเจนต้องเก็บตัวอย่างส่งแล็บ, ไม่ real-time จะเห็นได้ว่าไม่มีเทคโนโลยีใดชนะขาด แต่ Ultrasound โดดเด่นที่สุดในมิติของ ความเร็วในการตรวจจับ และ ความคุ้มค่า — การสำรวจอัลตร้าโซนิกไม่ต้องหยุดเครื่อง ไม่ต้องติดตั้งเซ็นเซอร์ถาวร และให้ผลตอบแทน (ROI) เร็วที่สุดในบรรดาเทคโนโลยี PdM ทั้งหมด จนหลายโรงงานใช้เป็น "จุดเริ่มต้น" ที่สร้างงบประมาณให้โปรแกรม PdM ทั้งหมด 5…
Read More
Hybrid Twin: เมื่อ Physics-based Model จับมือ Machine Learning เพื่อโมเดลที่แม่นและทนทานกว่า

Hybrid Twin: เมื่อ Physics-based Model จับมือ Machine Learning เพื่อโมเดลที่แม่นและทนทานกว่า

Article
ในโครงการทำ Predictive Twin หลายโครงการที่เราเห็นล้มเหลว มีจุดตายตรงกันคือเลือกใช้ Machine Learning เพียงอย่างเดียว โมเดลทำนายแม่นยำในช่วงทดสอบ แต่พอเครื่องจักรเปลี่ยนสภาวะทำงาน ความแม่นยำก็ไถลลงจนใช้งานจริงไม่ได้ ในทางกลับกัน โมเดลฟิสิกส์ที่แม่นยำสุดๆ ก็มีข้อจำกัดเรื่องเวลาคำนวณและต้นทุนการสร้าง คำตอบที่งานวิจัยอุตสาหกรรมหันไปใช้กันมากขึ้นคือ Hybrid Twin — การผสานจุดแข็งของสองโลกเข้าไว้ในโมเดลเดียว ปัญหา: ทำไมโมเดลชนิดเดียวไม่พอ ลองนึกภาพการทำนายอุณหภูมิแบริ่งของมอเตอร์ไฟฟ้าขนาดใหญ่ วิธีฟิสิกส์ (Physics-based) คือสร้างโมเดลความร้อนและการสั่นสะเทือนจากสมการถ่ายเทความร้อนและพลศาสตร์ วิธีนี้เชื่อถือได้สูงเมื่ออยู่ในเงื่อนไขที่โมเดลออกแบบมา วิศวกรอธิบายได้ว่าทำไมค่าทำนายเป็นเช่นนั้น แต่การสร้างโมเดล FEA หรือ CFD ที่ละเอียดขึ้น มัคช์กับเครื่องจักรจริง ต้องใช้เวลาคำนวณนานและทรัพยากรจำนวนมาก ที่สำคัญข้อผิดพลาดเล็กๆ ในค่าสัมประสิทธิ์ เช่น สัมประสิทธิ์การนำความร้อนของวัสดุ สะสมกันเป็นความคลาดเคลื่อนของผลลัพธ์ ส่วนวิธีข้อมูล (Data-driven) อย่าง Deep Learning เรียนรู้จากข้อมูลเซ็นเซอร์จริงหลายหมื่นจุด ทำนายได้เร็วและแม่นในสภาวะที่เคยเห็น แต่โมเดลไม่เข้าใจกลไกเบื้องหลัง เมื่อเจอสภาวะใหม่ที่ไม่เคยมีในชุดข้อมูลฝึก เช่น เปลี่ยนวัตถุดิบ เปลี่ยนอัตราการผลิต หรือแว่วเสียงแปลกประหลาด โมเดลก็เดาผิดได้อย่างมั่นใจ งานวิจัยที่ตีพิมพ์ในวารสาร Procedia CIRP ปี 2022 เรียกปัญหานี้ว่าช่องว่างระหว่างสองกระบวนทัศน์ และเสนอว่าการผสานกันคือทางออกที่ยั่งยืนกว่า การจำลองทางฟิสิกส์อย่าง crash-test simulation แม่นยำแต่ต้องแลกกับเวลาคำนวณ — ที่มา: Wikimedia Commons (CC BY-SA) แนวทางแก้: โครงสร้างของ Hybrid Twin หลักคิดของ Hybrid Twin มีสามชั้นต่อกัน ชั้นแรกคือโมเดลฟิสิกส์แบบลดทอน (Reduced-order Model) ที่ย่อส่วนจากโมเดล FEA/CFD เต็มรูปแบบให้คำนวณได้เร็วขึ้นหลายเท่าตัว โดยยอมรับความคลาดเคลื่อนเล็กน้อย ชั้นที่สองคือโมเดลแทรกแซง (Correction Model) ที่เป็น Machine Learning หน้าที่เดียวคือเรียนรู้ "ส่วนต่าง" ระหว่างค่าทำนายของโมเดลฟิสิกส์กับค่าจริงจากเซ็นเซอร์ และชั้นที่สามคือวงจรสอบเทียบอัตโนมัติที่อัปเดตโมเดลแทรกแซงอย่างต่อเนื่องเมื่อข้อมูลใหม่ไหลเข้ามา โครงสร้าง Hybrid Twin: โมเดลฟิสิกส์ให้ความเข้าใจกลไก ML ชดเชยส่วนต่างจากข้อมูลจริง — ภาพวาดโดยทีม Honey Corporation ผลลัพธ์ที่ได้คือระบบที่ทำนายเร็วเท่า Machine Learning แต่ยังคงความน่าเชื่อถือนอกเงื่อนไขที่เคยเห็น เพราะเมื่อสภาวะเปลี่ยน โมเดลฟิสิกส์ยังจับพฤติกรรมหลักได้ ส่วน ML แค่ปรับค่าชดเชย แนวทางนี้ถูกนำไปใช้จริงในงานวิจัยระดับสากล เช่น โครงการ Horizon Europe ที่ใช้แนวคิด hybrid modeling ผสาน Digital Twin กับการผลิตจริง และงานวิจัยในวารสาร Journal of Engineering…
Read More

Case Study: Autonomous Production System จาก Reactive Maintenance สู่ระบบผลิตอัตโนมัติ OEE 79% ใน 13 เดือน

Article
บทความนี้นำเสนอ Case Study การนำ Autonomous Production System ไปใช้ในโรงงานผลิตชิ้นส่วนอุตสาหกรรม โดยวิเคราะห์เส้นทางจากปัญหา การออกแบบระบบ ไปจนถึงผลลัพธ์ที่เกิดขึ้นจริง เป็นแนวทางสำหรับผู้บริหารโรงงานที่กำลังพิจารณาเปลี่ยนจาก Reactive Maintenance สู่ระบบที่เครื่องจักรสามารถปรับตัวเองได้ ปัญหา: เมื่อ "Unplanned Downtime" กลายเป็นความเจ็บปวดประจำวัน โรงงานผลิตชิ้นส่วนโลหะแม่พิมพ์ขนาดกลางแห่งหนึ่ง มีสายการผลิตหลัก 6 สาย ใช้เครื่องจักรกว่า 120 เครื่อง ปัญหาหลักคือ Unplanned Downtime เฉลี่ย 14 ชั่วโมง/สัปดาห์ ส่งผลให้ OEE (Overall Equipment Effectiveness) ต่ำเพียง 58% เทียบกับเป้าหมายอุตสาหกรรมที่ 85% สาเหตุหลักมาจาก: Reactive Maintenance: ซ่อมเฉพาะเมื่อเครื่องเสีย ไม่มีการพยากรณ์ล่วงหน้า Alarm Flood: ระบบ SCADA ส่งการแจ้งเตือนมากกว่า 800 ครั้ง/วัน ช่างไม่สามารถแยกแยะสัญญาณสำคัญได้ Manual Scheduling: เมื่อเครื่องเสีย นักวางแผนต้องใช้เวลา 2-3 ชั่วโมงในการจัดลำดับการผลิตใหม่ โครงสร้างพื้นฐาน Edge Computing และเซิร์ฟเวอร์สำหรับประมวลผลข้อมูลเซ็นเซอร์แบบเรียลไทม์ รากฐานสำคัญของ Autonomous Production System (ภาพ: Wikimedia Commons) การวินิจฉัยและออกแบบระบบ ทีมวิศวกรวิเคราะห์สถาปัตยกรรมที่มีอยู่และออกแบบ Autonomous Production System แบ่งเป็น 3 ระยะ: ระยะ งานหลัก ระยะเวลา ผลลัพธ์ที่คาดหวัง ระยะที่ 1 ติดตั้ง IIoT Sensors + เชื่อม PLC ผ่าน OPC UA + MQTT Broker 3 เดือน Data Visibility: เห็นข้อมูลเครื่องจักรทุกตัวแบบเรียลไทม์ ระยะที่ 2 Deploy Anomaly Detection + Vibration Analysis Model บน Edge Device 4 เดือน Predictive Alerts: เตือนล่วงหน้า 24-72 ชม. ก่อนเครื่องเสีย ระยะที่ 3 Multi-Agent System: Agent บำรุงรักษา +…
Read More