Agentic AI ใน Smart Manufacturing 2026: เมื่อโรงงานเริ่มตัดสินใจเองด้วย Autonomous AI Agent

Article
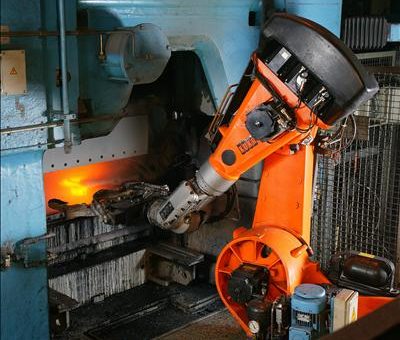
ปี 2026 ถือเป็นจุดเปลี่ยนสำคัญของอุตสาหกรรมการผลิต ข้อมูลจาก Deloitte ระบุว่าการนำ Agentic AI มาใช้ในการผลิตเพิ่มขึ้นถึง 4 เท่าตัวในเวลาเพียงหนึ่งปี จาก 6% สู่ 24% ของผู้ผลิตทั่วโลก ตัวเลขนี้สะท้อนการเปลี่ยนแปลงครั้งใหญ่: โรงงานไม่ได้ใช้ AI แค่วิเคราะห์ข้อมูลอีกต่อไป แต่เริ่มปล่อยให้ระบบ AI ตัดสินใจและดำเนินการเองในกระบวนการผลิตจริง บทความนี้เจาะลึก Agentic AI ในบริบท Smart Manufacturing ตั้งแต่แนวคิด สถาปัตยกรรม กรณีศึกษาผลลัพธ์จริง ไปจนถึงความท้าทายที่ผู้บริหารโรงงานต้องเตรียมรับมือ หุ่นยนต์อุตสาหกรรมในโรงหล่อ — เมื่อ AI Agent เข้ามาประสานงาน หุ่นยนต์เหล่านี้ไม่ได้ทำงานตามโปรแกรมตายตัว แต่ปรับตัวตามสภาพการผลิตแบบเรียลไทม์ (ภาพ: Wikimedia Commons) Agentic AI คืออะไร? แตกต่างจาก AI แบบเดิมอย่างไร? Agentic AI (AI เชิงตัวแทน) คือระบบ AI ที่สามารถ รับรู้ ให้เหตุผล ตัดสินใจ และลงมือทำ ได้อย่างอิสระตามเป้าหมายที่กำหนด โดยไม่ต้องมีมนุษย์สั่งการทีละขั้น แตกต่างจาก AI แบบดั้งเดิมที่ทำหน้าที่ "ตอบคำถาม" หรือ "วิเคราะห์ข้อมูล" เพียงอย่างเดียว คุณสมบัติ AI แบบดั้งเดิม (Reactive) Agentic AI (Autonomous) การตัดสินใจ แนะนำ/วิเคราะห์ แล้วมนุษย์ตัดสินใจ ตัดสินใจและดำเนินการเอง ขอบเขตการทำงาน งานเดี่ยว เช่น ตรวจจับ Defect ประสานหลายระบบ เช่น จัดตารางผลิตและสั่งวัตถุดิบ การเรียนรู้ ต้อง retrain เมื่อข้อมูลเปลี่ยน ปรับตัวต่อเนื่องจาก feedback loop การโต้ตอบ ทางเดียว (Output สู่ Human) สองทาง เรียก API สั่ง PLC แจ้งเตือน ตัวอย่างในโรงงาน Computer Vision ตรวจคุณภาพ Agent จัดการบำรุงรักษาทั้งระบบ 5 Use Case ที่ Agentic AI สร้างผลลัพธ์จริงในโรงงาน จากข้อมูล iFactory AI (กุมภาพันธ์ 2026) ผู้ผลิตชั้นนำเริ่มใช้ Multi-Agent Systems ในพื้นที่ปฏิบัติการหลัก 5…
Read More
Partial Discharge Monitoring: สัญญาณเตือนภัยล่วงหน้าจากฉนวนสินทรัพย์ไฟฟ้ากำลัง

Partial Discharge Monitoring: สัญญาณเตือนภัยล่วงหน้าจากฉนวนสินทรัพย์ไฟฟ้ากำลัง

Article
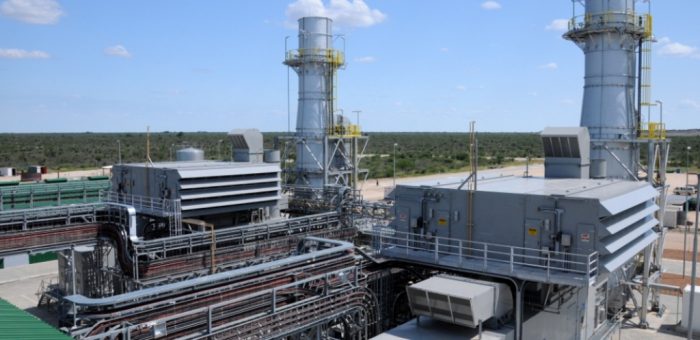
หม้อแปลงกำลัง หน้าสวิตช์เกียร์ หรือสายเคเบิลแรงสูง ไม่ได้ล้มเหลวกะทันหัน — มันเริ่มตายตั้งแต่วันที่ฉนวนเริ่มมี Partial Discharge (PD) คืนแรก เทคโนโลยี PD Monitoring คือประกาศณีย์แห่งการ "ได้ยินเสียงฟ้าผ่าเล็กๆ" ก่อนที่มันจะกลายเป็นไฟไหม้เครื่องหม้อแปลง — บทความนี้วิเคราะห์ว่าทำไมการเฝ้าระวัง PD แบบต่อเนื่องจึงกลายเป็นมาตรฐานใหม่ของสินทรัพย์ไฟฟ้ากำลังในยุค IIoT หม้อแปลงไฟฟ้ากำลังในสถานีไฟฟ้าย่อย — สินทรัพย์ที่ Partial Discharge เป็นสาเหตุหลักของการเสื่อมสภาพฉนวนและไฟไหม้ (ภาพ: Flickr, CC BY 2.0) Partial Discharge คืออะไร? Partial Discharge (PD) คือการคายประจุไฟฟ้าเฉพาะส่วนที่เกิดขึ้นในหรือบนผิวของระบบฉนวนแรงดันสูง โดยที่การคายประจุนั้น ไม่ได้เชื่อมต่อ (bridge) ระหว่างตัวนำทั้งสองขั้วอย่างสมบูรณ์ แม้จะเป็น "บางส่วน" แต่พลังงานของมันสร้างความเสียหายสะสม — กัดกร่อนฉนวนจากภายใน จนวันหนึ่งฉนวนทะลุทะลวง (breakdown) กลายเป็นไฟอาร์คเต็มตัว PD แบ่งเป็นสามประเภทตามตำแหน่งที่เกิด: Internal/Void Discharge: เกิดในโพรงอากาศ (void) ภายในฉนวนของแข็ง — อันตรายที่สุดเพราะมองไม่เห็นและกัดกร่อนจากข้างใน Surface Discharge: เกิดบนผิวฉนวน มักตามมลพิษ/ความชื้น — พบบนปลายสายเคเบิลและบุชชิง Corona Discharge: เกิดในอากาศรอบตัวนำที่มีสนามไฟฟ้าสูง (รอยบนผิว ปลายแหลม) สัญญาณทิ้งร่องรอย: PD "เผยตัว" ผ่าน 4 รูปแบบพลังงาน ทุกครั้งที่ PD เกิด มันปล่อยพลังงานออกมาพร้อมกัน 4 รูปแบบ — และนี่คือเหตุผลที่เรามี 4 เทคนิคการตรวจจับ ที่แต่ละแบบ "ฟัง" พลังงานคนละชนิดกัน: เทคนิคตรวจจับ สิ่งที่วัด ช่วงความถี่ จุดเด่น Electrical (IEC 60270) ประจุ apparent (pC) ผ่าน coupling capacitor / HFCT ต่ำ-กลาง (เคฮertz) วัดปริมาณได้ตรง ใช้เป็นอ้างอิง calibrate UHF คลื่นแม่เหล็กไฟฟ้าที่ PD แผ่ออก 300 MHz – 3 GHz ความไวสูง ทนต่อสัญญาณรบกวน ดีใน GIS Acoustic Emission คลื่นเสียงเหนือความถี่ยินจาก PD 40 – 300…
Read More
FMEA/FMECA แบบ Step-by-Step: วิธีวิเคราะห์ Failure Mode ตามมาตรฐาน AIAG-VDA เพื่อ Predictive Maintenance

FMEA/FMECA แบบ Step-by-Step: วิธีวิเคราะห์ Failure Mode ตามมาตรฐาน AIAG-VDA เพื่อ Predictive Maintenance

Article
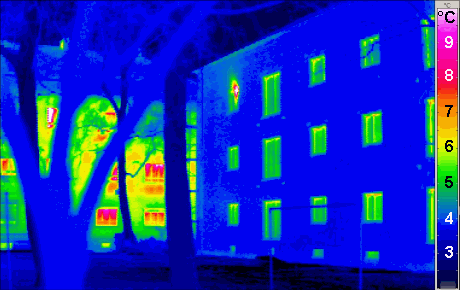
"ทำไมเครื่องจักรถึงเสีย? จะเสียแบบไหน? และผลกระทบรุนแรงแค่ไหน?" — คำถามสามข้อนี้คือหัวใจของ FMEA (Failure Mode and Effects Analysis) ซึ่งเป็นระเบียบวิธีวิเคราะห์ความเสี่ยงเชิงระบบที่หล่อเลี้ยงโปรแกรม Predictive Maintenance ทุกระดับ บทความนี้จะพาทำ FMEA ทีละขั้น แบบที่ทีมวิศวกรใช้กันจริง แผนที่ความร้อน (Risk Heat Map) แสดงการจัดลำดับความเสี่ยงตามผลกระทบและโอกาสเกิด — เป็นผลลัพธ์ที่มองเห็นได้ของการวิเคราะห์ FMEA (ภาพ: Wikimedia Commons, CC BY-SA 4.0) FMEA คืออะไร และทำไมมันเป็น "Core Tool" FMEA เป็นเทคนิควิเคราะห์เชิงรุก (proactive) ที่ตรวจหา รูปแบบการเสียหายที่เป็นไปได้ ของระบบ กระบวนการ หรือชิ้นส่วน พร้อมประเมินผลกระทบและโอกาสเกิด เพื่อจัดลำดับการลงมือป้องกันก่อนที่ปัญหาจะเกิดจริง เมื่อเพิ่มมิติ Criticality (ความวิกฤต) เข้าไปก็กลายเป็น FMECA ที่ให้คะแนนจัดอันดับความเสี่ยงแบบชัดเจน FMEA เป็นหนึ่งใน Core Tools ของระบบบริหารคุณภาพ โดยกำหนดไว้ในมาตรฐานสำคัญสามฉบับ: AIAG-VDA FMEA Handbook (2019) — คู่มือที่ผสานมาตรฐานอเมริกัน (AIAG) และเยอรมัน (VDA) เข้าด้วยกัน ใช้กันแพร่หลายในอุตสาหกรรมยานยนต์และอุปกรณ์อิเล็กทรอนิกส์ IEC 60812 — มาตรฐานสากลว่าด้วยเทคนิคการวิเคราะห์รูปแบบความล้มเหลว IATF 16949 — ข้อกำหนดระบบคุณภาพอุตสาหกรรมยานยนต์ที่บังคับให้ใช้ FMEA เป็นเครื่องมือบังคับ นอกจากนี้ FMEA ยังเป็นรากฐานของ RCM (Reliability-Centered Maintenance) — เพราะก่อนจะเลือกกลยุทธ์บำรุงรักษา คุณต้องรู้ก่อนว่าเครื่องจักรเสียได้แบบไหน DFMEA vs PFMEA — เลือกประเภทให้ถูก ก่อนเริ่ม ให้ชี้ชัดว่าคุณทำ FMEA ประเภทใด: Design FMEA (DFMEA): วิเคราะห์การเสียหายที่มาจาก การออกแบบ ผลิตภัณฑ์/เครื่องจักร — ทำตั้งแต่ขั้นพัฒนา ก่อนส่งมอบแบบ Process FMEA (PFMEA): วิเคราะห์การเสียหายจาก กระบวนการผลิต/ประกอบ — เน้นขั้นตอนการทำงานและความผิดพลาดของคน/เครื่องจักร System/Functional FMEA: มองในระดับระบบใหญ่ — เหมาะกับสถาปัตยกรรม Smart Factory และแผนบำรุงรักษา วิธีทำ FMEA ตาม AIAG-VDA แบบ Step-by-Step ขั้นที่…
Read More
Acoustic Emission Monitoring: ดักฟังคลื่นเงียบจากวัสดุเพื่อพยากรณ์ความเสียหายก่อนเกิด

Acoustic Emission Monitoring: ดักฟังคลื่นเงียบจากวัสดุเพื่อพยากรณ์ความเสียหายก่อนเกิด

Article
เมื่อวัสดุเครื่องจักรเริ่มแตกร้าว ก่อนที่ตาเราจะเห็น หรือก่อนที่เซ็นเซอร์สั่นสะเทือนจะตรวจจับได้ วัสดุนั้นกำลัง "เคยชิน" คลื่นความเค้น (stress wave) ความถี่สูงออกมาเบาๆ เทคนิคที่ดักฟังคลื่นเงียบนี้คือ Acoustic Emission (AE) Monitoring — หนึ่งในเทคโนโลยี Non-Destructive Testing (NDT) ที่ทรงพลังที่สุดของวงการ Predictive Maintenance Acoustic Emission คืออะไร? Acoustic Emission (AE) คือปรากฏการณ์ที่วัสดุปล่อยคลื่นยืดหยุ่นชั่วขณะ (transient elastic wave) ออกมาเมื่อเกิดการเปลี่ยนแปลงโครงสร้างภายใน เช่น การเกิดรอยร้าว (crack initiation/propagation) การหลุดร่อง (delamination) การเสียรูปแบบพลาสติก (plastic deformation) หรือการรั่วของก๊าซ/ของเหลว คลื่นเหล่านี้มีความถี่อยู่ในย่าน 100 kHz ถึง 1 MHz (สูงกว่าเสียงที่หูมนุษย์ได้ยิน) และถูกตรวจจับด้วย เซ็นเซอร์เพียโซอิเล็กทริก (piezoelectric sensor) ที่แปลงคลื่นแรงดันเป็นสัญญาณไฟฟ้า เซ็นเซอร์เพียโซอิเล็กทริกแบบที่ใช้ในงาน Acoustic Emission Monitoring — แกนกลางคือวัสดุเซรามิกที่แปลงคลื่นความเค้นเป็นสัญญาณไฟฟ้า (ภาพ: Wikimedia Commons, CC BY-SA 4.0) สิ่งที่ทำให้ AE แตกต่างจากเทคนิค NDT อื่นอย่าง Ultrasonic Testing คือการที่ AE เป็นระบบ "Passive" — ไม่ปล่อยพลังงานเข้าไปกระตุ้น แต่ ดักฟัง สิ่งที่วัสดุปล่อยออกมาเอง นั่นหมายความว่า AE บอกได้ว่ารอยร้าวนั้น "กำลังเติบโตอยู่จริง" หรือไม่ ซึ่งเป็นข้อมูลสำคัญที่ตรวจการณ์แบบ snapshot มอบไม่ได้ พารามิเตอร์สำคัญที่วิศวกรต้องอ่านออก สัญญาณ AE แต่ละ "Hit" จะถูกสกัดเป็นพารามิเตอร์หลายตัวที่สะท้อนลักษณะของแหล่งกำเนิด: พารามิเตอร์ ความหมาย สื่อถึงอะไร Amplitude (dB) ค่าสูงสุดของสัญญาณ (มักวัด 40–100 dB) ความรุนแรงของเหตุการณ์ — ค่าสูงมักชี้การแตกร้าวรุนแรง Energy พื้นที่ใต้รูปคลื่น (μV²·s) พลังงานรวม — เกี่ยวข้องกับขนาดความเสียหาย Counts จำนวนครั้งที่สัญญาณข้าม threshold ความซับซ้อนของคลื่น — รอยร้าวมักให้ counts สูง Duration / Rise Time ระยะเวลาของสัญญาณ / เวลาขึ้นสู่…
Read More
Reliability-Centered Maintenance (RCM): กลยุทธ์บำรุงรักษาที่เกิดจากสายการบิน SAE JA1011

Reliability-Centered Maintenance (RCM): กลยุทธ์บำรุงรักษาที่เกิดจากสายการบิน SAE JA1011

Article
Reliability-Centered Maintenance (RCM) เป็นวิธีการวางแผนการบำรุงรักษาที่มุ่งเน้นการ รักษาฟังก์ชันการทำงานของระบบ ให้คงอยู่ต่อไป โดยไม่ใช่การรักษาเครื่องจักรเองไว้ในสภาพเดิม แนวคิดนี้กำเนิดขึ้นในปี 1978 จากงานวิจัยของ Nowlan and Heap ให้กับสายการบินพลเรือนของสหรัฐอเมริกา ซึ่งพบว่าการบำรุงรักษาแบบเดิม (Overhaul ตามกำหนดเวลา) ไม่สามารถป้องกันความเสียหายได้ทั้งหมด เพราะความเสียหายจริงมีรูปแบบที่ซับซ้อนกว่าที่คิด กำเนิด RCM: การค้นพบที่สั่นคลอนวงการบำรุงรักษาเส้นทางการบำรุงรักษาสมัยใหม่ — จากการซ่อมเมื่อพัง สู่การทำนายล่วงหน้าด้วยข้อมูลสภาพเครื่องจักร (ภาพประกอบ: Honey Corporation)เส้นทางการบำรุงรักษาสมัยใหม่ — จากการซ่อมเมื่อพัง สู่การทำนายล่วงหน้าด้วยข้อมูลสภาพเครื่องจักร (ภาพประกอบ: Honey Corporation) การศึกษาของ Nowlan และ Heap วิเคราะห์ข้อมูลความเสียหายของอะไหล่อากาศยานนับแสนชิ้น และค้นพบว่ารูปแบบความเสียหาย (Failure Pattern) แบ่งได้เป็น 6 รูปแบบ ที่ไม่เหมือนกัน ซึ่งท้าทายสมมติฐานเดิมที่ว่า “อะไรก็ตามที่ใช้งานไปนานพอจะเสีย” Pattern รูปแบบ (Bathtub Curve) พบในอะไหล่ (%) A High Infant Mortality + Wear-out Zone 4% B Constant หรือ Wear-out เพิ่มขึ้นเรื่อยๆ 2% C Failure Rate คงที่ตลอดอายุการใช้งาน 5% D Low Initial แล้วเพิ่มขึ้นทีละน้อย 7% E Constant Rate (Random Failure) 14% F High Infant Mortality แล้วลดลงคงที่ 68% ข้อค้นพบที่น่าตกใจคือ เพียง 11% (Pattern A + B) ของอะไหล่มีจุด Wear-out ที่ชัดเจนซึ่ง Time-Based Maintenance สามารถช่วยได้ ส่วน 89% ที่เหลือมีความเสียหายแบบสุ่ม (Random Failure) ที่การ Overhaul ตามกำหนดเวลาไม่สามารถป้องกันได้ และอาจทำให้แย่ลงเสียด้วยซ้ำ เพราะ Pattern F แสดงว่าอะไหล่ใหม่มีโอกาสเสียสูงในช่วงแรก (Infant Mortality) มาตรฐาน SAE JA1011: 7 คำถามของ RCM หลังจากแนวคิด RCM แพร่หลาย สถาบัน SAE International…
Read More
Condition-Based Monitoring (CBM): บำรุงรักษาตามสภาพจริงด้วย IIoT Sensor

Condition-Based Monitoring (CBM): บำรุงรักษาตามสภาพจริงด้วย IIoT Sensor

Article
Condition-Based Monitoring (CBM) หรือการตรวจสอบตามสภาพ เป็นกลยุทธ์การบำรุงรักษาที่เปลี่ยนจากการซ่อมตามกำหนดเวลา (Time-Based/Preventive) มาเป็นการตัดสินใจซ่อมบำรุง ตามสภาพจริงของเครื่องจักร โดยใช้ข้อมูลจาก Sensor ที่ติดตั้งอยู่กับ Asset อย่างต่อเนื่อง ตามนิยามจากมาตรฐาน ISO 17359 (Condition Monitoring and Diagnostics of Machines) ซึ่งเป็นกรอบมาตรฐานสากลสำหรับการวางระบบ Condition Monitoring ในอุตสาหกรรม CBM คืออะไร? แตกต่างจาก Preventive Maintenance อย่างไร?เส้นทางการบำรุงรักษาสมัยใหม่ — จากการซ่อมเมื่อพัง สู่การทำนายล่วงหน้าด้วยข้อมูลสภาพเครื่องจักร (ภาพประกอบ: Honey Corporation)เส้นทางการบำรุงรักษาสมัยใหม่ — จากการซ่อมเมื่อพัง สู่การทำนายล่วงหน้าด้วยข้อมูลสภาพเครื่องจักร (ภาพประกอบ: Honey Corporation) สมมติว่าเรามีปั๊มน้ำ 1 เครื่อง แนวทาง Preventive Maintenance (PM) จะกำหนดให้เปลี่ยน Bearing ทุก 10,000 ชั่วโมงการทำงาน ไม่ว่า Bearing จะยังอยู่ในสภาพดีหรือไม่ แต่ CBM จะติด Vibration Sensor ที่ปั๊ม และตัดสินใจเปลี่ยนเฉพาะเมื่อสัญญาณสั่นสะเทือนเข้าสู่ Warning Zone หรือ Alert Threshold เท่านั้น ผลที่ได้คือลดการเปลี่ยนอะไหล่ก่อนกำหนด (Premature Replacement) และหลีกเลี่ยงการทำงานจนเสียกะทันหัน (Run-to-Failure) เปรียบเทียบกลยุทธ์การบำรุงรักษา กลยุทธ์ พื้นฐานการตัดสินใจ จุดแข็ง จุดอ่อน Reactive (Run-to-Failure) ซ่อมเมื่อเสีย ไม่ต้องลงทุนตั้งต้น Downtime สูง ค่าเสียหายมหาศาล Preventive (Time-Based) ตามปฏิทิน/ชั่วโมงทำงาน วางแผนง่าย คาดเดาได้ Over-Maintenance เปลี่ยนของที่ยังดีอยู่ Condition-Based (CBM) ตามสภาพจริงจาก Sensor ลด Downtime และต้นทุนอะไหล่ ต้องลงทุน Sensor และ Analytics Predictive (AI-driven) พยากรณ์ล่วงหน้าด้วย ML เตือนล่วงหน้านานที่สุด ต้องการ Data Science และข้อมูลประวัติ ประเภทของ Sensor ที่ใช้ใน CBM CBM อาศัยข้อมูลจาก Sensor หลายประเภท ขึ้นอยู่กับชนิดของเครื่องจักรและ Failure Mode ที่ต้องการตรวจจับ Accelerometer (Vibration…
Read More
Infrared Thermography สำหรับ Predictive Maintenance: อ่านความร้อนเครื่องจักรเพื่อพยากรณ์ความเสือภัยก่อนเกิด

Infrared Thermography สำหรับ Predictive Maintenance: อ่านความร้อนเครื่องจักรเพื่อพยากรณ์ความเสือภัยก่อนเกิด

Article
Infrared Thermography (IRT) หรือการถ่ายภาพความร้อนด้วยกล้องอินฟราเรด เป็นหนึ่งในเทคนิค Non-Destructive Testing (NDT) ที่ทรงประสิทธิภาพที่สุดสำหรับ Predictive Maintenance ในโรงงานอุตสาหกรรมยุคใหม่ ด้วยการตรวจจับรังสีอินฟราเรด (Infrared Radiation) ที่วัตถุทุกชนิดแผ่ออกมา ซึ่งอยู่ในช่วงความยาวคลื่นประมาณ 7.5-14 ไมโครเมตร (Long-Wave IR) กล้อง Thermal Imaging สามารถแปลงความแตกต่างของอุณหภูมิบนพื้นผิวให้กลายเป็นภาพสีที่มองเห็นได้ด้วยตาเปล่า โดยไม่ต้องสัมผัสหรือหยุดการทำงานของเครื่องจักร หลักการทำงานของ Infrared Thermographyเส้นทางการบำรุงรักษาสมัยใหม่ — จากการซ่อมเมื่อพัง สู่การทำนายล่วงหน้าด้วยข้อมูลสภาพเครื่องจักร (ภาพประกอบ: Honey Corporation)เส้นทางการบำรุงรักษาสมัยใหม่ — จากการซ่อมเมื่อพัง สู่การทำนายล่วงหน้าด้วยข้อมูลสภาพเครื่องจักร (ภาพประกอบ: Honey Corporation) ทุกวัตถุที่มีอุณหภูมิสูงกว่าศูนย์สัมบูรณ์ (Absolute Zero หรือ -273.15 C) จะแผ่รังสีความร้อนออกมา กล้อง Thermography ใช้ Focal Plane Array (FPA) detector ที่ทำจาก Microbolometer หรือ InSb (Indium Antimonide) ในการรับรังสีและแปลงเป็นสัญญาณไฟฟ้า จากนั้นประมวลผลเป็นภาพ Thermogram ที่แต่ละ Pixel แสดงค่าอุณหภูมิแบบ Quantitative ความละเอียดของกล้องระดับ Industrial-grade มักอยู่ที่ 320×240 ถึง 640×480 pixels ด้วยความไวทางความร้อน (Thermal Sensitivity / NETD) ประมาณ 0.03-0.05 C Emissivity – ปัจจัยสำคัญที่กำหนดความแม่นยำ Emissivity คือค่าที่บ่งบอกความสามารถของพื้นผิวในการแผ่รังสีความร้อนเทียบกับ Blackbody ที่สมบูรณ์แบบ (e = 1.0) ค่านี้ส่งผลโดยตรงต่อความแม่นยำในการอ่านอุณหภูมิ การตั้งค่า Emissivity ผิดพลาดเพียงเล็กน้อยอาจทำให้ค่าอุณหภูมิคลาดเคลื่อนได้หลายสิบองศา ประเภทพื้นผิว ค่า Emissivity (e) ความเหมาะสมต่อ Thermography Black Electrical Tape 0.95-0.97 ดีมาก (ใช้เป็นมาตรฐานอ้างอิง) Oxidized Steel 0.80-0.90 ดี Polished Copper 0.03-0.05 แย่ (สะท้อนแสง ต้องปรับค่า) Painted Surface (Matte) 0.92-0.98 ดีมาก การประยุกต์ใช้ Thermography ในโรงงานอุตสาหกรรม 1. ตรวจสอบระบบไฟฟ้า…
Read More
Anomaly Detection สำหรับ Industrial AI: เทคโนโลยีตรวจจับความผิดปกติที่ทำงานได้ก่อนเกิดความเสียหาย

Anomaly Detection สำหรับ Industrial AI: เทคโนโลยีตรวจจับความผิดปกติที่ทำงานได้ก่อนเกิดความเสียหาย

Article
Anomaly Detection คืออะไร? และทำไมโรงงานอัจฉริยะถึงจำเป็นต้องมีวงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation)วงจรงาน Machine Learning ในโรงงาน — ตั้งแต่เก็บข้อมูลเซ็นเซอร์จนถึงการใช้โมเดลตัดสินใจบนหน้างาน (ภาพประกอบ: Honey Corporation) Anomaly Detection หรือการตรวจจับความผิดปกติ คือเทคโนโลยี AI ที่เรียนรู้รูปแบบการทำงานปกติของเครื่องจักรและกระบวนการผลิตจากข้อมูลเชิงเวลา (Time-Series Data) แล้วแจ้งเตือนเมื่อพบพฤติกรรมที่แตกต่างจากเบสไลน์ โดยไม่ต้องรอให้เกิดความเสียหายก่อน ในโลกของ IIoT ที่เซ็นเซอร์หลายพันตัวส่งข้อมูลทุกวินาที Anomaly Detection คือ “ระบบภูมิคุ้มกัน” ที่ทำงานอัตโนมัติตลอด 24 ชั่วโมง ต่างจากระบบแจ้งเตือนแบบดั้งเดิมที่ตั้ง Threshold ตายตัว (เช่น “อุณหภูมิเกิน 80°C ให้แจ้งเตือน”) ระบบ Anomaly Detection ด้วย AI สามารถเข้าใจบริบทได้ เช่น อุณหภูมิ 75°C อาจปกติในช่วง Startup แต่ผิดปกติในช่วง Steady State ทำให้ลด False Alarm ได้อย่างมีนัยสำคัญ ประเภทของ Anomaly ในโรงงานอุตสาหกรรม ในแวดวง Industrial AI เราแบ่งความผิดปกติออกเป็น 3 ประเภทหลัก: Point Anomaly — จุดข้อมูลเดี่ยวที่แตกต่างจากค่าปกติอย่างชัดเจน เช่น ความสั่นสะเทือนกระโดดจาก 2 mm/s เป็น 15 mm/s ทันที มักบ่งชี้การชน หรือของแปลกปลอมเข้าระบบ Contextual Anomaly — ค่าที่ผิดปกติเฉพาะในบริบทหนึ่ง เช่น อุณหภูมิมอเตอร์ 70°C เป็นเรื่องปกติในช่วงโหลดสูง แต่ผิดปกติเมื่อมอเตอร์ Idle ระบบ AI ต้องเข้าใจบริบทการทำงาน Collective Anomaly — ลำดับข้อมูลที่ร่วมกันบ่งชี้ความผิดปกติ แม้ค่าแต่ละตัวยังอยู่ในช่วงปกติ เช่น อุณหภูมิค่อย ๆ สูงขึ้น 0.5°C ต่อวันนาน 2 สัปดาห์ — อาการคลาสสิกของ Bearing Deterioration 💡 Key Insight: Collective Anomaly เป็นประเภทที่อันตรายที่สุด เพราะระบบแบบดั้งเดิมมักตรวจไม่พบ การเสื่อมสภาพช้า ๆ ของเครื่องจักรสร้างความเสียหายสะสมนับล้านบาทก่อนที่ Threshold Alarm…
Read More
Complex Event Processing (CEP): เครื่องมือวิเคราะห์เหตุการณ์เรียลไทม์ที่ตรวจจับรูปแบบความผิดปกติก่อนเกิดความเสียหายในโรงงาน

Complex Event Processing (CEP): เครื่องมือวิเคราะห์เหตุการณ์เรียลไทม์ที่ตรวจจับรูปแบบความผิดปกติก่อนเกิดความเสียหายในโรงงาน

Article
Complex Event Processing (CEP) คือเทคโนโลยีที่วิเคราะห์กระแสเหตุการณ์ (Event Stream) ที่ไหลเข้ามาอย่างต่อเนื่อง แล้วตรวจจับ “รูปแบบ” (Pattern) ที่บ่งชี้ถึงสถานการณ์สำคัญ เช่น ความผิดปกติ ภัยคุกคาม หรือโอกาสทางธุรกิจ ภายในเวลาไม่กี่มิลลิวินาที — เร็วกว่าการวิเคราะห์แบบ Batch แบบดั้งเดิมนับพันเท่า ในโรงงานอัจฉริยะ เซ็นเซอร์หลายพันตัวส่งข้อมูลเข้ามาทุกวินาที ไม่ว่าจะเป็นอุณหภูมิ ความดัน ความสั่นสะเทือน หรืออัตราการไหล เหตุการณ์ (Event) เดี่ยวๆ แต่ละตัวอาจดูปกติ แต่เมื่อนำมาประกอบกันในช่วงเวลาใกล้เคียง อาจเปิดเผยภาพที่บ่งชี้ความเสียหายที่กำลังจะเกิดขึ้น Complex Event Processing คือเครื่องมือที่ทำหน้าที่ “เชื่อมจุด” เหล่านี้เข้าด้วยกันแบบเรียลไทม์ CEP ทำงานอย่างไร?โปรโตคอลสื่อสารในระบบ IIoT — แต่ละชั้นของระบบสื่อสารในโรงงานใช้มาตรฐานต่างกันตามหน้าที่ (ภาพประกอบ: Honey Corporation)โปรโตคอลสื่อสารในระบบ IIoT — แต่ละชั้นของระบบสื่อสารในโรงงานใช้มาตรฐานต่างกันตามหน้าที่ (ภาพประกอบ: Honey Corporation) CEP Engine ทำงานด้วยแนวคิด Event-Driven Architecture แทนที่จะรอข้อมูลสะสมแล้วค่อยประมวลผล (Batch Processing) ระบบจะประมวลผลทุกเหตุการณ์ทันทีที่เข้ามา โดยรักษาเหตุการณ์ไว้ใน Sliding Window ซึ่งคือช่วงเวลาเลื่อนไปเรื่อยๆ เช่น “30 วินาทีล่าสุด” หรือ “100 เหตุการณ์ล่าสุด” แล้วตรวจสอบว่ามีรูปแบบที่ตรงเงื่อนไขหรือไม่ ขั้นตอนหลักมี 4 ข้อ: Ingestion — รับเหตุการณ์จากเซ็นเซอร์ผ่าน Message Broker (เช่น MQTT, AMQP) ด้วยอัตราหลายหมื่นถึงหลายแสนเหตุการณ์ต่อวินาที Pattern Matching — เปรียบเทียบเหตุการณ์ใน Window กับกฎ (Rule) ที่กำหนดไว้ เช่น “อุณหภูมิเกิน 90°C ติดต่อกันเกิน 5 ครั้ง ภายใน 10 วินาที” Complex Event Generation — เมื่อพบรูปแบบ สร้าง “Complex Event” ใหม่ที่สรุปสถานการณ์ เช่น “Overheating Alert ที่เตาอบเบอร์ 3” Action — ส่งสัญญาณเตือน, สั่งงดการผลิต, หรือ trigger ระบบควบคุมอัตโนมัติ ประเภทของ Pattern ที่ CEP ตรวจจับได้ Temporal Pattern…
Read More
Spare Parts On-Demand: การพิมพ์อะไหล่ตามสั่งที่แก้ปัญหา Supply Chain และ Obsolescence ของโรงงานอุตสาหกรรม

Spare Parts On-Demand: การพิมพ์อะไหล่ตามสั่งที่แก้ปัญหา Supply Chain และ Obsolescence ของโรงงานอุตสาหกรรม

Article
เมื่อเครื่องจักรหยุดทำงานเพราะอะไหล่ชิ้นเดียวที่สั่งต้องรอ 4–6 สัปดาห์ — นี่คือฝันร้ายของทุกโรงงาน แต่ Additive Manufacturing กำลังเปลี่ยนเรื่องนี้ด้วยแนวคิด Spare Parts On-Demand คือพิมพ์อะไหล่ออกมาเมื่อต้องการ ณ จุดที่ต้องการ โดยไม่ต้องกักตุนสต็อก Spare Parts On-Demand คืออะไร?สถาปัตยกรรม Edge-to-Cloud — การวางงานคำนวณให้เหมาะกับระดับความเร็วที่แต่ละงานต้องการ (ภาพประกอบ: Honey Corporation)สถาปัตยกรรม Edge-to-Cloud — การวางงานคำนวณให้เหมาะกับระดับความเร็วที่แต่ละงานต้องการ (ภาพประกอบ: Honey Corporation) Spare Parts On-Demand คือกลยุทธ์การผลิตอะไหล์เครื่องจักรโดยใช้เทคโนโลยีการพิมพ์สามมิติ (3D Printing / Additive Manufacturing) เพื่อสร้างชิ้นส่วนทดแทน เฉพาะเมื่อมีความต้องการจริง แทนที่จะผลิตหรือสั่งซื้อล่วงหน้าเป็นจำนวนมากเก็บไว้ในคลัง แนวคิดนี้เปลี่ยนรูปแบบการจัดการสต็อกอะไหล่จาก Make-to-Stock เป็น Make-to-Order โดยใช้ไฟล์ดิจิทัลเป็น “คลังอะไหล่เสมือน” (Digital Inventory) แทนชั้นวางของจริง จุดเปลี่ยนสำคัญคือ เมื่อแบบอะไหล่ถูกแปลงเป็นไฟล์ CAD/STL ที่จัดเก็ได้ในระบบคลาวด์ โรงงานสามารถเก็บอะไหล่ นับหมื่นชนิดในรูปแบบดิจิทัลโดยไม่ใช้พื้นที่คลังสินค้าใดๆ และสั่งพิมพ์ได้ทันทีเมื่อเครื่องจักรเสีย ลด Lead Time จากหลายสัปดาห์เหลือเพียงไม่กี่ชั่วโมงถึงไม่กี่วัน ทำไมโรงงานอุตสาหกรรมต้องเผชิญปัญหาอะไหล่? ปัญหาการจัดการอะไหล่ของโรงงานอุตสาหกรรมเป็นความท้าทายเรื้อรังที่มีหลายมิติ: 1. ปัญหา Obsolescence (อะไหล่ตกยุค) อุปกรณ์และเครื่องจักรอุตสาหกรรมมีอายุการใช้งานยาวนาน 15–30 ปี แต่ผู้ผลิตมักเลิกสนับสนุนอะไหล่ (End-of-Life) หลังจากผ่านไป 7–10 ปี เมื่อเครื่องจักรเก่าเสีย การหาอะไหล่แทนกลายเป็นเรื่องเกือบเป็นไปไม่ได้ บางกรณีต้องสั่งผลิตพิเศษซึ่งมีความซับซ้อนสูงมากและใช้เวลานาน 2. ภาระการเก็บสต็อกที่สูง โรงงานต้องเก็บสต็อกอะไหล์ไว้เพื่อรองรับการซ่อมบำรุงเชิงรุก แต่จากสถิติพบว่าอะไหล่ที่เก็บไว้มากกว่า 50% อาจไม่เคยถูกใช้งานเลยตลอดอายุการใช้งานของเครื่องจักร ทรัพยากรที่ถูกอุ้มอยู่ในสต็อกเหล่านี้สามารถนำไปลงทุนในส่วนอื่นได้ 3. Supply Chain ที่ยาวและเปราะบาง อะไหล่จำนวนมากต้องนำเข้าจากต่างประเทศ ผ่านห่วงโซ่อุปทานที่ซับซ้อน เมื่อเกิดเหตุการณ์ระดับโลก เช่น การระบาดของโรค ความขัดแย้งทางการค้า หรือการขนส่งขัดข้อง การจัดหาอะไหล่ก็หยุดชะงักทันที เกณฑ์เปรียบเทียบ อะไหล่แบบดั้งเดิม Spare Parts On-Demand ระยะเวลาจัดหา 2–8 สัปดาห์ ไม่กี่ชั่วโมง – วัน พื้นที่จัดเก็บ ต้องมีคลังสินค้ากว้าง ไฟล์ดิจิทัล (เกือบไม่ใช้พื้นที่) ความเสี่ยงขาดสต็อก สูง (เฉพาะชิ้นที่หายาก) ต่ำมาก (พิมพ์ได้ทันที) ตัวเลือกวัสดุ จำกัดตามผู้ผลิตเดิม เลือกวัสดุได้หลากหลาย เทคโนโลยีการพิมพ์ที่เหมาะกับอะไหล่อุตสาหกรรม การเลือกเทคโนโลยีพิมพ์สำหรับอะไหล่ขึ้นอยู่กับวัสดุ ความแข็งแรง และความต้องการทางกลของชิ้นส่วน: FDM (Fused Deposition…
Read More