Case Study: Smart Earplugs กับ Noise Dosimetry — เมื่อโรงงานย้ายจุดวัดเสียงจากอากาศเข้าไปในหูของคนงาน

Case Study: Smart Earplugs กับ Noise Dosimetry — เมื่อโรงงานย้ายจุดวัดเสียงจากอากาศเข้าไปในหูของคนงาน

Article
โรคประสาทหูเสียจากเสียงดัง (Noise-Induced Hearing Loss) เป็นโรคจากการทำงานที่พบมากที่สุดโรคหนึ่งของโลก แต่กลับเป็นโรคที่ ป้องกันได้เกือบทั้งหมด ถ้าจัดการถูกวิธี ปัญหาคือ "ถูกวิธี" นั้นยากกว่าที่คิด เพราะที่ดังในโรงงานไม่คงที่ ที่อุดหูที่แจกให้คนงานมักใส่ไม่แนบพอ และผู้ดูแลความปลอดภัยไม่มีข้อมูลว่าแต่ละคนสัมผัสเสียงเท่าไรจริง ๆ ในแต่ละวัน บทความนี้เป็น case study เชิงกระบวนการ — ถอดรหัสว่าโรงงานหนึ่งแก้ปัญหานี้ด้วยการผสาน Smart Earplugs แบบวัดโดสเสียง (Noise Dosimetry) เข้ากับโปรแกรมอนุรักษ์การได้ยิน (Hearing Conservation Program) ตั้งแต่วินิจฉัยปัญหา ไปจนถึงผลลัพธ์ที่วัดได้ การใส่ที่อุดหูให้แนบสนิทคือขั้นตอนที่มักทำผิด — งานวิจัยด้านอนุรักษ์การได้ยินพบว่าที่อุดหูที่ใส่ไม่พอดีให้การลดเสียงจริงน้อยกว่าค่า NRR บนฉลากอย่างมาก (ภาพ: Wikimedia Commons, Public Domain) ปัญหา: ฉลากบอกอย่าง ความจริงอย่าง จุดเริ่มของ case นี้คือคำถามสั้น ๆ ที่ผู้จัดการโรงงานตั้งขึ้นหลังได้รับผลตรวจการได้ยินประจำปี: "เราแจกที่อุดหู NRR อย่างดีทุกคน ทำไม % การได้ยินผิดปกติยังเพิ่มขึ้นทุกปี?" เมื่อไล่หาสาเหตุ พบปัญหา 3 ชั้นที่ซ้อนกัน: ค่า NRR บนฉลากไม่ใช่ค่าที่ได้จริง — NRR (Noise Reduction Rating) วัดในห้องทดลองกับผู้ทดสอบที่ใส่อย่างสมบูรณ์แบบ แต่งานวิจัยสาธารณะด้าน fit testing พบว่าคนงานทั่วไปได้การลดเสียงจริงเพียงบางส่วนของค่าฉลาก บางกรณีต่ำกว่าครึ่ง เพราะใส่หลวม ไม่บีบยางก่อนสอด หรือถอดออกคุยโทรศัพท์ระหว่างกะ ค่าเฉลี่ยพื้นที่ปกปิดช่วงพีค — การวัดด้วย sound level meter จุดลอยให้ค่าเฉลี่ย 8 ชั่วโมง แต่งานจริงมีช่วงพีคสั้น ๆ ที่ดังกว่ามาก เช่น การเป่าลมแรง การเคาะตะแกรง หรือช่วงเปลี่ยนดรัมเจียร ซึ่งไม่ปรากฏในค่าเฉลี่ย ไม่มีข้อมูลรายบุคคล — สองคนทำงานแผนกเดียวกันอาจสัมผัสเสียงต่างกัน 3 เท่า ขึ้นกับตำแหน่งจริงและงานที่ได้รับมอบหมายวันนั้น การออกแบบมาตรการด้วยค่าเฉลี่ยจึงปกป้องบางคนเกิน บางคนไม่พอ โซลูชัน: ย้ายจุดวัดเข้าไปในหูของคนงาน แนวทางที่เลือกคือการติดตั้ง Smart Earplugs ที่มีไมโครโฟนวัดโดสติดตัว ในกลุ่มตัวอย่างแรก 30 คนจากแผนกเสียงดังสุด อุปกรณ์ประเภทนี้ทำงาน 3 หน้าที่พร้อมกัน: ป้องกัน — ตัวปิดหูแบบ passive ลดเสียงระดับ 20–27 dB ตามดีไซน์ (ค่า SNR อ้างอิงมาตรฐาน ISO 4869-2) วัด —…
Read More
บทวิเคราะห์: XR Collaboration Room — เมื่อ Design Review ย้ายไปอยู่ในโมเดล CAD สเกล 1:1

บทวิเคราะห์: XR Collaboration Room — เมื่อ Design Review ย้ายไปอยู่ในโมเดล CAD สเกล 1:1

Article
Design Review ที่กำลังล้าสมัย นับตั้งแต่มี CAD 3 มิติ การทบทวนแบบ (design review) ของโรงงานก็ถูกจำกัดอยู่ที่สองรูปแบบ คือการดูภาพ render บนจอ และการพิมพ์แบบออกมาบนโต๊ะประชุม ทั้งสองแบบมีข้อจำกัดร่วมกันคือ ผู้ร่วมประชุมไม่ได้ "อยู่ใน" ห้วงอุปกรณ์ที่กำลังออกแบบ มุมมอง 1:1 ระยะการเอื้อม และความรู้สึกของพื้นที่จริง ถูกบีบอัดเหลือแค่ภาพบนจอ 27 นิ้ว ยิ่งไปกว่านั้น ทีมออกแบบและทีมผลิตมักอยู่คนละที่ การเดินทางเพื่อประชุมตรวจแบบหนึ่งครั้งกินเวลาหลายวัน ทำให้จำนวนรอบการ review ถูกลดจนเหลือน้อยเกินความจำเป็น และความคิดเห็นของผู้ที่ต้องเป็นคนเดินตามแบบจริง (ช่างติดตั้ง ทีม maintenance) มักถูกละเลย ทีมงานใช้ VR ร่วมกันในห้องจำลอง — แนวคิดเดียวกับ XR design review ที่ทุกคนเห็นโมเดล 3 มิติร่วมกันในสเกลจริง (ภาพ: Wikimedia Commons) XR Collaboration Room ทำงานอย่างไร XR Collaboration Room คือห้องประชุมเสมือนที่ผู้เข้าร่วมสวม headset แล้วพบกันในรูปแบบ avatar ตรงหน้าโมเดล 3 มิติของสายการผลิต อุปกรณ์ หรืออาคาร ที่ import มาจากไฟล์ CAD โดยตรง องค์ประกอบทางเทคนิคที่สำคัญมี 4 ส่วน: Data Preparation: ไฟล์ CAD ต้นฉบับมักหนักเกินไปสำหรับการ render แบบ real-time จึงต้องผ่านกระบวนการ simplification และ level of detail (LOD) เพื่อลดจำนวน polygon โดยคงความถูกต้องเชิงมิติ Co-location ในเชิงเสมือน: ผู้เข้าร่วมทุกคนเห็นโมเดลเดียวกันในตำแหน่งเดียวกัน สามารถชี้ วาดเส้น และตัดชิ้นส่วน (section cut) ได้พร้อมกันแบบ real-time Scale 1:1: จุดเด่นที่จอทำไม่ได้ ผู้เข้าร่วมเดินเข้าไป "ยืน" ข้างแท่นวางเครื่องจักรจำลองแล้วประเมินความสูง ระยะ clearance และทางเข้าออกได้ด้วยตัวเอง Recording: ระบบบันทึก session รวมถึงความคิดเห็นและ markup ที่เกิดขึ้น เพื่อให้คนที่ไม่ได้เข้าร่วมย้อนดูได้ และให้ทีมออกแบบตามลำดับความเห็นที่ถูกบันทึกไว้ โมเดล CAD 3 มิติคือวัตถุดิบตั้งต้นของ XR design review ก่อนผ่านการ simplification ลด…
Read More
VR Ergonomic Risk Assessment: วิเคราะห์ท่าทางการทำงานด้วย REBA/RULA และ Digital Human Modeling

VR Ergonomic Risk Assessment: วิเคราะห์ท่าทางการทำงานด้วย REBA/RULA และ Digital Human Modeling

Article
ทำไม Ergonomics กลายเป็นงานวิศวกรรมที่ "วัดผลได้" ในยุคดิจิทัล ด้าน Ergonomics หรือ Human Factors Engineering เคยถูกมองเป็นเรื่อง "นามธรรม" ของโรงงานมานาน วิศวกรส่วนใหญ่รู้ว่าท่าทางการทำงานที่ผิดธรรมชาติคือต้นเหตุของการบาดเจ็บสะสม แต่การจะพิสูจน์ให้ฝ่ายบริหารเห็นตัวเลขที่ชัดเจนกลับทำได้ยาก นับตั้งแต่เครื่องมือประเมินเชิงสังเกตการณ์ (Observational Tools) อย่าง REBA (Rapid Entire Body Assessment) ที่เผยแพร่โดย Dr. Sue Hignett และ Dr. Lynn McAtamney ในวารสาร Applied Ergonomics เมื่อปี 1998 และ RULA (Rapid Upper Limb Assessment) ของ Dr. Lynn McAtamney และ Prof. E. Nigel Corlett ปี 1993 ปัญหานี้เริ่มมีทางออก เพราะเครื่องมือทั้งสองเปลี่ยน "ท่าทาง" ให้กลายเป็น "คะแนนความเสี่ยง" ที่บริหารจัดการได้ ปัญหาเดิมของวิธีสังเกตการณ์คือการนั่งจับอิริยาบถจากวิดีโอแล้วให้คะแนนทีละเฟรม ซึ่งใช้เวลามหาศาลและขึ้นกับวิจารณญาณของผู้ประเมิน VR ทำให้เรื่องนี้เปลี่ยนไป ชุดหูฟัง XR สมัยใหม่บันทึกตำแหน่งหัวและคอนโทรลเลอร์ด้วยระบบ Inside-out Tracking ที่ความถี่ 72-120 Hz ร่วมกับ Inertial Measurement Unit (IMU) ในตัวอุปกรณ์ ทำให้ได้ข้อมูลมุมข้อต่อที่ต่อเนื่องตลอดการทำงาน ไม่ใช่แค่ภาพนิ่ง 3-5 ภาพต่อรอบการประเมินแบบเดิม ชุด Motion Capture สำหรับบันทึกการเคลื่อนไหว ต้นทางของข้อมูลมุมข้อต่อที่ป้อนเข้าสู่การคำนวณ REBA/RULA อัตโนมัติ (ภาพ: Wikimedia Commons) จากท่าทางสู่ตัวเลข: กลไกการให้คะแนนของ REBA และ RULA เพื่อให้เห็นภาพว่า VR เปลี่ยนการประเมินให้เร็วขึ้นอย่างไร เราต้องเข้าใจกลไกใต้ปีกเครื่องมือสองตัวนี้ก่อน REBA จะแบ่งร่างกายเป็น 2 กลุ่ม กลุ่ม A ประกอบด้วย ลำตัว คอ และขา ส่วนกลุ่ม B คือ ต้นแขน ปลายแขน และข้อมือ แต่ละส่วนถูกให้คะแนนตามมุมที่วัดได้ เช่น ลำตัวเอนมากกว่า 60 องศาได้คะแนนมากกว่าการเอนเพียง 20 องศา จากนั้นนำมารวมกับตัวคูณเพิ่ม (Coupling Score) และน้ำหนักที่ยก ก่อนออกมาเป็นคะแนนรวม…
Read More
บทวิเคราะห์ Hybrid Cloud ในโรงงานอุตสาหกรรม 2026: งานไหนควรอยู่ On-premise งานไหนควรขึ้นคลาวด์

บทวิเคราะห์ Hybrid Cloud ในโรงงานอุตสาหกรรม 2026: งานไหนควรอยู่ On-premise งานไหนควรขึ้นคลาวด์

Article
คำถามที่ฝ่าย IT ของโรงงานไทยถามกันบ่อยที่สุดในปี 2026 ไม่ใช่ "ควรขึ้นคลาวด์ไหม" อีกต่อไป แต่คือ "งานไหนควรอยู่ที่ไหน" เมื่อระบบ SCADA, MES และ data platform ต้องทำงานร่วมกันทั้งบน on-premise และคลาวด์ คำตอบที่กำลังได้รับความนิยมคือ Hybrid Cloud — สถาปัตยกรรมที่ไม่เลือกข้าง แต่จัดวาง workload ตามลักษณะของงาน บทความนี้วิเคราะห์มุมมองของเราที่ Honey Corporation จากประสบการณ์ทำ System Integration ในภาคอุตสาหกรรมไทย ว่าเส้นแบ่งระหว่าง on-premise กับคลาวด์ควรอยู่ตรงไหนจึงจะได้ประโยชน์สูงสุดโดยไม่สร้างความเสี่ยงใหม่ เซิร์ฟเวอร์ในโรงงาน (on-premise) ยังคงเป็นที่พำนักของระบบ real-time control และข้อมูลดิบ — ขณะที่คลาวด์รับงานวิเคราะห์ระยะยาว (ภาพ: Wikimedia Commons) ทำไม "All-in Cloud" และ "All-in On-premise" ต่างก็ไม่ใช่คำตอบ ฝ่ายที่ผลักดัน all-in cloud มักอ้างเรื่องความยืดหยุ่น ไม่ต้องลงทุน hardware ล่วงหน้า และเข้าถึงบริการ AI ได้ทันที แต่ในบริบทโรงงาน มีสามข้อจำกัดที่ยังแก้ไม่ตก: Latency และ dependency — ระบบควบคุมกระบวนการผลิตต้องทำงานต่อแม้อินเทอร์เน็ตขาด การพึ่งพาคลาวด์ 100% ในงาน critical loop คือความเสี่ยงที่ยอมรับไม่ได้ ปริมาณข้อมูลดิบ — เซ็นเซอร์หลายพันจุดสร้างข้อมูลดิบมหาศาล การเก็บทั้งหมดบนคลาวด์เป็นการใช้ทรัพยากรอย่างสิ้นเปลือง ทั้งยังมีค่าใช้จ่าย egress เมื่อต้องดึงกลับมาวิเคราะห์ ข้อกำหนดด้านข้อมูล — ลูกค้าบางรายหรือกฎหมายบางประเทศกำหนดว่าข้อมูลกระบวนการผลิตบางประเภทห้ามออกนอกประเทศ ในทางกลับกัน all-in on-premise ก็แพ้ในเกมระยะยาว: ทีมงานจำกัด การขยายระบบช้า และการเข้าถึงเครื่องมือ AI/ML สมัยใหม่ที่คลาวด์พัฒนาออกมาตลอดเวลา ทำได้ลำบากกว่ามาก เส้นแบ่งที่เราใช้: วาง workload ตาม 4 คำถาม จากประสบการณ์ติดตั้งระบบให้โรงงานหลายแห่ง เราสรุปกรอบการตัดสินใจ 4 คำถาม ก่อนวาง workload ใดๆ ลงที่ไหน: Workload ความเร็วที่ต้องการ ลักษณะข้อมูล ที่วางที่เหมาะสม Real-time control / interlockมิลลิวินาทีข้อมูลดิบหมุนเร็วOn-premise (PLC/DCS) Line dashboard / Andonวินาทีข้อมูลรวมระดับสายผลิตOn-premise edge server OEE, production reportนาที–ชั่วโมงข้อมูลสรุปรายวัน/รายสัปดาห์Cloud ML…
Read More
How-to: ออกแบบ Edge-to-Cloud Data Pipeline สำหรับโรงงาน IIoT ใน 5 ขั้นตอน — จาก Data Source Inventory ถึงกฎการไหลของข้อมูล

How-to: ออกแบบ Edge-to-Cloud Data Pipeline สำหรับโรงงาน IIoT ใน 5 ขั้นตอน — จาก Data Source Inventory ถึงกฎการไหลของข้อมูล

Article
หลายโรงงานที่เริ่มทำ IIoT ติดอยู่ที่เดิม: เซ็นเซอร์ติดแล้ว ข้อมูลเห็นแล้ว แต่พอจะนำไปใช้จริงกลับพบว่าข้อมูลกระจัดกระจายในหลายระบบ รูปแบบไม่ตรงกัน และ dashboard ที่สวยงามนั้น ดูได้อย่างเดียว ไม่เชื่อมกับการตัดสินใจ รากของปัญหามักไม่ใช่เซ็นเซอร์หรือ AI แต่เป็น สายการไหลของข้อมูล (Data Pipeline) ที่ไม่ถูกออกแบบมาตั้งแต่ต้น บทความนี้เป็นคู่มือแบบทีละขั้น สำหรับวิศวกรที่ต้องการวาง pipeline จากเซ็นเซอร์ในสายการผลิต ผ่าน edge gateway ไปจนถึงคลาวด์อย่างเป็นระบบ — โดยไม่ต้องเป็น data engineer เต็มตัว สายการผลิตสมัยใหม่มีจุดเก็บข้อมูลกระจายอยู่ทั้งสาย — pipeline ที่ดีต้องรวมข้อมูลเหล่านี้ให้เป็นภาพเดียวก่อนส่งขึ้นคลาวด์ (ภาพ: Wikimedia Commons) ทำไมต้องเป็น Edge-to-Cloud (ไม่ใช่ส่งตรงขึ้นคลาวด์) ลองคำนวณง่ายๆ: มิเตอร์พลังงาน 200 จุด ส่งค่าทุก 1 วินาที รวมกว่า 17 ล้านค่าต่อวัน เพียงพอจะทำให้ฐานข้อมูลที่ออกแบบมาไม่ดีบวมในไม่กี่เดือน และการส่งข้อมูลดิบทั้งหมดขึ้นคลาวด์เป็นภาระ bandwidth ที่หลีกเลี่ยงได้ การคาดการณ์ของ Gartner ที่ชี้ว่าตลาด edge computing จะเติบโตจาก 131,000 ล้านดอลลาร์ (2023) สู่ 511,000 ล้านดอลลาร์ (2033) สะท้อนว่าโลกกำลังย้ายการประมวลผลกลับมาใกล้โรงงาน ไม่ใช่เพื่อแทนคลาวด์ แต่เพื่อส่งขึ้นคลาวด์เฉพาะ ข้อมูลที่มีคุณค่า Step 1: สำรวจและจัดทำ Inventory ของแหล่งข้อมูล ก่อนซื้ออุปกรณ์ใด ให้ทำ Data Source Inventory ให้ครบก่อน — ทุก PLC, VFD, มิเตอร์, เซ็นเซอร์ และไฟล์ที่คนงานบันทึกด้วยมือ ตัวอย่างตาราง: แหล่งข้อมูล โปรโตคอล อัตราการเก็บข้อมูล ปลายทางที่เหมาะสม PLC สายประกอบOPC UA100 msEdge สรุปผลก่อนส่ง Cloud VFD / มอเตอร์Modbus TCP1 วินาทีEdge (แจ้งเตือนความผิดปกติ) มิเตอร์พลังงานModbus RTU1 วินาทีEdge (สรุปเป็น profile 15 นาที) เซ็นเซอร์อุณหภูมิ/ความชื้นMQTT30 วินาทีEdge ส่งตรงขึ้น Cloud ตารางนี้จะบอกคุณเองว่าจุดรวมข้อมูล (aggregation point) ควรอยู่ที่ไหน และโปรโตคอลใดต้องการตัวแปลง Step 2: เลือก Edge Gateway ให้เหมาะกับงาน…
Read More
Edge Analytics ในโรงงานอุตสาหกรรม: วิเคราะห์ข้อมูลทันใจที่ตู้คอนโทรล ก่อนส่งขึ้นคลาวด์

Edge Analytics ในโรงงานอุตสาหกรรม: วิเคราะห์ข้อมูลทันใจที่ตู้คอนโทรล ก่อนส่งขึ้นคลาวด์

Article
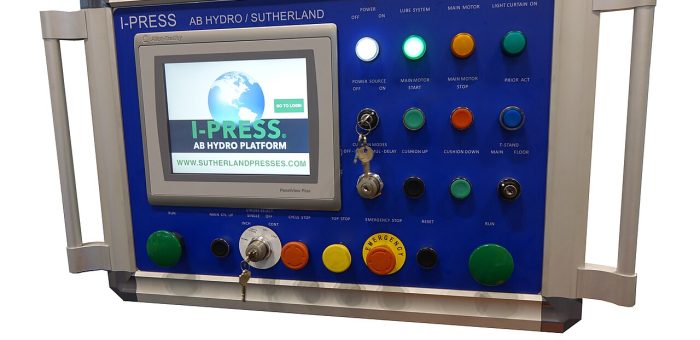
Edge Analytics คืออะไร — ในโรงงานสมัยใหม่ เซ็นเซอร์และเครื่องจักรหนึ่งแห่งสามารถผลิตข้อมูลได้วันละหลายกิกะไบต์ การส่งข้อมูลดิบทั้งหมดขึ้นคลาวด์ก่อนค่อยประมวลผลไม่ใช่คำตอบอีกต่อไป ทั้งจากค่า bandwidth, latency และความเสี่ยงเมื่ออินเทอร์เน็ตขาดหาย Edge Analytics คือการนำกระบวนการวิเคราะห์ข้อมูล — ตั้งแต่การกรองสัญญาณ คำนวณค่าสถิติ ไปจนถึงโมเดล AI — มาวางไว้ที่ edge of the network ใกล้กับแหล่งกำเนิดข้อมูล ไม่ว่าจะเป็น Edge Gateway ในตู้คอนโทรล คอมพิวเตอร์อุตสาหกรรมข้างสายการผลิต หรือเซิร์ฟเวอร์ในโรงงานเอง ผลลัพธ์คือการตัดสินใจเกิดขึ้นภายใน มิลลิวินาที แทนที่จะต้องรอไป-กลับคลาวด์หลายร้อยมิลลิวินาที ซึ่งเป็นความต่างระหว่าง "หยุดเครื่องทันเวลา" กับ "เสียชิ้นงานทั้งล็อต" แผงควบคุมอัตโนมัติที่เก็บ historical data ของเครื่อง press — จุดที่ Edge Analytics ทำงานจริง ก่อนข้อมูลจะถูกส่งขึ้นคลาวด์ (ภาพ: Wikimedia Commons) ทำไมปี 2026 ต้องพูดถึง Edge Analytics อีกครั้ง ตัวเลขสองชุดอธิบายได้ดีที่สุด รายงานของ IoT Analytics (Industry 4.0 & Smart Manufacturing Market Report 2026–2030) ระบุว่าตลาด Smart Manufacturing ทั่วโลกปี 2025 มีมูลค่า 175,000 ล้านดอลลาร์ และจะเติบโตด้วย CAGR 9.3% ไปแตะ 274,000 ล้านดอลลาร์ในปี 2030 ขณะที่ Gartner คาดการณ์ตลาด edge computing โลกจะขยายจาก 131,000 ล้านดอลลาร์ (2023) สู่ 511,000 ล้านดอลลาร์ภายในปี 2033 — เกือบ 4 เท่าใน 10 ปี แรงขับเคลื่อนที่แท้จริงไม่ใช่ตัวเทคโนโลยีเอง แต่เป็นสามแรงกดดันที่โรงงานไทยกำลังเผชิญ: (1) ปริมาณข้อมูลจาก IIoT sensor ที่เพิ่มขึ้นแบบทวีคูณจนส่งขึ้นคลาวด์ทั้งหมดไม่คุ้ม (2) งานที่ต้องการความเร็วระดับมิลลิวินาที เช่น การตรวจจับความผิดปกติของ vibration signature และ (3) นโยบาย data residency ที่บังคับให้ข้อมูลอ่อนไหวบางประเภทอยู่ในประเทศ สถาปัตยกรรม 3 ชั้นของ Edge Analytics Edge…
Read More
Case Study: อุปกรณ์ OT ติดอินเทอร์เน็ตโดยไม่รู้ตัว — จาก Flat Network สู่การแบ่งโซนตาม IEC 62443 ใน 4 ขั้นตอน

Case Study: อุปกรณ์ OT ติดอินเทอร์เน็ตโดยไม่รู้ตัว — จาก Flat Network สู่การแบ่งโซนตาม IEC 62443 ใน 4 ขั้นตอน

Article
สัปดาห์นี้เราเจอโจทย์คลาสสิกที่สุดจากโรงงานแปรรูปอาหารแห่งหนึ่ง: ระบบทำงานปกติทุกอย่าง แต่เมื่อทีมไอทีสแกนเครือข่ายเพื่อเตรียมขออนุมัติงบ IoT เพิ่ม กลับพบว่ามีอุปกรณ์ OT ที่ "ติดอินเทอร์เน็ตตรงๆ" โดยที่ไม่มีใครในโรงงานรู้ตัวมาก่อน กรณีแบบนี้ไม่ใช่เรื่องแปลก และตัวเลขล่าสุดยืนยันว่ามันระดับ "ระบาด" ไปแล้วทั่วโลก สถานการณ์: ตัวเลขที่ทำให้ทุกโรงงานต้องหยุดอ่าน งานวิจัยด้าน OT Security ล่าสุดที่วิเคราะห์ตัวอย่างจากอุปกรณ์ไฟร์วอลล์ OT กว่า 60,000 เครื่องทั่วโลก และตัวอย่างซอฟต์แวร์ 16 ล้านชิ้น พบว่าจำนวน อุปกรณ์ OT ที่เปิดใช้งานและมองเห็นได้จากอินเทอร์เน็ต เพิ่มขึ้น 332% เทียบกับช่วงสำรวจก่อนหน้า ขณะเดียวกันในภาคองค์กรทั่วไป ยังมีเครือข่ายที่ใช้สถาปัตยกรรมแบบแบน (flat network) อยู่ราว 77.7% และมีสัดส่วนการเชื่อมต่อ IoT ที่ถูกประเมินว่า "ความเสี่ยงสูง" ถึง 48.2% — เมื่อคูณสามตัวเลขนี้เข้าด้วยกันกับจำนวนอุปกรณ์เชื่อมต่อ 21.1 พันล้านเครื่อง จะได้ภาพคร่าวๆ ว่ามีการเชื่อมต่อระดับหลายพันล้านรายการที่ทำงานอยู่ในเครือข่ายที่ "แออัดและเปิดโล่ง" เกินไป ห้องควบคุมการผลิตคือหัวใจของระบบ OT — แต่ทุกแผงควบคุมที่ต่อเข้าเครือข่ายเดียวกับออฟฟิศโดยไม่มีการแบ่งโซน คือประตูเปิดที่ผู้โจมตีมองหา (ภาพ: Wikimedia Commons, CC BY 2.0) ปัญหา (Problem): ทำไมมันเกิดขึ้นได้ เครือข่ายแบน (Flat Network) — อุปกรณ์ทุกชนิดอยู่ใน VLAN เดียวกัน เมื่อเครื่องพิมพ์ออฟฟิศโดนเจาะ ผู้โจมตีเห็นชื่อ PLC และ HMI ใน scan ถัดไปทันที การเข้าถึงระยะไกลแบบทางลัด — ผู้รับเหมาหรือทีมซ่อมเปิด port forwarding บนเราเตอร์เพื่อ remote เข้าเครื่องจักรจากภายนอก แล้วลืมปิด กลายเป็นอุปกรณ์ OT ที่มองเห็นจากอินเทอร์เน็ต มองไม่เห็น = บริหารไม่ได้ — โรงงานส่วนใหญ่ไม่มีบัญชีสินทรัพย์ IT/OT ที่เป็นหนึ่งเดียว จึงไม่รู้ด้วยซ้ำว่ามีอุปกรณ์แปลกปลอมหลุดเข้ามาในเครือข่ายเมื่อไหร่ ทางแก้ (Solution): แบ่งโซนตาม IEC 62443 ทีละขั้น เราแนะนำแนวทางเดียวกับที่ใช้ในงานประเมินจริง คือแบ่งเครือข่ายเป็น โซน (Zone) และท่อร่วม (Conduit) ตามแนวคิดของมาตรฐานสากล IEC 62443 โดยเริ่มจาก 4 ขั้นตอนที่ทำได้จริงในโรงงานที่ยังผลิตอยู่: ทำ Asset Inventory ด้วย Passive Monitoring — ติดอุปกรณ์ดักฟังทราฟฟิก (ไม่ต้องหยุดการผลิต)…
Read More
บทวิเคราะห์ WRC 2026: เมื่อหุ่นยนต์ถูกถามว่า “ทำงานจริงได้หรือยัง” — สัญญาณจากปักกิ่งที่โรงงานไทยต้องอ่าน

บทวิเคราะห์ WRC 2026: เมื่อหุ่นยนต์ถูกถามว่า “ทำงานจริงได้หรือยัง” — สัญญาณจากปักกิ่งที่โรงงานไทยต้องอ่าน

Article
กลางเดือนสิงหาคมที่ผ่านมา งาน World Robot Conference (WRC) 2026 ที่ปักกิ่งปิดฉากลงด้วยภาพที่ต่างจากปีก่อนๆ อย่างชัดเจน — ไม่ใช่การแข่งกันอวดว่าโมเดลฉลาดแค่ไหน แต่เป็นการถูกถามคำถามตรงๆ ว่า "หุ่นยนต์ตัวนี้ทำงานจริงได้หรือยัง" และคำถามนั้น เป็นคำถามเดียวกันที่ผู้จัดการโรงงานในไทยถามทุกวัน ตัวเลขจากงานบอกอะไร ปีนี้ WRC มีผู้เข้าร่วมแสดงสินค้ามากกว่า 300 ราย เพิ่มขึ้นราว 40% จากปีก่อน พร้อมหุ่นยนต์บนเวทีราว 3,000 ตัว ในพื้นที่ 52,000 ตารางเมตร ขยายเป็น 4 ฮอลล์ แต่สิ่งที่น่าสนใจกว่าขนาดงานคือองค์ประกอบของคนในงาน: มี รัฐวิสาหกิจ (SOE) 49 แห่ง เดินทางมาร่วมกัน พร้อมส่งมอบ 12 สถานการณ์วิศวกรรมจริง ตั้งแต่งานโครงข่ายไฟฟ้า อวกาศ เหมืองแร่ ไปจนถึงงานโลหกรรม เพื่อหาโซลูชันหุ่นยนต์ที่ใช้งานได้จริง — ผู้ซื้อมาหาผู้ขายด้วยโจทย์จริง ไม่ใช่แค่มาชมเทคโนโลยี จาก VLA สู่ World Model — วิวัฒนาการที่โรงงานควรเข้าใจ กระแสเทคนิคที่เปลี่ยนไปจากปีก่อนคือ ปี 2025 คนพูดถึง Vision-Language-Action (VLA) model กันทั้งงาน แต่ปีนี้ผู้แสดงสินค้าหันมาพูดถึงการผสาน World Model เข้ากับ VLA แทน — งานวิจัยที่เผยแพร่บน arXiv ช่วงก่อนหน้านี้ก็ไปในทิศทางเดียวกัน โดยนำเสนอวิธี pre-train ที่ทำให้ policy เดียวทำงานข้ามรูปแบบหุ่นยนต์ที่ต่างกันได้ เหตุผลทางเทคนิคง่ายกว่าที่คิด: VLA เพียวๆ มองเห็นฉาก ตีความคำสั่ง แล้วสั่งการเคลื่อนไหวได้ แต่มันไม่ได้ "คาดเดา" ว่าสิ่งแวดล้อมจะเปลี่ยนไปอย่างไรหลังการกระทำนั้น เมื่องานยาวขึ้น ความผิดพลาดจึงสะสม และประสิทธิภาพตกทันทีที่เจอสถานการณ์ไม่คุ้นเคย — ซึ่งเป็นเรื่องปกติมากในสายการผลิตจริง ที่ตำแหน่งชิ้นงานคลาดเคลื่อนหรือของหลุดมือจาก pallet ได้ตลอดเวลา มุมเปรียบเทียบVLA เพียวๆVLA + World Model การมองสถานการณ์รับรู้ฉากปัจจุบันแบบ snapshotคาดการณ์การเปลี่ยนแปลงของสภาพแวดล้อม งานยาว (Long-horizon)error สะสม ประสิทธิภาพตกเสถียรกว่า เพราะคาดผลลัพธ์ก่อนลงมือ สถานที่ไม่คุ้นเคยต้องเทรนใหม่เมื่อ layout เปลี่ยน generalize ได้ดีกว่า ปรับตัวเร็วกว่า ความเร็วอนุมานเร็วกว่า (pipeline สั้น)ช้ากว่า แต่บางสถาปัตยกรรมลดช่องว่างได้ (มีรายงานเร็วขึ้น 2.71 เท่าจาก autoregressive แบบเดิม) การหยิบจับวัตถุด้วยมือหุ่นยนต์ในสภาพแวดล้อมจริง — งานที่ง่ายสำหรับคนแต่ยากที่สุดสำหรับโมเดล เพราะต้องคาดการณ์แรง…
Read More
State of IoT ล่าสุด: อุปกรณ์เชื่อมต่อทั่วโลกแตะ 21.1 พันล้านเครื่อง — โรงงานไทยควรอ่านตัวเลขไหนให้ขาด

State of IoT ล่าสุด: อุปกรณ์เชื่อมต่อทั่วโลกแตะ 21.1 พันล้านเครื่อง — โรงงานไทยควรอ่านตัวเลขไหนให้ขาด

Article
ทุกครั้งที่มีรายงานใหม่ออกมา เรามักเห็นพาดหัวแบบ "IoT โตมหาศาล" แต่คนทำงานในโรงงานควรสนใจตัวเลขจริงที่อยู่เบื้องหลัง เพราะมันบอกอะไรละเอียดกว่านั้นมาก — ล่าสุด IoT Analytics (ตุลาคม 2025) ปรับปรุงตัวเลข State of IoT รอบใหม่ และมีทั้งข่าวดีและสัญญาณเตือนที่น่าสนใจสำหรับผู้วางแผนระบบ IIoT ในไทย ตัวเลขหลักที่ต้องจำ จำนวนอุปกรณ์ IoT ที่เชื่อมต่ออยู่ทั่วโลกแตะ 21.1 พันล้านเครื่อง ณ สิ้นปี 2025 เพิ่มขึ้น 14% จาก 18.5 พันล้านเครื่องในปี 2024 และคาดการณ์ว่าจะไปถึง 39 พันล้านเครื่องในปี 2030 (CAGR 13.2%) ก่อนทะลุ 50 พันล้านเครื่องราวปี 2034–2035 น่าสังเกตว่าการเติบโต 14% นี้เกิดขึ้น "แม้" การลงทุนขององค์กรจะถูกเลื่อนออกไป และดีมานด์ในจีนชะลอตัวจน forecast ถูกปรับลงราว 300 ล้าน connection จากที่คาดไว้ก่อนหน้า ปีอุปกรณ์ IoT เชื่อมต่อ (พันล้านเครื่อง)การเติบโต YoY 202418.5+12% 202521.1+14% 2030 (คาด)39.0CAGR 13.2% 2035 (คาด)>50ชะลอหลังปี 2030 ที่มา: IoT Analytics, State of IoT 2025 (อัปเดต Fall 2025) 3 เทคโนโลยีที่กินส่วนแบ่งเกือบ 80% เบื้องหลังตัวเลขรวม การเชื่อมต่อ IoT แทบทั้งหมดกระจุกอยู่ใน 3 เทคโนโลยีหลักคือ Wi-Fi, Bluetooth และ Cellular IoT ซึ่งรวมกันคิดเป็นเกือบ 80% ของ connection ทั้งหมด โดย Cellular IoT โตเร็วกว่าค่าเฉลี่ยตลาด — เฉพาะปี 2026 คาดว่าจะมี connection แบบเซลลูลาร์ถึง 5.4 พันล้าน line (CAGR 14.3% ถึงปี 2030) เพราะงานอุตสาหกรรม โลจิสติกส์ และการแพทย์ ต้องการการเชื่อมต่อที่ควบคุมได้และครอบคลุมพื้นที่กว้างโดยไม่ต้องวางโครงข่ายเอง แผนภาพแนวคิด Industry 4.0 — การเชื่อมต่อระหว่างเครื่องจักร ข้อมูล และระบบสารสนเทศคือหัวใจของการเติบโตของ IoT (ภาพ: Wikimedia…
Read More
Cyber Resilience สำหรับโรงงาน: ศาสตร์แห่งการกลับมาผลิตให้เร็วที่สุด เมื่อการโจมตีหยุดไม่ได้

Cyber Resilience สำหรับโรงงาน: ศาสตร์แห่งการกลับมาผลิตให้เร็วที่สุด เมื่อการโจมตีหยุดไม่ได้

Article
เมื่อการโจมตีเปลี่ยนจาก "ขอเงิน" ไปเป็น "หยุดโรงงาน" — คำถามจึงไม่ใช่ว่าจะโดนหรือไม่ แต่คือกลับมาผลิตได้เร็วแค่ไหน ตลอดหลายปีที่ผ่านมา โรงงานอุตสาหกรรมคุ้นเคยกับ ransomware ในรูปแบบ "เข้ารหัสข้อมูล แล้วขอค่าไถ่" แต่แนวโน้มที่ชัดเจนในปี 2026 คือการเปลี่ยนเป้าหมายไปที่ operational disruption — การหยุดการผลิตโดยตรง ไม่จำเป็นต้องเข้ารหัสอะไรเลย อาจเป็นแค่การแก้ control logic ให้ไลน์หยุดเป็นพักๆ หรือปิดระบบ monitoring ชั่วคราวจนโรงงานต้องปิดเครื่องเพื่อความปลอดภัย รายงานจากสายงาน OT security ระบุว่า downtime ที่ไม่ได้วางแผนของบริษัทอุตสาหกรรมในเยอรมนีมีมูลค่าราว 147,000 ยูโรต่อชั่วโมง ตัวเลขนี้อธิบายว่าทำไมผู้โจมตีจึงหันมา "เล่นกับเวลา" แทนการเล่นกับข้อมูล — ทุกชั่วโมงที่ไลน์หยุด คือแรงกดดันที่เพิ่มขึ้นต่อฝ่ายบริหาร และคือ leverage ของฝ่ายโจมตีในการเจรจา ในโลกที่การป้องกันร้อยเปอร์เซ็นต์เป็นไปไม่ได้ Cyber Resilience จึงกลายเป็นคำถามที่วิศวกรโรงงานต้องตอบให้ได้: ไม่ใช่ "จะไม่ให้โดนได้อย่างไร" แต่คือ "เมื่อโดนแล้ว จะกลับมาผลิตได้เร็วแค่ไหน โดยไม่เสียความปลอดภัย" ระบบ IT ที่รองรับการกู้คืนโรงงาน — backup ที่ดีไม่ได้อยู่แค่ในห้องเซิร์ฟเวอร์ แต่ต้องมีสำเนาที่ผู้โจมตีแตะไม่ได้ (ภาพ: Wikimedia Commons, CC BY-SA 3.0) เปลี่ยนกรอบคิด: จาก Prevention เป็น Resilience กรอบคิดเดิมวางเงินไปที่กำแพง — firewall, antivirus, access control ซึ่งยังจำเป็นอยู่ แต่กรอบคิด resilience เพิ่มคำถามอีกสามข้อที่มักถูกลืม: ระบบจะ ตรวจจับการโจมตีได้เร็วแค่ไหน (MTTD), จะ จำกัดความเสียหายไม่ให้ลามไปทั้งโรงงานได้อย่างไร และจะ กู้คืนกลับมาผลิตได้ภายในเวลาเท่าไร (MTTR) มิติ กรอบคิดแบบ Prevention กรอบคิดแบบ Resilience เป้าหมายไม่ให้ผู้โจมตีเข้ามาได้เข้ามาแล้วรอด เห็นเร็ว กลับมาผลิตได้เร็ว ตัวชี้วัดหลักจำนวนการโจมตีที่บล็อกได้MTTD และ MTTR เทียบกับ RTO ที่ธุรกิจกำหนด บทบาทของ backupเป็นงานฝ่าย IT ตามหลังเป็นแกนหลักของการกู้คืน ต้องทดสอบทุกไตรมาส การซ้อมซ้อม table-top ปีละครั้ง (ถ้ามี)restore drill บน testbed ทุกไตรมาส วัดเวลาจริง ผู้รับผิดชอบทีม IT securityทีมผลิต + วิศวกรรม + IT ร่วมกัน หัวใจของการกู้คืนโรงงาน: สำรองสิ่งที่ "เป็นตัวโรงงาน"…
Read More