Case Study: เมื่อ ‘เอลนีโญ’ บังคับให้โรงงาน EEC ต้องลดการใช้น้ำ 10-15% — Smart Water Management ด้วย IIoT คือคำตอบของปี 2569-2570

Case Study: เมื่อ ‘เอลนีโญ’ บังคับให้โรงงาน EEC ต้องลดการใช้น้ำ 10-15% — Smart Water Management ด้วย IIoT คือคำตอบของปี 2569-2570

Article
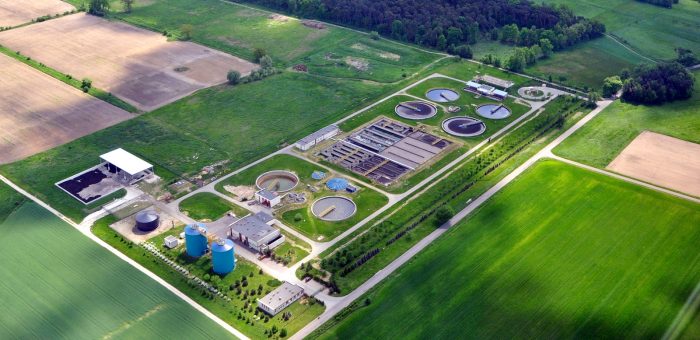
"โรงงานในนิคมอุตสาหกรรมต้องลดการใช้น้ำลง 10-15% และต้องนำน้ำเสียกลับมาบำบัดหมุนเวียนใช้ใหม่ไม่น้อยกว่า 15% ของปริมาณน้ำที่ใช้" — นี่ไม่ใช่คำแนะนำ แต่คือเป้าหมายบังคับที่หน่วยงานบริหารทรัพยากรน้ำแห่งชาติ (สทนช.) ประกาศผ่านแผนรับมือสภาวะเอลนีโญ ปี 2569-2570 สำหรับพื้นที่เขตเศรษฐกิจพิเศษภาคตะวันออก (EEC) อันประกอบด้วยฉะเชิงเทรา ชลบุรี และระยอง ทำไมถึงเข้มงวดขนาดนี้? เพราะตัวเลขของแท้เล่าเรื่องเดียวกันทั้งหมด: สถานการณ์เอลนีโญปีนี้ถูกประเมินว่ารุนแรงที่สุดในรอบ 140 ปี อ่างเก็บน้ำหลักของ EEC ทั้ง 16 แห่ง (ใหญ่ 4 + กลาง 12) มีน้ำรวมกันเพียง 534 ล้านลูกบาศก์เมตร หรือ 44% ของความจุกักเก็บ ขณะที่ความต้องการใช้น้ำทั้งปี 2570 ของพื้นที่ EEC คาดการณ์ที่ 2,888 ล้าน ลบ.ม. ช่องว่างนี้ไม่มีทางปิดด้วยการรอฝนเพียงอย่างเดียว Problem: เมื่อ "น้ำ" กลายเป็นความเสี่ยงด้านกำลังผลิต สำหรับโรงงานจำนวนมาก น้ำคือ input ที่ถูกประเมินต่ำเกินไปตลอดหลายสิบปี มันปรากฏในกระบวนการผลิตแทบทุกขั้น — ล้างชิ้นงาน หล่อเย็น boiler ระบบปรับอากาศ และคลังสินค้าควบคุมอุณหภูมิ เมื่อนโยบายส่วนกลางสั่งลดการใช้ 10-15% ภายในกรอบเวลาไม่กี่ปี โรงงานส่วนใหญ่เผชิญ 3 ปัญหาคลาสสิก: ไม่รู้ว่าน้ำหายไปตรงไหน — ไม่มี meter ย่อยรายจุด รู้แค่ยอดรวมจากใบแจ้งหนี้ประปาต้นเดือน ไม่รู้ baseline ต่อหน่วยผลิต — ไม่เคยคำนวณว่าผลิต 1 หน่วยใช้น้ำกี่ลิตร จึงตั้งเป้า "ลด 10%" ไม่ได้จริง น้ำเสียถูกมองเป็นต้นทุนกำจัด — ทั้งที่หลายกระบวนการ น้ำ used ยังผ่าน treatment กลับมาใช้ในงานที่ต้องการคุณภาพต่ำกว่าได้ Solution: Smart Water Loop ด้วย IIoT ใน 4 ขั้น กรณีศึกษาจากโครงการประหยัดน้ำในนิคมอุตสาหกรรมหลายแห่งชี้ว่า เส้นทางที่ได้ผลจริงมี 4 ขั้นตอนต่อเนื่องกัน: แผนภาพ: วงจร Smart Water Management 4 ขั้นตอนจากการวัดค่าจริงสู่การรายงาน ESG (ที่มา: Honey Corporation) ขั้นที่ 1: Measure — ติด meter ให้ครบก่อนคิดอะไรอื่น หัวใจคือการติด smart flow meter (แบบ ultrasonic…
Read More
Autonomous Factory ของโรงงานเซมิคอนดักเตอร์ Backend: ถอดบทเรียนจากโรงงานชิป Power Module มูลค่า 48,000 ล้านบาทที่เพิ่งเปิดในไทย

Autonomous Factory ของโรงงานเซมิคอนดักเตอร์ Backend: ถอดบทเรียนจากโรงงานชิป Power Module มูลค่า 48,000 ล้านบาทที่เพิ่งเปิดในไทย

Article
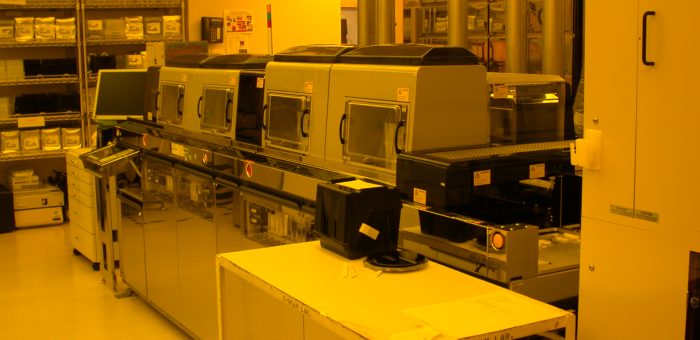
วันที่ 1 ตุลาคม 2569 ถือเป็นหมุดหมายสำคัญของอุตสาหกรรมการผลิตไทย — โรงงานผลิตเซมิคอนดักเตอร์ขั้นปลาย (Backend) แห่งใหม่มูลค่าการลงทุนกว่า 48,000 ล้านบาท ในจังหวัดสมุทรปราการเปิดตัวอย่างเป็นทางการ โดยมีนายกรัฐมนตรีเป็นประธานในพิธี นี่ไม่ใช่แค่ข่าวการลงทุนต่างชาติอีกหนึ่งชิ้น แต่คือ โรงงานอัตโนมัติ (Autonomous Factory) แห่งแรกของบริษัทเจ้าของโครงการที่รวมการทดสอบเวเฟอร์ (Wafer Testing) เข้ากับการประกอบโมดูลกำลัง (Power Module) และการทดสอบวงจรรวม (IC Final Test) ไว้ในสถานที่เดียวกัน บทความนี้ถอดรหัสว่า "Autonomous Factory" ในบริบท Backend Semiconductor หน้าตาเป็นอย่างไร ใช้เทคโนโลยีอะไรบ้าง และวิศวกรอุตสาหกรรมไทยจะเรียนอะไรได้จากโครงการระดับโลกที่มาตั้งอยู่ในประเทศเรา ความจำเพาะของโครงการที่ต้องรู้ก่อน ตัวเลขสำคัญของโครงการนี้อธิบายขนาดความทะเยอทะยานได้ดี: พื้นที่ห้องคลีนรูมเฟสแรก 30,000 ตารางเมตร ออกแบบให้ขยายได้สูงสุด 5 โมดูล รวม 150,000 ตร.ม. — มากกว่าโรงงานที่ใหญ่ที่สุดปัจจุบันของบริษัทราว 2 เท่า เป็นฐานผลิต Power Module แห่งที่ 3 ของโลก ต่อจากเยอรมนีและจีน และหากขยายครบทุกเฟส ไทยจะขึ้นเป็นฐาน Backend ที่ใหญ่ที่สุดในโลกของบริษัท ใช้พลังงานไฟฟ้าสีเขียว 100% พร้อมแผงโซลาร์เซลล์ ระบบหมุนเวียนน้ำ และระบบกักเก็บน้ำฝน คาดการณ์การจ้างงาน 5,000 ตำแหน่ง เมื่อครบทุกเฟส (ประมาณ 1,000 คนต่อเฟส) เน้นวิศวกรและช่างเทคนิค เงื่อไขถ่ายทอดเทคโนโลยี: พัฒนาบุคลากรไทยด้านวิทยาศาสตร์เทคโนโลยี 600 คน ส่งไปฝึกอบรมต่างประเทศ 130 คน ร่วมพัฒนาหลักสูตร 60 วิชา และวิจัยร่วม 680 โครงการ แผนภาพ: สถาปัตยกรรม Autonomous Backend Factory ที่รวม 3 กระบวนการหลักไว้ในโรงงานเดียว (ที่มา: Honey Corporation) ทำไม Backend ต้อง Autonomous มากกว่า Frontend? คนนอกวงการมักคิดว่าขั้นตอน Frontend (การผลิตเวเฟอร์) ซับซ้อนกว่า แต่ในมุมของวิศวกร Automation ขั้นตอน Backend กลับเป็นโจทย์ที่ท้าทายไม่แพ้กัน เพราะต้องจัดการกับ: ความหลากหลายของผลิตภัณฑ์ — โมดูลกำลังหนึ่งรุ่นอาจมี package หลายขนาด ทำให้ changeover บ่อยและต้องพึ่งระบบลำเลียงอัตโนมัติที่ยืดหยุ่น ความต้องการความสะอาดระดับสูงแต่ไม่สูงเท่า Frontend — โดยทั่วไปอยู่ในช่วง ISO…
Read More
Electron Beam Melting (EBM): เทคโนโลยีพิมพ์โลหะในสุญญากาศที่ Residual Stress ต่ำจนแทบไม่ต้อง Heat Treatment

Electron Beam Melting (EBM): เทคโนโลยีพิมพ์โลหะในสุญญากาศที่ Residual Stress ต่ำจนแทบไม่ต้อง Heat Treatment

Article
Electron Beam Melting (EBM) คือเทคโนโลยีพิมพ์โลหะแบบ Powder Bed Fusion ที่ใช้ "ลำอิเล็กตรอน" แทนเลเซอร์ในการหลอมผงโลหะทีละชั้น ภายใต้สภาวะสุญญากาศสูง ซึ่งเป็นความต่างเชิงกายภาพที่นำไปสู่ความต่างเชิงผลลัพธ์ที่สำคัญมาก เพราะลำอิเล็กตรอนเป็นอนุภาคมีประจุ จึงเบี่ยงเบนด้วยสนามแม่เหล็กได้เร็วหลายพันเฮิรตซ์ และส่งพลังงานได้สูงกว่าเลเซอร์หลายเท่าโดยไม่ต้องมีก๊าซเฉื่อย ทำให้กระบวนการทั้งหมดเกิดขึ้นในห้องสุญญากาศระดับ 10-4 torr ขึ้นไป จุดเด่นที่สุดของ EBM คืออุณหภูมิกระบวนการที่สูงกว่า LPBF อย่างมีนัยสำคัญ — ตัวเตามักถูก preheat และคงไว้ที่ระดับ 650–1,000°C ตลอดการพิมพ์ ผงวัสดุจึงถูกหลอมขณะที่เตียงพิมพ์ร้อนจัดอยู่แล้ว อุณหภูมิหลังการพิมพ์ (part temperature) กับอุณหภูมิหลอมจึงใกล้กันมาก gradient ทางความร้อนต่ำ residual stress จึงต่ำกว่า LPBF ที่พิมพ์บนเตียงเย็น เป็นเหตุผลที่งานวิจัยหลายชิ้นระบุว่า EBM มัก ไม่จำเป็นต้องทำ Heat Treatment ลดความเค้น (stress relief) หลังพิมพ์ หรือทำเพียงเบา ๆ ต่างจาก LPBF ที่แทบทุกชิ้นงานต้องผ่านขั้นตอนนี้เสมอ เครื่องพิมพ์โลหะระบบ Electron Beam Melting — ลำอิเล็กตรอนในห้องสุญญากาศทำหน้าที่หลอมผงโลหะทีละชั้น (ภาพ: Wikimedia Commons, CC BY 2.0) EBM vs LPBF: ตารางเปรียบเทียบเชิงเทคนิค ปัจจัย EBM (Electron Beam) LPBF (Laser Beam) แหล่งพลังงานลำอิเล็กตรอนในสุญญากาศเลเซอร์ไฟเบอร์ + ก๊าซเฉื่อย (Argon/Nitrogen) อุณหภูมิเตียงพิมพ์650–1,000°C (preheat สูง)100–200°C (บางรุ่นถึง 500°C) Residual Stressต่ำ — มักไม่ต้อง stress reliefสูง — ต้อง heat treatment แทบทุกชิ้น อัตราพิมพ์ (Build Rate)สูงกว่า — พลังงานและ scan speed สูงต่ำกว่า แต่ควบคุมพารามิเตอร์ละเอียดกว่า ความละเอียดพื้นผิวหยาบกว่า (Ra ~20–40 µm) ผงเม็ดใหญ่ 45–106 µmละเอียดกว่า (Ra ~5–15 µm) ผงเม็ดเล็ก 15–45 µm วัสดุที่นิยมTi-6Al-4V, CoCr, Inconel 718/625, ทองแดง, TiAlAlSi10Mg, 316L,…
Read More
Case Study: AR Indoor Navigation ในคลังสินค้า — เมื่อ BLE 5.1 AOA ตรงเข้าบินหาชั้นวางที่ 40 ซม. และลด Visual Search Time ด้วยลูกศรบนแว่น

Case Study: AR Indoor Navigation ในคลังสินค้า — เมื่อ BLE 5.1 AOA ตรงเข้าบินหาชั้นวางที่ 40 ซม. และลด Visual Search Time ด้วยลูกศรบนแว่น

Article
คลังสินค้าขนาดกลางแห่งหนึ่งของไทยมีปัญหาที่ฟังดูง่ายแต่แก้ยาก: พนักงานใหม่ใช้เวลา 3 สัปดาห์จึงจำตำแหน่ง SKU (Stock Keeping Unit) ได้ครบ และพนักงานที่จำได้ก็เผชิญปัญหาเมื่อมีการจัดเรียงสินค้าใหม่ (Slotting Optimization) ทำให้ "แผนที่ในหัว" ใช้ไม่ได้ทันที ผลลัพธ์คือ Pick Rate ตก และ Error Rate เพิ่ม กรณีศึกษาสังเคราะห์นี้ถอดบทเรียนจากงานวิจัยระบบตำแหน่งภายในอาคารระดับเซนติเมตรของมหาวิทยาลัยเทคโนโลยีพระจอมเกล้าธนบุรี (KMUTNB) ปี 2022 มาผสานกับแนวคิด Visual Search Theory และ AR Overlay เพื่อแสดงวิธีแก้ปัญหานี้อย่างเป็นระบบ คลังสินค้าชิ้นส่วนย่อยแบบอัตโนมัติ — สภาพแวดล้อมที่ตำแหน่งผิด 1 เมตรหมายถึงชั้นวางผิดทั้งแถว (ภาพ: Wikimedia Commons / Logi.cool, CC BY-SA 4.0) ปัญหา: Visual Search คือตัวกินเวลาที่ถูกมองข้าม ในงานคลังสินค้า เวลาของพนักงานแบ่งเป็นการเดิน การหา และการหยิบ มนุษย์หาสิ่งของด้วยกระบวนการที่จิตวิทยาการรับรู้เรียกว่า Visual Search — การสแกนสภาพแวดล้อมเพื่อหาเป้าหมายท่ามกลางสิ่งรบกวน (Distractors) งานวิจัยพบว่าถ้าเป้าหมายมีลักษณะเด่นจำเพาะ (เช่น สีเดียวที่ต่างจากทุกอย่างรอบตัว) การค้นหาจะเป็นแบบ "Pop-out" ที่เวลาไม่ขึ้นกับจำนวนสิ่งรบกวนเลย แต่ถ้าต้องจับคู่หลายลักษณะพร้อมกัน (Conjunction Search เช่น หากล่องสีน้ำเงินที่มีป้ายเหลือง) เวลาค้นหาจะเพิ่มขึ้นเชิงเส้นตามจำนวนสิ่งรบกวน นั่นคือเหตุผลที่ชั้นวางที่ดูเหมือนกันหมด 60 ช่อง ทำให้พนักงานใหม่หาของช้าอย่างเป็นระบบ ไม่ใช่เพราะขาดสมาธิ ทางออกที่ 1: ตำแหน่งที่แม่นระดับเซนติเมตรด้วย BLE 5.1 AOA ระบบนำทางในอาคารต้องการความแม่นยำสูงกว่า GPS ที่ให้ได้ 3–8 เมตร ตามงานวิจัยของ KMUTNB เทคโนโลยีดั้งเดิมอย่าง RSSI (Received Signal Strength Indicator) ของ Bluetooth ให้ความคลาดเคลื่อน 3–5 เมตร และ Wi-Fi คลาดเคลื่อนเกิน 5 เมตร — ไม่พอสำหรับการชี้ชั้นวาง แต่มาตรฐาน Bluetooth 5.1 Direction Finding ที่วัดมุมมาของสัญญาณ (Angle of Arrival: AOA) โดยใช้เสาอากาศแถว (Antenna Array) หลายตัวรับสัญญาณจาก Tag เดียว เปลี่ยนเกมไปเลย: ต้นแบบของงานวิจัยเดียวกันทำความคลาดเคลื่อนเฉลี่ยได้ 67.1 ซม.…
Read More
How-to: Expert Knowledge Capture ด้วย AR — 6 ขั้นตอนกู้ความรู้จากวิศวกรอาวุโสก่อนเกษียณ พร้อมเปลี่ยนเป็น Digital Work Instructions

How-to: Expert Knowledge Capture ด้วย AR — 6 ขั้นตอนกู้ความรู้จากวิศวกรอาวุโสก่อนเกษียณ พร้อมเปลี่ยนเป็น Digital Work Instructions

Article
โรงงานหลายแห่งในไทยกำลังเผชิญความเสี่ยงที่ไม่ปรากฏในงบการเงิน: วิศวกรอาวุโสที่ดูแลเครื่องจักรสายหลักมา 25 ปี กำลังจะเกษียณ และความรู้ที่อยู่ในหัวของเขา — วิธีฟังเสียงเบาล์วก่อนจะเสีย จุดไหนของไฮดรอลิกที่ต้องเช็คก่อนเสมอ หรือเคล็ดลับตั้งค่าเครื่องหลังเปลี่ยนรุ่นผลิต — จะหายไปพร้อมกัน เทคโนโลยี AR (Augmented Reality) ช่วยแก้ปัญหานี้ได้ด้วยแนวทางที่เรียกว่า Expert Knowledge Capture คือบันทึกความรู้ของผู้เชี่ยวชาญในรูปแบบที่ผูกกับตำแหน่งจริงบนเครื่องจักร (World-Anchored Annotations) แล้วแปลงเป็นคู่มือปฏิบัติงานดิจิทัลที่คนรุ่นใหม่เรียกดูได้บนแว่น AR เหมือนมีอาจารย์ยืนอยู่ข้างๆ ช่างเทคนิคใช้ AR ในงานบริการภาคสนาม — โหมดเดียวกับที่ใช้บันทึกความรู้ผู้เชี่ยวชาญแบบ See-What-I-See (ภาพ: Wikimedia Commons, CC BY-SA 4.0) ทำไมต้องเป็น AR ไม่ใช่วิดีโอธรรมดา คำถามแรกที่ผู้จัดการโรงงานมักถามคือ "ถ่ายวิดีโอไว้ดูก็ได้ ทำไมต้องลงทุน AR" คำตอบมีสามชั้น: บริบทเชิงพื้นที่: วิดีโอบันทึกภาพ 2 มิติที่ต้อง "เลื่อนหา" ว่าช่วงไหนพูดถึงชิ้นส่วนไหน ส่วน Annotation บน AR ผูกกับพิกัด 3 มิติบนเครื่องจักรจริง เมื่อช่างรุ่นใหม่สวมแว่นแล้วเดินไปหน้าเครื่อง คำอธิบายจะปรากฏตรงจุดที่ผูกไว้เสมอ แม้มุมมองจะเปลี่ยน Hands-free: งานซ่อมบำรุงต้องใช้มือสองข้าง การหยิบแท็บเล็ตมาเลื่อนดูวิดีโอทำลายสมาธิและเพิ่มความเสี่ยงปนเปื้อน ต่อยอดเป็นฐานข้อมูล: ความรู้ที่บันทึกแบบ AR เป็นข้อมูลมีโครงสร้าง (Object + ตำแหน่ง + คำอธิบาย + สื่อ) ที่สามารถเชื่อมกับ CMMS หรือระบบ MES ภายหลัง กลายเป็นเนื้อหาของ Digital Work Instructions อัตโนมัติ 6 ขั้นตอนบันทึกความรู้ ขั้นที่ 1: จัดลำดับความรู้ตามความเสี่ยง (Knowledge Audit) อย่าเริ่มจาก "อยากบันทึกทุกอย่าง" เพราะจะล้มเพราะขอบเขตกว้างเกินไป ให้ทำเมทริกซ์ 2 แกน: แกนนอนคือระดับความเสี่ยงถ้าความรู้หาย (หยุดสายการผลิต? กระทบความปลอดภัย?) แกนตั้งคือจำนวนคนที่รู้เรื่องนั้นอยู่ (Single Point of Knowledge) — เริ่มบันทึกจากช่อง "เสี่ยงสูง + คนรู้น้อย" ก่อนเสมอ ขั้นที่ 2: เตรียมพื้นที่และเครื่องจักร เลือกสภาพแวดล้อมที่แสงเพียงพอสำหรับ Marker-based หรือ Markerless Tracking (ใช้จุดเด่นของเครื่องจักรเป็น Landmark) หากพื้นผิวเป็นโลหะมันวาวหรือมีการเคลื่อนไหวของคนในพื้นที่ ต้องเผื่อเวลา Calibration เพิ่ม ควรบันทึกทีเดียวให้ครบทุกมุมของสถานีนั้น เพราะการกลับมาบันทึกซ้ำทำให้เกิด Anchor…
Read More
Eye Tracking ใน AR อุตสาหกรรม: จาก Gaze Analytics สู่ Foveated Rendering — Deep Dive จาก Pupil-Corneal Reflection ถึง Attention Data ของโรงงาน

Eye Tracking ใน AR อุตสาหกรรม: จาก Gaze Analytics สู่ Foveated Rendering — Deep Dive จาก Pupil-Corneal Reflection ถึง Attention Data ของโรงงาน

Article
เมื่อพูดถึง AR (Augmented Reality) ในโรงงาน คนส่วนใหญ่นึกถึงภาพ "แว่นสมาร์ทที่ฉายคู่มือประกอบลอยอยู่กลางอากาศ" แต่สำหรับวิศวกรที่ทำงานจริง คำถามที่สำคัญกว่านั้นคือ ระบบรู้ได้อย่างไรว่าคนงานกำลัง "มอง" อะไรอยู่ คำตอบของคำถามนี้คือ Eye Tracking หรือการติดตามการกวาดสายตา ซึ่งกำลังเปลี่ยนจากฟีเจอร์หรูในหูฟัง VR ระดับไฮเอนด์ มาเป็นเครื่องมือวัดผลและออกแบบงาน (Ergonomics และ Work Study) ที่โรงงานสามารถใช้ได้จริง แว่นตาอเนกประสงค์ที่ติดตั้งกล้องติดตามดวงตา (สังเกตโมดูลกล้องใกล้ขอบเลนส์) — ฮาร์ดแวร์พื้นฐานของระบบ Eye Tracking แบบสวมใส่ (ภาพ: Wikimedia Commons / Anatolich1, CC BY-SA 3.0) หลักการทำงาน: ตามนัยตาไม่ทันเห็น กล้องเห็นก่อน Eye Tracker รุ่นใหม่ใช้หลักการ Video-based Oculography — ส่องแสงอินฟราเรด (Near-IR) ความถี่ต่ำเข้าตา แล้วใช้กล้องความเร็วสูงจับภาพ ระบบจะคำนวณตำแหน่งจากจุดสองจุดหลัก คือ ศูนย์กลางม่านตา (Pupil Center) และ จุดสะท้อนบนกระจกตา (Corneal Reflection หรือ Purkinje Image) เมื่อหัวขยับหรือตาหมุน มุมระหว่างสองจุดนี้เปลี่ยน ระบบก็คำนวณทิศทางการมอง (Gaze Vector) ออกมาได้แบบเรียลไทม์ ความเร็วในการสุ่มตัวอย่าง (Sampling Rate) คือหัวใจของการเลือกใช้งาน ตามข้อมูลอ้างอิงทางวิชาการ ระบบทั่วไปใช้ 30 Hz เป็นขั้นต่ำ 50–60 Hz เป็นมาตรฐานที่พบบ่อย ส่วนงานวิจัยหรืองานที่ต้องวิเคราะห์การเคลื่อนไหวของตาอย่างละเอียด เช่น การวัด Saccade Dynamics ต้องใช้เครื่อง 240, 350 หรือแม้กระทั่ง 1000/1250 Hz การใช้งานในโรงงาน Sampling Rate ที่ต้องการ สิ่งที่วัดได้ Heat Map จุดสนใจบนแผงควบคุม30–60 HzFixation, Dwell Time Work Study ท่าทาง + สายตา60–120 HzScan Path, AOI Sequence ตรวจ Saccade ตอนสัญญาณเตือนดัง240 Hz ขึ้นไปSaccade Latency, Velocity สังเกตการณ์ละเอียดสำหรับ Human Factors Research1000–1250 HzMicro-saccade, Drift, Tremor Heat Map…
Read More
บทวิเคราะห์: Weibull Analysis — เปลี่ยนประวัติซ่อมที่นอนนิ่งใน CMMS ให้เป็นรอบเปลี่ยนอะไหล่ที่มีที่มา

บทวิเคราะห์: Weibull Analysis — เปลี่ยนประวัติซ่อมที่นอนนิ่งใน CMMS ให้เป็นรอบเปลี่ยนอะไหล่ที่มีที่มา

Article
โรงงานส่วนใหญ่ตั้งกำหนดเปลี่ยนอะไหล่จาก "ประสบการณ์" — หัวหน้าช่างบอกว่าปั๊มนี้ควรเปลี่ยนกระบอกสูบทุก 6 เดือน ก็ทำตามมาปีหนึ่ง โดยไม่มีใครเคยถามว่าตัวเลขนั้นมาจากไหน ผลคือโรงงานตกอยู่ใน 2 ขั้ว: เปลี่ยนเร็วเกินจำเป็น (เสียเวลาและอะไหล่) หรือ เปลี่ยนช้าเกินไป (เสียเครื่องจักรและการผลิต) มีเครื่องมือสถิติหนึ่งที่ตอบคำถามนี้ได้แบบมีหลักการ: การวิเคราะห์ Weibull บทความนี้เป็นบทวิเคราะห์ของ Honey Corporation ว่า Weibull Analysis ทำงานอย่างไร อ่านค่า β (Shape Parameter) อย่างไรให้เป็นภาษาบำรุงรักษา และทำไมเราถึงเห็นว่ามันคือทักษะที่ทีม reliability ของโรงงานไทยควรมีในปี 2026 รูปทรงของการแจกแจง Weibull เปลี่ยนไปตามค่า β — ค่าเดียวที่บอกธรรมชาติการพังของอุปกรณ์ทั้งชนิด "พังตอนเก่า" หรือ "พังสุ่มๆ" หรือ "พังตอนใหม่" (ภาพ: Wikimedia Commons) Weibull แก้ปัญหาอะไรในงานบำรุงรักษา ในความเป็นจริง การพังของอุปกรณ์ไม่ได้มาถึงวันครบกำหนดแบบนาฬิกา — มันกระจายตัวเป็นการแจกแจงความน่าจะเป็น Weibull Distribution คือโมเดลสถิติที่อธิบายการกระจาย "เวลาถึงความล้มเหลว" (time-to-failure) ได้แม่นที่สุดรูปแบบหนึ่งในงานวิศวกรรมความน่าเชื่อถือ ด้วยพารามิเตอร์เพียง 2 ตัว: β (Shape Parameter) — บอก "รูปแบบการพัง" ของอุปกรณ์ η (Scale Parameter / Characteristic Life) — บอก "ช่วงอายุที่ 63.2% ของอุปกรณ์พังแล้ว" เมื่อเอาข้อมูลอายุการใช้งานจริงของอุปกรณ์กลุ่มเดียวกัน (จาก CMMS หรือประวัติซ่อม) มา plot บนกระดาษ Weibull probability plot แล้วประมาณค่า β กับ η ทีมบำรุงรักษาจะสามารถตอบคำถามเชิงลึกได้ 3 ข้อ: (1) อุปกรณ์นี้พังแบบสุ่มหรือพังเพราะมานุษย์ของอายุ (2) ควรตั้งรอบเปลี่ยนวันที่เท่าไหร่จึงจะคุมความเสี่ยงได้ (3) ถ้าเป็นการพังแบบสุ่ม การตั้งรอบเปลี่ยนเชิงป้องกันไม่มีประโยชน์เลย — ต้องเปลี่ยนไปใช้การเฝ้าสภาพแทน อ่านค่า β ให้เป็นภาษาบำรุงรักษา ค่า β คือคำทำนายธรรมชาติของความล้มเหลว ตีความได้ตรงๆ แบบนี้: ค่า β ธรรมชาติการพัง นัยต่อกลยุทธ์บำรุงรักษา β < 1พังตอนอายุน้อย (infant mortality) — อัตราการพังลดลงเรื่อยๆ ตามอายุปัญหาอยู่ที่การติดตั้ง/คุณภาพการผลิต/คัดกรอง ไม่ใช่อายุ —…
Read More
Case Study: DGA และ Duval Triangle ชี้ขาดสุขภาพหม้อแปลง 115/22 kV — จากก๊าซในน้ำมันสู่แผนซ่อมที่ตรงจุด

Case Study: DGA และ Duval Triangle ชี้ขาดสุขภาพหม้อแปลง 115/22 kV — จากก๊าซในน้ำมันสู่แผนซ่อมที่ตรงจุด

Article
หม้อแปลงกำลัง (Power Transformer) คืออุปกรณ์ที่แพงที่สุดชิ้นหนึ่งในสถานีรับไฟของโรงงาน และเป็นชิ้นเดียวที่เมื่อพัง มักพังแบบ "ไม่มี spare รออยู่" คำถามคลาสสิกของทีมไฟฟ้าโรงงานจึงเป็นเสมอ: "หม้อแปลงตัวนี้ยังอยู่ได้อีกนานแค่ไหน หรือควรเตรียมแผนเปลี่ยนแล้ว?" — เครื่องมือที่ตอบคำถามนี้ได้ดีที่สุดในโลกวิศวกรรมไฟฟ้า คือ DGA หรือ Dissolved Gas Analysis การตรวจวิเคราะห์ก๊าซที่ละลายในน้ำมันหม้อแปลง บทความนี้เล่าแบบ case study จริงจากงานวิจัยที่ตีพิมพ์ในวารสารวิชาการเทคโนโลยีอุตสาหกรรม มจพ.เหนือ ที่ใช้ผลตรวจน้ำมันหม้อแปลง 115/22 kV ขนาด 50 MVA ของการไฟฟ้าส่วนภูมิภาค มาวิเคราะห์ด้วยวิธี Duval Triangle เพื่อชี้ขาดสภาพความผิดปกติในห้อง OLTC (On-Load Tap Changer) — พร้อมถอดบทเรียนว่าโรงงานอุตสาหกรรมจะนำแนวทางเดียวกันไปใช้อย่างไร หม้อแปลงกำลังแรงสูง — หนึ่งในสินทรัพย์ที่มีมูลค่าสูงที่สุดของโรงงาน และต้องการเครื่องมือตรวจสุขภาพที่แม่นยำกว่าการมองภายนอก (ภาพ: Wikimedia Commons) หลักการ: หม้อแปลง "บอกความจริง" ผ่านก๊าซที่มันผลิต ฉนวนน้ำมันแร่ในหม้อแปลงมีปฏิกิริยาตอบสนองต่อความร้อนและประกายไฟแบบมีตรรกะสูง — เมื่อเกิดความผิดปกติเช่นความร้อนสูงเฉพาะจุด (thermal fault) หรืออาร์คไฟฟ้า โมเลกุลของน้ำมันและกระดาษฉนวนจะแตกตัวและปล่อยก๊าซเจาะจงชนิดออกมา ก๊าซเหล่านี้ละลายอยู่ในน้ำมันและเก็บตัวอยู่เงียบๆ จนเราดึงตัวอย่างไปตรวจ เหมือนการตรวจเลือดที่เผยโรคภายในของคน สัญลักษณ์สำคัญที่วิศวกรต้องจำให้ขึ้นใจ: ก๊าซ ต้นกำเนิด ชี้ว่าอะไรเมื่อค่าสูง Hydrogen (H₂)การแตกตัวของน้ำในน้ำมัน / coronaPartial Discharge หรือความร้อนต่ำ Methane (CH₄)การแตกตัวของน้ำมันที่อุณหภูมิปานกลางThermal fault ในน้ำมือ 150–300°C Ethylene (C₂H₄)การแตกตัวที่อุณหภูมิสูงมากThermal fault รุนแรง >300°C เช่น จุดเชื่อมหลวม Acetylene (C₂H₂)เกิดจากอาร์คไฟฟ้าเท่านั้น (อุณหภูมิ >700°C)Arcing — สัญญาณอันตรายระดับต้องทำการทันที CO และ CO₂การสลายตัวของกระดาษฉนวนเซลลูโลสฉนวนกระดาษเสื่อม — ความเสียหายที่ย้อนกลับไม่ได้ Case Study: พิสูจน์สภาพ OLTC หม้อแปลง 115/22 kV ด้วย Duval Triangle สถานการณ์: งานวิจัยของมจพ.เหนือ (วารสารวิชาการเทคโนโลยีอุตสาหกรรม ปีที่ 9 ฉบับที่ 2) นำประวัติผลตรวจน้ำมันในห้อง OLTC ของหม้อแปลง 115/22 kV 50 MVA หลายตัวมาวิเคราะห์ โดยโจทย์คือ OLTC เป็นอุปกรณ์กลไกที่สับเปลี่ยนแท็ปภายใต้โหลดทุกวัน จึงสึกหรอเร็วและตรวจสภาพยาก วิธีทำ: ทีมวิจัยนำค่าก๊าซหลัก 3 ตัว…
Read More
How-to: ตั้งศูนย์เพลาด้วยเลเซอร์ 6 ขั้นตอน — กำจัด Misalignment ต้นตอแบริ่งพังซ้ำๆ ที่เปลี่ยนกี่ครั้งก็ไม่หาย

How-to: ตั้งศูนย์เพลาด้วยเลเซอร์ 6 ขั้นตอน — กำจัด Misalignment ต้นตอแบริ่งพังซ้ำๆ ที่เปลี่ยนกี่ครั้งก็ไม่หาย

Article
ในโลกของการบำรุงรักษาเชิงคาดการณ์ ทุกคนพูดถึงเซ็นเซอร์ AI และโมเดลทำนาย แต่มีต้นตอความเสียหายราคาแพงชนิดหนึ่งที่แก้ได้ด้วยเครื่องมือกล้องเลเซอร์ชิ้นเดียวภายในครึ่งวัน: ความคลาดเคลื่อนของศูนย์เพลา (Shaft Misalignment) สถิติสากลด้าน reliability ชี้ตรงกันมาหลายทศวรรษว่า ความคลาดเคลื่อนของศูนย์เพลาคือสาเหตุอันดับต้นของการเสียหายของแบริ่ง ซีล และคู่มือเพลา โดยเฉพาะเครื่องจักรหมุนที่เดินความเร็วสูง บทความนี้เป็นคู่มือแบบ How-to จาก Honey Corporation — อธิบายชนิดของ misalignment, ค่า tolerance ที่ยอมรับได้ตามความเร็วรอบ, และขั้นตอนตั้งศูนย์ด้วยเลเซอร์ 6 ขั้น ที่ทีมช่างของโรงงานทำตามได้จริงตั้งแต่ครั้งแรก คู่มือเพลา (Coupling) เชื่อมมอเตอร์กับชิ้นงาน — จุดเดียวที่ความคลาดเคลื่อนเพียงไม่กี่สิบไมโครเมตรจะถูกขยายเป็นแรงกระแทกนับล้านครั้งต่อชั่วโมง (ภาพ: Wikimedia Commons) Parallel vs Angular: เข้าใจศัตรู 2 แบบก่อนลงมือ Misalignment มี 2 แบบพื้นฐานที่มักเกิดร่วมกัน: Parallel (Offset) Misalignment — ศูนย์เพลาสองข้างขนานกันแต่ไม่อยู่แนวเดียวกัน เหมือนเส้นรถไฟสองสายที่เยื้องกัน ทำให้ coupling หมุนโค้งตลอดรอบ สร้างแรงสั่นความถี่สูงเป็น 2 เท่าของรอบเครื่อง (2×RPM) Angular (Gap) Misalignment — ศูนย์เพลาทำมุมต่อกัน เหมือนบันไดสองขั้นที่ลาดไม่เท่ากัน ทำให้ coupling บิดไป-กลับทุกรอบหมุน สร้างแรง axial vibration ที่ความถี่ 1×RPM และ 2×RPM ผสมกัน ในสนามจริงเกือบทุกกรณีคือแบบผสม — มีทั้ง offset และ angular ซ่อนอยู่ในหลายระนาบ ซึ่งเป็นเหตุผลที่การตั้งศูนย์ด้วยสายเทปหรือน้ำมันตรวจสอบขั้นพื้นฐานไม่เพียงพออีกต่อไปสำหรับเครื่องจักรสมัยใหม่ ตาราง Tolerance: ตัวเลขที่ต้องจำก่อนเปิดกล่องเครื่องมือ หลักการสำคัญ: ยิ่งเครื่องหมุนเร็ว ยิ่งต้องแม่น — ความคลาดเคลื่อนที่โรงงานจำนวนมากใช้กันจนชินคือค่าที่เขียนตามอกเขามาโดยไม่ได้คิด ตารางอ้างอิงที่ใช้กันทั่วไปในวงการตั้งศูนย์เลเซอร์ (ตามแนวทางมาตรฐานสากล เช่น แนวค่าที่ใช้กันในอุตสาหกรรมตามความเร็วรอบเครื่องจักร) มีหน้าตาแบบนี้: ความเร็วเครื่อง (RPM) Offset ที่ยอมรับ (mm) Angularity ที่ยอมรับ (mm/100mm) ผลกระทบถ้าเกิน 6000.200.20แบริ่งอายุสั้นลงเล็กน้อย เสียงดังขึ้น 1,8000.100.10แบริ่งร้อน น้ำมันรั่วที่ซีล เสียง 2×RPM ชัด 3,6000.050.05แบริ่งพังก่อนอายุมาก คู่มือเพลาสึก พลังงานสูญเปล่า แบริ่งความเร็วสูง / กังหัน0.02–0.030.02ความเสียหายรวดเร็ว อาจพังภายในหลักสิบชั่วโมง หมายเหตุ: ค่าข้างต้นเป็นค่าอ้างอิงทั่วไป — ผู้ผลิต coupling แต่ละรายและผู้ผลิตเครื่องจักรอาจกำหนดค่าเฉพาะที่เข้มงวดกว่านี้ ให้ยึดตามเอกสารของอุปกรณ์จริงเสมอ How-to:…
Read More
บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

บทวิเคราะห์: Digital Twin กับปัญหา Model Drift — เมื่อโมเดล PdM เริ่มเพี้ยน Fleet Learning จะช่วยได้จริงหรือไม่

Article
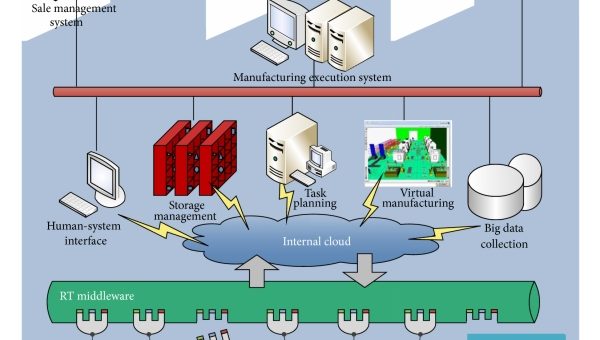
โมเดล AI ทำนายความเสียหายของเครื่องจักร (Predictive Maintenance) ตัวหนึ่งในโรงงานสิ่งทอทำงานได้แม่นยำมากในปีแรก แต่ปีที่สองความแม่นยำเริ่มถดลง เพราะสภาพเครื่องจักรเปลี่ยน โหลดการผลิตเปลี่ยน และพฤติกรรม "ปกติ" ของเครื่องจักรเลื่อนไปจากเดิม นี่คือปัญหา Model Drift ที่ทุกโรงงานต้องเจอ และเป็นคำถามเปิดของวงการว่า Digital Twin จะช่วยแก้ได้จริงหรือไม่ บทวิเคราะห์นี้มองปัญหาจากมุมวิศวกรรม ไม่ใช่มุมการตลาด ปัญหา Model Drift ในโรงงาน: ทำไมโมเดลเก่าเร็วจนน่าใจหาย โมเดล Anomaly Detection ส่วนใหญ่เรียนรู้จากข้อมูลในอดีต แล้วตั้งสมมติฐานว่าอนาคตจะคล้ายอดีต แต่ในโรงงานจริง ไม่มีอะไรนิ่ง: ชิ้นส่วนสึกหรอ, สูตรผลิตเปลี่ยน, ผู้ปฏิบัติงานเปลี่ยนวิธีเดินเครื่อง, อุณหภูมิแวดล้อมตามฤดูกาล หรือแม้แต่การซ่อมบำรุงที่ "ปรับ" พฤติกรรมเครื่องจักรไปโดยสิ้นเชิง ผลคือเกิดการแจ้งเตือนเท็จ (False Alarm) เพิ่มขึ้นเรื่อยๆ จนทีมซ่อมบำรุงเริ่มกด "Dismiss" โดยไม่อ่าน — และวันหนึ่ง Alarm จริงก็ถูกกดไปพร้อมกับพวกเท็จ แนวทางแก้แบบดั้งเดิมคือ การเทรนซ้ำ (Retraining) ด้วยข้อมูลใหม่ แต่คำถามคือใครจะ Label ข้อมูลว่าอะไรคือ "ปกติ" ในสถานการณ์ใหม่ และต้องรอนานแค่ไหนจึงจะมีข้อมูลเพียงพอ เพราะความเสียหายจริงเกิดไม่บ่อยนัก แนวคิดใหม่: Fleet Learning ผ่าน Digital Twin แนวคิดที่กำลังได้รับความสนใจคือการใช้ Digital Twin เป็น "ผู้เรียนรู้ร่วมกัน" ของกลุ่มเครื่องจักรลักษณะเดียวกัน แทนที่จะปล่อยให้แต่ละเครื่องเรียนรู้ลำพัง: สถาปัตยกรรม Smart Factory ยุคใหม่เชื่อมทุกชั้นข้อมูลเข้าด้วยกัน — Fleet Learning เป็นการขยายแนวคิดนี้สู่กลุ่มเครื่องจักรข้ามไซต์ (ภาพ: Wikimedia Commons, CC BY 4.0) หลักการคือ เมื่อเครื่องจักร A ในไซต์ 1 เจอ Failure Mode ใหม่และถูกบันทึกไว้ใน Twin ของมัน ความรู้นั้นสามารถถ่ายทอด (Transfer) ไปยังโมเดลของเครื่องจักร B, C, D ที่อยู่คนละไซต์แต่มีลักษณะเดียวกันได้ทันที เครื่องจักรอื่นๆ จึง "รู้" ล่วงหน้าโดยไม่ต้องเจอเองก่อน นี่คือความต่างสำคัญจากการเทรนโมเดลแบบเก่าที่ต้องรอเครื่องเสียจริงทีละตัวเพื่อสะสมประสบการณ์ วิเคราะห์กลไกทางเทคนิค: Twin ช่วยแก้ Drift ได้อย่างไร กลไก วิธีการทำงาน ข้อดี ข้อจำกัดที่ต้องยอมรับ Simulation Augmentationใช้ Twin จำลองสถานการณ์ที่ยังไม่เคยเกิดจริง สร้างข้อมูล Synthetic สำหรับเทรนโมเดลได้ข้อมูล Failure…
Read More