Vibration Analysis: อ่านลายเซ็นความถี่จากเครื่องจักรก่อนที่มันจะพัง — Deep Dive จาก FFT ถึง ISO 20816

Vibration Analysis: อ่านลายเซ็นความถี่จากเครื่องจักรก่อนที่มันจะพัง — Deep Dive จาก FFT ถึง ISO 20816

Article
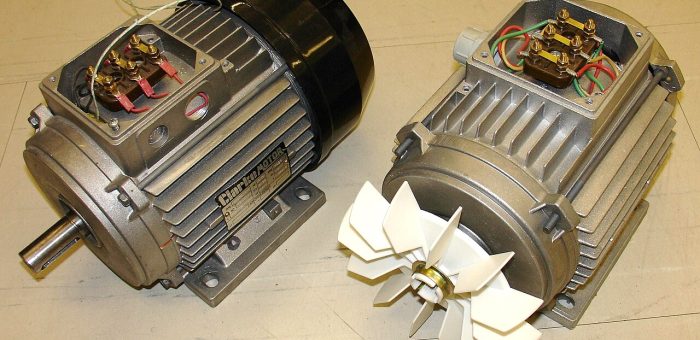
ทำไม "เสียงเครื่องจักร" จึงโกหกคุณได้ แต่ "ค่าการสั่นสะเทือน" โกหกไม่ได้ ช่างเทคนิคที่เก่งที่สุดในโรงงานมักบอกได้ว่าเครื่องจักรกำลังจะพัง "จากเสียง" — แต่หูมนุษย์มีข้อจำกัดสองข้อที่ยอมรับกันในวงวิศวกรรมเครื่องกล ข้อแรกคือหูคนได้ยินตั้งแต่ 20 Hz ถึงราว 20,000 Hz ในขณะที่สัญญาณบ่งชี้ความเสียหายระยะแรกของลูกสูบมักเกิดที่ความถี่ต่ำกว่านั้น ข้อสองคือสมองมนุษย์ "ชิน" กับเสียงที่เพิ่มขึ้นอย่างค่อยเป็นค่อยไปในแต่ละวัน จนกระทั่งวันหนึ่งเครื่องหยุดกลางคัน Vibration Analysis คือการเปลี่ยนสัญญาณการสั่นสะเทือนให้กลายเป็นตัวเลขที่วัดได้ ตรวจสอบซ้ำได้ และเปรียบเทียบข้ามเวลาได้ ด้วยหลักการง่ายๆ ว่า ทุกความผิดปกติเชิงกล มีลายเซ็นความถี่เป็นของตัวเอง ลูกสูบ (Rolling Element Bearing) — แหล่งกำเนิดความถี่บกพร่องที่นำไปคำนวณเป็น BPFO, BPFI, BSF และ FTF ได้ | ภาพ: public domain หลักการ 4 ขั้น: จากคลื่นสั่นสะเทือนสู่การวินิจฉัย ขั้นตอนการวิเคราะห์มาตรฐานในอุตสาหกรรมคือ (1) เก็บสัญญาณด้วยเซ็นเซอร์วัดความเร่ง (Accelerometer) ที่ติดตั้งบนตัวเครื่องจักรใกล้จุดรับน้ำหนัก (2) แปลงสัญญาณแรงดันไฟฟ้าให้เป็นหน่วยความเร่ง g ผ่านตัวเก็บประจุภายในเซ็นเซอร์แบบ Piezoelectric (3) นำข้อมูลดิบผ่านการแปลงฟูเรียร์ (FFT) เพื่อแยกสัญญาณออกเป็นแต่ละความถี่ และ (4) ตีความความถี่ที่โดดออกมาเทียบกับความถี่บกพร่องทางทฤษฎีของเครื่องจักร เซ็นเซอร์ 100 mV/g เป็นสเปกที่พบมากที่สุดในโรงงานอุตสาหกรรม ส่วนความถี่ในการเก็บข้อมูล (Sampling Rate) ต้องเป็นอย่างน้อย 2.56 เท่าของความถี่สูงสุดที่สนใจตามทฤษฎีบทของไนควิสต์ เช่น ต้องการวิเคราะห์ถึง 10 kHz ต้องเก็บข้อมูลที่ 25.6 kHz การติดตั้งเซ็นเซอร์วัดค่าที่จุดสำคัญ ตำแหน่งและวิธีติดตั้ง (แม่เหล็ก/สติ๊ก/ยึดสกรู) มีผลต่อความถี่สูงสุดที่วัดได้จริง | ภาพ: NASA, public domain ตารางลายเซ็นความถี่: อ่านตัวโรคเครื่องจักรให้เป็น ความถี่ที่พบ สาเหตุที่พบบ่อย สิ่งที่ควรตรวจสอบต่อ 1×RPMความไม่สมดุล (Unbalance)น้ำหนักเพิ่มจากเศษวัสดุหรือฝุ่นเป็นก้อนบนใบพัด หรือโรเตอร์โค้งงอ โดยเฟสของสัญญาณจะนิ่งไม่เปลี่ยน 2×RPMเพลาไม่ได้แนว (Misalignment)ตรวจการจัดแนวเพลาด้วยเลเซอร์ ทั้งแนวออฟเซ็ตและแนวมุม BPFO / BPFIลูกสูบเสียหาย (แหวนนอก/ใน)โดยเฉพาะเมื่อมี Sideband ของ FTF ปรากฏร่วมด้วย หมายถึงการสึกหรอลุกลาม ราว 0.42–0.48×RPMฟิล์มน้ำมันไม่เสถียร (Oil Whirl)ตรวจระดับความหนืดน้ำมัน แรงดันน้ำมันหล่อลื่น และ Load ของ Sleeve Bearing — มักพบในเครื่องจักรความเร็วสูง ความถี่ลูกผสม (Line Frequency ×…
Read More
Human Digital Twin: เมื่อสิ่งที่ถูกลืมมากที่สุดในโรงงานอัจฉริยะคือ “คน” — บทวิเคราะห์แนวคิดและโอกาสปี 2026

Human Digital Twin: เมื่อสิ่งที่ถูกลืมมากที่สุดในโรงงานอัจฉริยะคือ “คน” — บทวิเคราะห์แนวคิดและโอกาสปี 2026

Article
เมื่อพูดถึง Digital Twin ในโรงงาน ภาพที่ผุดขึ้นมาเกือบทุกครั้งคือเครื่องจักร ท่อ และสายพานที่ถูกจำลองเป็นโมเดลสามมิติเรืองแสง แต่มี "อะไรบางอย่าง" ที่เดินไปมาท่ามกลางเครื่องจักรเหล่านั้นทุกวัน ทำงาน 8-12 ชั่วโมงต่อวัน ปรับตัวตามคำสั่งผลิตที่เปลี่ยนทุกชั่วโมง — แต่แทบไม่เคยถูกจำลอง นั่นคือ คนงาน Human Digital Twin (HDT) คือแนวคิดการสร้างตัวแบบดิจิทัลของมนุษย์ในระบบการผลิต — ไม่ใช่แค่หุ่นยนต์เสมือนใน software จำลอง แต่คือการผูกข้อมูลการเคลื่อนไหว ท่าทาง ภาระงาน และบางกรณีถึงสัญญาณชีวภาพ เข้ากับโมเดลที่ใช้วิเคราะห์ ทำนาย และออกแบบงานให้กับคนได้ดีขึ้น ในห้วงที่อุตสาหกรรมทั่วโลกกำลังเผชิญภาวะแรงงานขาดแคลนและอัตราการลาออกสูง แนวคิดนี้กำลังขยับจากงานวิจัยสู่หน้างานจริง ทำไมต้องจำลองคน — เมื่อปัญหาของโรงงานคือคน ไม่ใช่เครื่องจักร เครื่องจักรมี datasheet บอกขีดจำกัดชัดเจน แต่คนไม่มี โรงงานส่วนใหญ่รู้ว่าเครื่อง CNC ตัวไหนทำงานได้กี่ชั่วโมงก่อนพัง แต่ไม่รู้ว่าคนงานคนไหนกำลังยกของเกินหลักการยศาสตร์ (ergonomics) มาก่อนจะบาดเจ็บ องค์กรเออร์โกโนมิกส์นานาชาติ (IEA) แบ่งสาขาวิชานี้ออกเป็น 3 ด้าน ซึ่งเป็นโครงของ HDT เช่นกัน: Physical Ergonomics — ท่าทางการทำงาน การยกของ การเคลื่อนไหวซ้ำๆ ซึ่งเป็นต้นเหตุอาการบาดเจ็บสะสม (MSD — Musculoskeletal Disorders) อันดับต้นของโรงงาน Cognitive Ergonomics — ภาระทางการรู้คิด ความเหนื่อยล้าทางสมอง การตัดสินใจภายใต้ความกดดัน ซึ่งสัมพันธ์กับข้อผิดพลาดในการปฏิบัติงาน Organizational Ergonomics — การออกแบบกะการทำงาน โครงสร้างทีม และการสื่อสาร ที่ส่งผลต่อทั้งประสิทธิภาพและความปลอดภัย Motion Capture — หนึ่งในเทคโนโลยีหลักที่ใช้เก็บข้อมูลการเคลื่อนไหวของคนเพื่อสร้าง Human Digital Twin (ภาพ: Wikimedia Commons, CC BY 2.0) Human Digital Twin ต่างจากการประเมินยศาสตร์แบบเดิมอย่างไร การประเมินยศาสตร์แบบดั้งเดิม เช่น การสังเกตการทำงานด้วยตาแล้วให้คะแนนความเสี่ยง เป็นการวัด "ชั่วขณะหนึ่ง" — วิศวกรมาสังเกต 30 นาที แล้วสรุปทั้งกะ HDT เปลี่ยนวิธีนี้สามชั้น: มิติ การประเมินแบบเดิม Human Digital Twin การเก็บข้อมูล สังเกตด้วยตา ถ่ายวิดีโอ แบบสอบถาม Motion capture, เซ็นเซอร์สวมใส่, กล้อง AI posture ต่อเนื่อง ช่วงเวลา…
Read More
Reality Capture สำหรับ Digital Twin: จาก LiDAR และ Point Cloud สู่โมเดลโรงงานที่ตรงความจริง (Scan-to-Twin)

Reality Capture สำหรับ Digital Twin: จาก LiDAR และ Point Cloud สู่โมเดลโรงงานที่ตรงความจริง (Scan-to-Twin)

Article
คำถามที่ทีมวิศวกรรมได้ยินบ่อยที่สุดเมื่อเริ่มโครงการ Digital Twin ของโรงงานเก่าคือ "แผ่น CAD ที่มีอยู่ ใช้ได้เลยไหม?" คำตอบในทางปฏิบัติแทบทุกครั้งคือ — ไม่ได้ หรือไม่แม่นพอ โรงงานที่อายุ 10-20 ปีผ่านการปรับปรุงเปลี่ยนแปลงมานับสิบรอบ ทั้งย้ายเครื่องจักร เพิ่มท่อ เปลี่ยนเลย์เอาต์ แต่แฟ้ม CAD ยังค้างอยู่ที่ฉบับวันเปิดโรงงาน ผลคือ "โมเดลที่สวยแต่โกหก" Reality Capture คือกระบวนการจับข้อมูลโลกจริงมาเป็นโมเดลดิจิทัล — ด้วยการสแกนด้วยเลเซอร์ (LiDAR) หรือการถ่ายภาพหลายมุมเพื่อคำนวณเป็นโมเดลสามมิติ (Photogrammetry) ผลลัพธ์ที่ได้เรียกว่า Point Cloud ซึ่งจะกลายเป็นรากฐานที่แท้จริงของ Digital Twin ที่สะท้อนโรงงาน "ตามที่มันเป็น" (as-built) ไม่ใช่ "ตามที่แบบบอก" กระบวนการทั้งหมดนี้เรียกอีกชื่อหนึ่งว่า Scan-to-Twin ทำความรู้จักเครื่องมือก่อน: LiDAR ทำงานอย่างไร LiDAR (Light Detection and Ranging) ทำงานโดยยิงลำแสงเลเซอร์ไปยังวัตถุแล้ววัดเวลาที่แสงสะท้อนกลับมายังตัวรับ จากนั้นคำนวณระยะทางจากความเร็วแสง เมื่อยิงซ้ำนับล้านครั้งต่อวินาทีพร้อมหมุนสแกนไปทั่วพื้นที่ เครื่องจะได้จุดพิกัดสามมิติจำนวนมหาศาลที่ประกอบกันเป็น "เมฆจุด" ของสภาพแวดล้อมจริง รายละเอียดนั้นสูงมากจนสามารถนำไปใช้วัดขนาดจริงได้ หัวสแกน LiDAR แบบหมุน — ยิงลำเลเซอร์นับล้านครั้งต่อวินาทีแล้ววัดเวลาที่แสงสะท้อนกลับ เพื่อระบุพิกัดสามมิติของทุกจุดในพื้นที่ (ภาพ: Wikimedia Commons, CC BY 2.0) How-to: 6 ขั้นตอนจากโรงงานจริงสู่ Digital Twin ขั้นที่ 1 — สำรวจหน้างานและวางแผนตำแหน่งสแกน (Scan Plan) เดินสำรวจพื้นที่ก่อนเสมอ ระบุอุปสรรคแสง (แสงจ้าจากประตูโรงงาน พื้นสะท้อนแสง ผิวโลหะมันวาว) แล้วกำหนดจุดตั้งกล้องให้ทุกมุมมีความซ้อนทับกันอย่างน้อย 30% ระหว่างสแกนแต่ละจุด หากใช้แบบ Handheld SLAM Scanner จะยืดหยุ่นกว่าสำหรับพื้นที่แคบ เช่น ช่องท่อใต้ผิวดินหรือบริเวณท่อร้อย ขั้นที่ 2 — ลงสแกนในหน้างาน สแกนแต่ละจุดใช้เวลาไม่กี่นาที โรงงานขนาดกลางอาจต้องลงสแกนหลายสิบถึงหลายร้อยจุด สิ่งสำคัญคือควบคุมคนเดินผ่านให้น้อยที่สุดระหว่างสแกน เพราะ "คน" จะกลายเป็น noise ใน point cloud ด้วยเหตุผลเดียวกัน ควรสื่อสารกับฝ่ายผลิตล่วงหน้าเพื่อจองช่วงเวลา เช่น วันหยุดปฏิบัติการหรือช่วงเปลี่ยนกะ ขั้นที่ 3 — รวมจุดสแกน (Registration) ไฟล์สแกนแต่ละจุดคือ "ภาพตัด" ของพื้นที่ ต้องนำมาเชื่อมกันเป็นแผนที่เดียว กระบวนการนี้เรียกว่า Point Set Registration โดยอัลกอริทึมที่ใช้แพร่หลายคือ ICP…
Read More
บทวิเคราะห์ GitOps สำหรับ Edge Fleet ของโรงงานหลายไซต์: จัดการ Configuration Drift ตามหลักการ OpenGitOps 4 ข้อ

บทวิเคราะห์ GitOps สำหรับ Edge Fleet ของโรงงานหลายไซต์: จัดการ Configuration Drift ตามหลักการ OpenGitOps 4 ข้อ

Article
คำถามที่ทุกโรงงานหลายไซต์เจอ: เซิร์ฟเวอร์ Edge 30 เครื่อง เหมือนกันจริงหรือไม่ เมื่อระบบ IIoT ขยายจาก pilot หนึ่งไซต์ไปสู่หลายโรงงาน คำถามที่ตามมาเสมอคือ เราจะมั่นใจได้อย่างไรว่าเซิร์ฟเวอร์ Edge ทุกเครื่องทั่วประเทศรันโค้ดเวอร์ชันเดียวกัน ใช้ค่า config เดียวกัน และติดตั้ง security patch ระดับเดียวกัน ประสบการณ์เดิมของหลายองค์กรคือการ ssh เข้าไปแก้ทีละเครื่อง ซึ่งใช้ได้กับ 3 เครื่อง แต่ไม่ใช่กับ 30 หรือ 300 เครื่อง คำตอบจากโลก software ที่กำลังไหลเข้าสู่โลกโรงงานคือ GitOps ซึ่ง OpenGitOps Working Group แห่ง CNCF ให้นิยามผ่านหลักการ 4 ข้อเวอร์ชัน 1.0.0 ได้แก่ Declarative (สถานะที่ต้องการต้องอธิบายแบบประกาศผล), Versioned and Immutable (เก็บประวัติทุกการเปลี่ยนแปลงแบบย้อนหลังได้), Pulled Automatically (agent ดึงสถานะจาก source เองโดยอัตโนมัติ) และ Continuously Reconciled (agent เฝ้าเทียบสถานะจริงกับที่ต้องการตลอดเวลา แล้วแก้กลับเมื่อพบความคลาดเคลื่อน) GitOps มักถูก implement คู่กับ lightweight Kubernetes บน edge node ของโรงงาน (ภาพ: Honey Corporation) Configuration Drift คือศัตรูที่แท้จริง ปัญหาไม่ใช่การติดตั้งครั้งแรก แต่คือ drift ที่สะสมทีละนิด เวอร์ชันโค้ดต่างกันหนึ่ง release, config ที่วิศวกรแก้ชั่วคราวตอนดึกเพื่อดับไฟปัญหา production แล้วลืมกลับมาเก็บ, patch ที่ติดตั้งบางเครื่องแต่ไม่ติดบางเครื่อง เมื่อเวลาผ่านไปหกเดือน ไม่มีใครกล้ายืนยันว่าทุกเครื่องเหมือนกันจริง และนี่คือจุดกำเนิดของปัญหา "ในเครื่องทดสอบทำงานได้ แต่ใน production ไม่ได้" รวมถึงช่องโหว่ความปลอดภัยที่ค้างอยู่ในเครื่องที่ถูกลืม วิเคราะห์: โมเดล Pull ทำงานกับ Edge ได้ดีอย่างไร จุดเปลี่ยนสำคัญที่ทำให้ GitOps เข้ากันได้กับสภาพแวดล้อมโรงงานคือโมเดล pull-based แทนที่เซิร์ฟเวอร์กลางจะ push การเปลี่ยนแปลงออกไปหา edge (ซึ่งต้องเปิดพอร์ตเข้าแต่ละเครื่องและรู้หมายเลข IP ทุกเครื่อง) ฝั่ง edge เป็นผู้ initiate connection ออกไปดึง desired state จาก Git repository…
Read More
WebAssembly (Wasm) ที่ Edge ของโรงงาน: บทวิเคราะห์ Container Alternative ที่ Cold Start ต่ำกว่า 1 ms

WebAssembly (Wasm) ที่ Edge ของโรงงาน: บทวิเคราะห์ Container Alternative ที่ Cold Start ต่ำกว่า 1 ms

Article
ทำไมโรงงานปี 2026 ถึงพูดถึง Wasm ที่ Edge หลายทีมที่ดูแลระบบ IIoT คุ้นเคยกับการ deploy โค้ดลง Edge Gateway ด้วยสองทางเลือกคลาสสิก คือคอมไพล์โปรแกรมลง OS ตรงๆ หรือห่อด้วย Linux Container แต่ทั้งสองวิธีมีข้อจำกัดที่เจ็บปวดเมื่อเครื่อข่าย Edge โตขึ้น โค้ดที่คอมไพล์ตรงๆ ย้ายระหว่างสถาปัตยกรรม CPU ไม่ได้ ส่วน Container กินทรัพยากรเริ่มต้นค่อนข้างมากและมีพื้นที่โจมตี (attack surface) กว้าง WebAssembly หรือ Wasm คือ binary format มาตรฐานเปิดที่แก้ปัญหาเหล่านี้ได้พร้อมกัน ตัวเลขจาก State of WebAssembly Survey ปี 2026 ชี้ว่าผู้ใช้งานจริงใน production ขึ้นไปถึง 67% เพิ่มจาก 47% ในปี 2024 และเป็นครั้งแรกที่การใช้งานฝั่ง server-side แซงการใช้ในเบราว์เซอร์ โดย 52% ของ deployment ใช้งานในสภาพแวดล้อมที่ไม่ใช่เบราว์เซอร์ Edge Gateway คือจุดที่เหมาะที่สุดในการรัน Wasm module เพราะเป็นชั้นที่ต้องการทั้งความปลอดภัยและการจัดการโค้ดหลากหลายสถาปัตยกรรม CPU (ภาพ: Honey Corporation) Wasm แตกต่างจาก Container ตรงไหน หัวใจของ Wasm คือ sandbox ระดับสถาปัตยกรรมที่ออกแบบมาตั้งแต่แรก โมดูล Wasm แต่ละตัวทำงานแยกจากกันโดยสิ้นเชิง และไม่สามารถเข้าถึงไฟล์ เครือข่าย หรือ hardware ใดๆ ได้เลยจนกว่า host จะมอบสิทธิ์ (capability) ให้อย่างชัดเจน ลักษณะเช่นนี้ต่างจาก Container ที่ process ภายในแชร์ kernel ของ host และเคยมีช่องโหว่ container escape หลายครั้งในอดีต มิติเปรียบเทียบ Linux Container Wasm Module Cold Start500 ms ถึง 2 วินาทีต่ำกว่า 1 ms Memory ขั้นต่ำ100 MB ขึ้นไป1–10 MB ความสามารถพอร์ตตาบิลิตี้ผูกกับ OS และ CPU archbinary…
Read More
บทวิเคราะห์: Digital Twin ออกจากห้วงนำร่องปี 2026 — ทำไม Predictive Maintenance กลายเป็น use case แรกที่ขยายสู่ทั้งโรงงาน

บทวิเคราะห์: Digital Twin ออกจากห้วงนำร่องปี 2026 — ทำไม Predictive Maintenance กลายเป็น use case แรกที่ขยายสู่ทั้งโรงงาน

Article
คำถามที่เปลี่ยนไป — สองปีก่อน คำถามที่ผู้บริหารโรงงานถามเรื่อง Digital Twin คือ "มันคุ้มไหม" ปี 2026 คำถามกลายเป็น "จะขยายจากนำร่องสู่ทั้งโรงงานได้อย่างไร" รายงานแนวโน้มอุตสาหกรรมการผลิตปี 2026 จากหลายสำนักวิเคราะห์ระดับโลกสะท้อนภาพเดียวกัน: Digital Twin และ Smart Factory กำลังก้าวพ้นช่วงทดลอง (Pilot Phase) สู่การใช้งานจริงในระดับองค์กร โดยเฉพาะในงานมอนิเตอร์เครื่องจักรเรียลไทม์และการบำรุงรักษาเชิงคาดการณ์ (Predictive Maintenance) การเปลี่ยนแปลงนี้สำคัญเพราะเกือบทศวรรษที่ผ่านมา เทคโนโลยีโรงงานอัจฉริยะติดอยู่ที่ "Pilot Purgatory" — นำร่องเสร็จ ทำได้จริง แต่ขยายไม่ได้ ครั้งนี้ต่างจากเดิมเพราะตัวแปรหลายตัวเปลี่ยนพร้อมกัน ห้องควบคุมโรงงาน — จุดที่ข้อมูลจาก Digital Twin ต้องมาบรรจบเป็นการตัดสินใจจริง ไม่ใช่แค่ภาพสวยบนจอ (ภาพ: Wikimedia Commons) ทำไมครั้งนี้ถึงออกจาก Pilot ได้จริง: 4 ตัวแปรที่พร้อมพร้อมกัน จากที่เราสังเกตจากงานวางระบบให้โรงงานอุตสาหกรรม การออกจากห้วงนำร่องของ Digital Twin ปี 2026 เกิดจากตัวแปร 4 ตัวที่สุกพร้อมกัน: ข้อมูลเรียลไทม์ราคาถูกลงมาก — เซ็นเซอร์วัดอุณหภูมิ แรงสั่นสะเทือน แรงดัน ความเร็วรอบ และพลังงาน พร้อมโปรโตคอลมาตรฐานอย่าง OPC UA (IEC 62541) และ MQTT ทำให้ต้นทุนการ "เติมเซ็นเซอร์" ให้เครื่องจักรเดิมลดลงจนคุ้มค่าในเชิงพาณิชย์ — เฉพาะงานแรงสั่น เซ็นเซอร์เร่งความเร็วแบบ MEMS รุ่นอุตสาหกรรมปัจจุบันสุ่มข้อมูลได้ระดับหลัก kHz เพียงพอต่อการวิเคราะห์ FFT หาความผิดปกติของลูกปืนและเฟืองตามโซนความรุนแรงของมาตรฐาน ISO 10816/20816 Edge Computing เสถียรแล้ว — การประมวลผลที่ตู้คอนโทรลหรือ Edge Gateway ทำให้การตรวจจับความผิดปกติเกิดขึ้นในหลักมิลลิวินาที ไม่ต้องรอขึ้นคลาวด์ ลดภาระแบนด์วิดท์และความเสี่ยงจากเน็ตขาด AI ตรวจจับความผิดปกติได้จริง — โมเดลเรียนรู้พฤติกรรมปกติของเครื่องจักรแต่ละตัว แล้วแจ้งเตือนเมื่อพฤติกรรมเบี่ยงเบน โดยไม่ต้องรอ failure label ที่มีน้อยมากในโรงงานจริง การผสานระบบที่จำเป็นเริ่มเป็นมาตรฐาน — Digital Twin + CMMS (ระบบซ่อมบำรุง) + ERP + Edge + 5G กำลังถูกออกแบบให้ทำงานร่วมกันตั้งแต่ต้น ไม่ใช่ต่อทีหลัง เซ็นเซอร์ IIoT ติดตั้งภาคสนามเพื่อมอนิเตอร์คุณภาพน้ำและอากาศ — โมเดลมูลค่าเดียวกันกับที่ใช้กับแรงสั่น อุณหภูมิ และแรงดันในงานบำรุงรักษาเชิงคาดการณ์ (ภาพ:…
Read More
ตลาด Smart Manufacturing 2026–2030: วิเคราะห์ตัวเลข 1.75 แสนล้านดอลลาร์ สู่ 2.74 แสนล้านดอลลาร์ และ 5 แรงขับเคลื่อนที่โรงงานไทยต้องรู้

ตลาด Smart Manufacturing 2026–2030: วิเคราะห์ตัวเลข 1.75 แสนล้านดอลลาร์ สู่ 2.74 แสนล้านดอลลาร์ และ 5 แรงขับเคลื่อนที่โรงงานไทยต้องรู้

Article
ปี 2026 ตลาดเทคโนโลยีการผลิตอัจฉริยะกำลังเปลี่ยนจาก "ความน่าตื่นเต้น" ไปเป็น "การแข่งขันจริง" รายงาน "Industry 4.0 & Smart Manufacturing Market Report 2026–2030" ฉบับล่าสุดจากสำนักวิเคราะห์ IoT Analytics ระบุว่า ตลาด Smart Manufacturing ทั่วโลกในปี 2025 มีมูลค่า 1.75 แสนล้านดอลลาร์สหรัฐ และจะเติบโตต่อด้วย CAGR 9.3% จนแตะ 2.74 แสนล้านดอลลาร์ภายในปี 2030 — เกือบ 1 แสนล้านดอลลาร์ของตลาดใหม่ที่จะเกิดขึ้นใน 5 ปี ตัวเลขนี้ไม่ใช่แค่สถิติ แต่สะท้อนการตัดสินใจลงทุนของโรงงานนับหมื่นแห่งทั่วโลก รวมถึงโรงงานไทยที่กำลังยืนอยู่ที่จุดเลือกทาง ระหว่างการเปลี่ยนผ่านที่เลือกเอง กับการถูกคู่ค้าและคู่แข่งบังคับให้เปลี่ยนในภายหลัง สายการผลิตอัตโนมัติในโรงงานสมัยใหม่ — สนามแข่งขันหลักของตลาด Smart Manufacturing มูลค่า 1.75 แสนล้านดอลลาร์ (ภาพ: Wikimedia Commons) 5 แรงขับเคลื่อนที่ทำให้ตลาดโตแบบ "หยุดไม่ได้" การเติบโต 9.3% ต่อปีไม่ได้มาจากเทคโนโลยีเพียงอย่างเดียว แต่มาจากแรงกดดัน 5 ด้านที่เข้ามาพร้อมกัน: แรงกดดันด้านต้นทุน — ค่าแรง พลังงาน และวัตถุดิบที่สูงขึ้นต่อเนื่อง บีบให้ผู้ผลิตต้องหาเทคโนโลยีมาลดความสูญเสียและเพิ่มประสิทธิภาพ ภูมิรัฐศาสตร์และ Supply Chain — กระแสย้ายฐานผลิตกลับ (Reshoring) ไปยังประเทศต้นทุนสูง ทำให้ระบบอัตโนมัติกลายเป็นเงื่อนไขของการอยู่รอด ไม่ใช่ทางเลือก วิกฤตแรงงาน — การขาดแคลนแรงงานฝีมือและโครงสร้างประชากรที่เปลี่ยน บังคับให้เครื่องจักรทำงานร่วมกับคนหรือทดแทนตำแหน่งที่หาคนไม่ได้ เทคโนโลยีพร้อมแล้ว — Edge Computing และ Cloud เสถียรพอที่จะเชื่อมโลก OT เข้ากับ IT ได้จริง ไม่ใช่แค่หน้ากระดาษ บอร์ดบริหารเร่ง AI — ผู้บริหารระดับสูงเร่งรัดให้นำ AI ลงสู่โรงงาน โดยเฉพาะกระแส Physical AI ที่เปลี่ยน AI จาก "ตัววิเคราะห์ข้อมูล" เป็น "ระบบที่ลงมือทำงานจริงบนพื้นโรงงาน" เมื่อผู้ขายเทคโนโลยีรายใหญ่เปลี่ยนสายพันธุ์: จากฮาร์ดแวร์สู่ซอฟต์แวร์ หนึ่งในสัญญาณที่สำคัญที่สุดของปี 2026 คือการเปลี่ยนยุทธศาสตร์ของผู้จำหน่ายเทคโนโลยีชั้นนำกว่า 750 รายในตลาดนี้ บริษัทยักษ์ใหญ่ 10 อันดับแรกต่างมีจุดยืนตรงกันคือ เปลี่ยนจากบริษัทฮาร์ดแวร์ ไปสู่สถาปัตยกรรมที่ขับเคลื่อนด้วยซอฟต์แวร์และผสมผสาน AI (Software-defined, AI-infused architectures) เป้าหมายปลายทางคือ "โรงงานอัตโนมัติที่สั่งการด้วยการรับรู้" (Perception-driven…
Read More
บทวิเคราะห์ IEC 61499: มาตรฐาน Distributed Automation ที่ถูกลืม 20 ปี กำลังกลับมาแรงในยุค Software-Defined Factory

บทวิเคราะห์ IEC 61499: มาตรฐาน Distributed Automation ที่ถูกลืม 20 ปี กำลังกลับมาแรงในยุค Software-Defined Factory

Article
ทุกครั้งที่วิศวกรอัตโนมัติคนหนึ่งลาออก ความรู้ในหัวของเขาก็หายไปพร้อมกัน ลองนึกภาพ: ตู้ PLC ที่ทำงานมา 12 ปี มี logic หลายพัน rung ที่แก้ไขข้ามหลายชั่วคน ไม่มีเอกสาร ไม่มีใครเข้าใจทั้งหมด และตอนนี้ต้องขยายสายการผลิตเพิ่ม สถานการณ์นี้คือ "หนี้ทางเทคนิค" (Technical Debt) ที่สะสมในโรงงานอุตสาหกรรมทั่วโลก และเป็นคำถามเปิดที่มาตรฐาน IEC 61499 ตั้งใจมาตอบ IEC 61499 คืออะไร และต่างจาก IEC 61131-3 ตรงไหน IEC 61499 เป็นมาตรฐานสากลที่พัฒนาต่อยอดจาก IEC 61131-3 (มาตรฐานภาษาโปรแกรม PLC ที่ใช้กันแพร่หลายที่สุดในปัจจุบัน) โดยยกระดับสมรรถนะขึ้นจาก "การควบคุมเชิงเหตุการณ์" ไปสู่ "การกระจายตัวของระบบ" (Distributed Automation) หัวใจสำคัญของ 61499 คือการทำให้ function block สามารถถูก "ย้าย" ข้ามอุปกรณ์ได้ โดยไม่ต้องเขียนโค้ดใหม่ แต่ในทางปฏิบัติ แนวคิดนี้เจออุปสรรคใหญ่: vendor lock-in ผู้ผลิต PLC รายใหญ่ของโลกจำนวนมากไม่ได้เปิดใช้ IEC 61499 เต็มรูปแบบ เพราะมันขัดกับผลประโยชน์ทางการค้าของพวกเขา — ถ้า logic ย้ายได้อิสระ ลูกค้าก็ย้ายผู้ขายได้อิสระเช่นกัน ผลคือ 20 ปีแรกของ 61499 เงียบเหงา จนกระทั่งยุค Industry 4.0 ที่ software-defined automation กลายเป็นจริง Ladder Diagram ภาษาคลาสสิกของ IEC 61131-3 ที่วิศวกรส่วนใหญ่ถนัด แต่ถูกออกแบบมาเพื่อเครื่องเดียว ไม่ใช่ระบบกระจายตัว (ภาพ: Wikimedia Commons) 3 แนวคิดหลักที่ทำให้ 61499 ต่างออกไป Event-Driven Execution Model — ใน 61131-3 คอนโทรลเลอร์รันแบบ scan cycle ตามรอบ (cyclic) ทั่วไป 1-10 ms ต่อรอบ ไม่ว่าข้อมูลจะเปลี่ยนหรือไม่ แต่ 61499 function block ทำงานเมื่อมี event เข้ามาเท่านั้น ทำให้ประหยัดทรัพยากร CPU และตอบสนองเฉพาะสิ่งที่เปลี่ยนแปลง Separation of Interface and Implementation —…
Read More
Zero-Shot Anomaly Detection: ตรวจจับตำหนิที่ AI “ไม่เคยเห็นมาก่อน” ด้วย Vision-Language Model

Zero-Shot Anomaly Detection: ตรวจจับตำหนิที่ AI “ไม่เคยเห็นมาก่อน” ด้วย Vision-Language Model

Article
ทำไมโมเดล AI แบบเดิมถึง "เพิ่มรุ่นใหม่ไม่ทัน" โรงงานสมัยนี้เปลี่ยนผลิตภัณฑ์เร็วขึ้นมาก สายการผลิตเดียวอาจสลับ SKU ทุก 2–3 วัน ลูกค้าของัดสีพิเศษ หรือมีอะไหล่ใหม่ที่ไม่เคยมีในชุดข้อมูลเดิม ปัญหาคือระบบตรวจจับตำหนิด้วย AI แบบดั้งเดิม (Supervised Learning) ต้องการภาพตัวอย่างที่ "ติดป้าย" จำนวนหลายพันภาพต่อหนึ่ง Defect กว่าจะเทรนเสร็จ ผลิตจริงเปลี่ยนไปแล้ว งานวิจัยล่าสุดจาก arXiv (LiZAD, กรกฎาคม 2026) ระบุชัดว่า "ในสายการผลิต High-throughput ยุคใหม่ การเก็บและ Label ข้อมูลสำหรับทุก Scenario ใหม่เป็นเรื่องไม่ practical แล้ว" นี่คือช่องว่างที่ Zero-Shot Anomaly Detection (ZSAD) เข้ามาเติม — ตรวจจับตำหนิที่โมเดล "ไม่เคยเห็นมาก่อนเลย" ด้วยการอาศัยความเข้าใจภาษาธรรมชาติที่ฝังอยู่ใน Vision-Language Model สายการผลิตอัตโนมัติยุคใหม่ต้องรองรับการเปลี่ยน SKU ที่เร็วขึ้น ระบบตรวจคุณภาพจึงต้อง "ยืดหยุ่น" ตาม (ภาพ: Wikimedia Commons) Vision-Language Model ทำงานกับงานตรวจตำหนิอย่างไร หัวใจของแนวทางนี้คือการเทียบ "ความหมาย" ระหว่างภาพกับข้อความ แทนที่จะจำตำหนิรูปแบบเดิมๆ ระบบจะสร้าง Prompt เช่น a photo of a normal metal surface และ a photo of a metal surface with scratch แล้ววัดว่าภาพที่กล้องจับมา "ใกล้เคียง" ประโยคไหนมากกว่า ถ้าใกล้ประโยคที่พูดถึงตำหนิมากกว่า ระบบก็แจ้งเตือนทันที โดยไม่ต้องเทรนใหม่แม้แต่ภาพเดียว งานวิจัยสายนี้ส่วนใหญ่อ้างอิงสถาปัตยกรรมแบบ CLIP (Contrastive Language-Image Pre-training) ซึ่งเทรนล่วงหน้าด้วยคู่ภาพ-ข้อความนับร้อยล้านคู่ ทำให้โมเดลเข้าใจความสัมพันธ์ระหว่าง "รอยขีดข่วน" ในเชิงภาษา แล้ว map มาหา pattern ทางภาพได้โดยอัตโนมัติ แนวคิด Object Localization ด้วย AI — ZSAD ต่อยอดด้วยการเทียบความหมายระหว่างภาพกับข้อความแทนการจำ Pattern เดิม (ภาพ: Wikimedia Commons) เทคนิคสำคัญที่งานวิจัยปี 2026 กำลังพัฒนา เทคนิค แนวคิด ประโยชน์ต่อโรงงาน Discrete Prompt Optimization (CoEvoAD, ส.ค.…
Read More
Unified Namespace (UNS): สถาปัตยกรรมข้อมูลกลางยุคใหม่ ที่จบปัญหา Point-to-Point ในโรงงาน IIoT

Unified Namespace (UNS): สถาปัตยกรรมข้อมูลกลางยุคใหม่ ที่จบปัญหา Point-to-Point ในโรงงาน IIoT

Article
ทำไมโรงงานยุค IIoT จึงเจอปัญหา "สปาเกตตี้อินทิเกรชัน" กันทุกแห่ง ถ้าคุณเคยเปิด Excel ที่เก็บรายการ interface ระหว่างระบบในโรงงาน แล้วพบว่ามีเส้นเชื่อมระหว่าง SCADA, MES, ERP, ระบบเก็บพลังงาน และ Dashboard แทบทุกคู่เป็นร้อยเส้น คุณกำลังเจอปัญหาที่วงการอุตสาหกรรมเรียกขึ้นชื่อว่า Point-to-Point Integration Hell ยิ่งจำนวนระบบ (N) เพิ่มขึ้น จำนวนการเชื่อมต่อที่ต้องดูแลจะโตตามสูตร N×(N−1)/2 — มีระบบ 10 ตัวก็คือ 45 การเชื่อมต่อ ทุกจุดต้องเขียนโค้ด mapping แยก ทดสอบแยก และพังคนละจุดกันเงียบๆ ปัญหานี้เป็นผลพลอยได้ของสถาปัตยกรรมแบบชั้นตามแนวคิด ISA-95 / Purdue Model ที่ใช้กันมาหลายสิบปี แบบจำลองนี้ดีมากในเชิง ความปลอดภัยและการแบ่งลำดับชั้นความรับผิดชอบ แต่เมื่อมาถึงยุคที่ธุรกิจต้องการข้อมูลแบบเรียลไทม์ข้ามระบบ มันกลับกลายเป็นกำแพงที่ทำให้ทุก integration ต้องผ่าน "บันได" ทีละขั้น ช้าและเปราะบาง "Unified Namespace คือ single source of truth แบบเรียลไทม์ จัดเรียงตามโครงสร้างธุรกิจ และออกแบบให้เปิดกว้าง ไม่ผูกติดกับผลิตภัณฑ์ใด" — นิยามของ Walker Reynolds ผู้บุกเบิกแนวคิด UNS Unified Namespace (UNS) เสนอทางออกที่ตรงจุด: เปลี่ยนโครงสร้างการเชื่อมต่อจาก point-to-point ที่ต่อกันไปมาเป็น Hub-and-Spoke โดยมี MQTT Broker เป็นศูนย์กลางเดียวที่ทุกระบบมา publish และ subscribe ข้อมูล แทนที่จะต้องเขียน integration เฉพาะทุกคู่ระบบ โรงงานอัตโนมัติยุคใหม่มีระบบผู้ผลิตข้อมูลหลายสิบชุดพร้อมกัน — UNS คือชั้นข้อมูลกลางที่รวมทุกอย่างไว้ที่เดียว (ภาพ: Wikimedia Commons) หัวใจของ UNS: MQTT + โครงสร้าง Topic ตาม ISA-95 UNS ไม่ใช่ซอฟต์แวร์ที่ซื้อมาติดตั้งแล้วจบ แต่เป็น สถาปัตยกรรมการจัดระเบียบข้อมูลที่ประกอบด้วย 3 ส่วนหลัก: MQTT Broker เป็นแกนกลางการส่งข้อมูลแบบ publish/subscribe, โครงสร้าง topic ที่จัดเรียงตามลำดับชั้นธุรกิจ และ payload ที่มีโครงสร้างและความหมายชัดเจน (เช่น JSON ที่ผ่านการ data modeling มาแล้ว) กลไก publish/subscribe ผ่าน MQTT…
Read More