บทวิเคราะห์: Reverse Logistics ยุค IIoT — เมื่อกระแสสินค้าไหลกลับกลายเป็น ‘เหมืองทองข้อมูล’ ที่โรงงานไทยมองข้าม

บทวิเคราะห์: Reverse Logistics ยุค IIoT — เมื่อกระแสสินค้าไหลกลับกลายเป็น ‘เหมืองทองข้อมูล’ ที่โรงงานไทยมองข้าม

Article
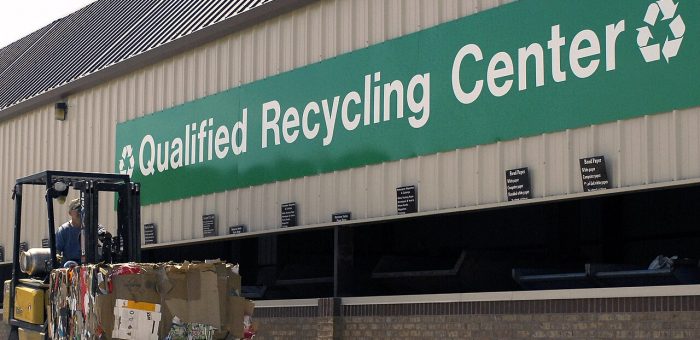
กระแสที่ไหลสวนทาง — และถูกมองข้ามมานานเกินไป ทุกครั้งที่พูดถึง supply chain ของโรงงาน ภาพที่เราถูกฝึกให้เห็นคือลูกศรเดียว: วัตถุดิบเข้า → ผลิต → ส่งออก แต่ความจริงของปี 2026 คือ กระแสที่สองที่ไหลย้อนกลับ — สินค้าส่งกลับ บรรจุภัณฑ์ใช้ซ้ำ ชิ้นส่วนเพื่อ remanufacture และเศษวัสดุเพื่อรีไซเคิล — กำลังโตเร็วกว่าที่องค์กรส่วนใหญ่เตรียมรับไว้ โดยเฉพาะอย่างยิ่งเมื่อ e-commerce ทำให้การคืนสินค้าเป็นเรื่องปกติ และ COD (เก็บเงินปลายทาง) ในตลาดหลายประเทศสร้างปริมาณ "สินค้าถูกปฏิเสธ ณ ประตูบ้าน" ที่ต้องไหลกลับเข้าระบบเช่นกัน Reverse logistics ตามนิยามครอบคลุมทุกกิจกรรมที่เกี่ยวกับการไหลกลับของสินค้าและวัสดุเพื่อการเก็บคุณค่าหรือกำจัดอย่างเหมาะสม — ไม่ใช่แค่ "คลังสินค้าคืน" แต่รวมถึงการหลีกเลี่ยงการคืน (returns avoidance) การคัดกรองที่จุดรับ (gatekeeping) การ remanufacture และการ dispose ที่ถูกต้อง งานวิจัยเชิงวิชาการชี้ตรงกันว่า reverse logistics เชื่อมโยงกับ Service Lifecycle Management (SLM) และกลายเป็นเวทีแข่งขันด้านความพึงพอใจของลูกค้าโดยตรง สนามจริงของ reverse logistics: การคัดแยกวัสดุที่ไหลกลับมา — งานที่ยังอยู่ในมือคนเกือบทั้งหมด และคือจุดที่ข้อมูลหายไปมากที่สุด (ภาพ: Wikimedia Commons) มุมมองของเรา: ปัญหาไม่ใช่ "ของไหลกลับ" แต่คือ "ข้อมูลหายไปตอนไหลกลับ" จากประสบการณ์ของทีม Honey Corporation ในการติดตั้งระบบ IoT Monitoring และ system integration ในโรงงานอุตสาหกรรม เราสังเกตรูปแบบเดียวกันซ้ำๆ: ข้อมูลของกระแสไหลออก (forward) ถูกดูแลอย่างดี — มี WMS, มี TMS, มี tracking — แต่ทันทีที่สินค้าคืนหรือบรรจุภัณฑ์ไหลกลับ ข้อมูลจะกลายเป็น "โซนรก" ที่พึ่งพาการจดบันทึกด้วยมือและความจำของพนักงานคลัง ผลลัพธ์คือสามช่องโหว่ที่โรงงานจ่ายแพงโดยไม่รู้ตัว: มูลค่าคงค้างที่มองไม่เห็น — พาเลท กล่อง และตัวถังที่ใช้ซ้ำได้ (เช่น ถังแก๊ส ถังเบียร์) หายไปเงียบๆ เพราะไม่มีระบบติดตามสถานะการยืม-คืน โอกาส remanufacture ที่ถูกทิ้ง — ชิ้นส่วนที่คืนมาถูกจัดเป็น "เศษ" ทั้งที่สภาพยังใช้งานได้ เพราะไม่มีข้อมูลสภาพและประวัติของชิ้นนั้น ความเสี่ยงประเทศนำเข้าขยะ — กฎระเบียบด้านสิ่งแวดล้อมของปลายทางเข้มขึ้นทุกปี การพิสูจน์แหล่งที่มาและเส้นทางของวัสดุที่ไหลกลับจึงกลายเป็นข้อกำหนด ไม่ใช่ทางเลือก บทวิเคราะห์: ถ้าเทคโนโลยี IIoT ถูกนำมาใช้กับกระแสย้อนกลับจะเกิดอะไรขึ้น…
Read More
EPCIS 2.0: มาตรฐาน GS1 สำหรับ Supply Chain Traceability ที่ทำให้ทุกชิ้นส่วนบอกได้ว่า ‘ตัวเองคือใคร อยู่ที่ไหน เมื่อไหร่ และทำไม’

EPCIS 2.0: มาตรฐาน GS1 สำหรับ Supply Chain Traceability ที่ทำให้ทุกชิ้นส่วนบอกได้ว่า ‘ตัวเองคือใคร อยู่ที่ไหน เมื่อไหร่ และทำไม’

Article
ทำไมโรงงานยุค IIoT จำเป็นต้องมี "ภาษากลาง" ของเหตุการณ์สินค้า ลองนึกภาพโรงงานที่ติดตั้งเซ็นเซอร์ IIoT ไปทั่วสายการผลิต ทุกจุดสแกนบาร์โค้ดส่งข้อมูลเข้าระบบ WMS ของตัวเอง หน่วยงาน QA ใช้ฐานข้อมูลแยกของตัวเอง และผู้ขนส่งเก็บ GPS log ในระบบ TMS อีกชุดหนึ่ง — เวลาลูกค้าโทรมาถามว่า "ล็อตที่ 825 ที่เราได้รับเมื่อวาน ผลิตจากวัตถุดิบล็อตไหน ผ่านคิวบัฟเฟอร์ที่สามหรือไม่" คำตอบที่ได้มักคือ "ขอเวลาตรวจสอบ 2-3 วัน" เพราะข้อมูลกระจัดกระจายอยู่ในระบบที่ไม่เคยคุยกัน นี่คือปัญหาที่มาตรฐาน EPCIS (Electronic Product Code Information Services) ของ GS1 ถูกออกแบบมาแก้โดยตรง โดยเวอร์ชันล่าสุด EPCIS 2.0 ได้รับการรับรองจาก GS1 เมื่อเดือนมิถุนายน 2022 (พร้อม Core Business Vocabulary หรือ CBV 2.0) และขณะนี้เวอร์ชัน 2.1 อยู่ระหว่างพัฒนา คาดว่าจะเผยแพร่ภายในสิ้นปี 2026 ซึ่งสะท้อนว่าโลก supply chain กำลังเคลื่อนจาก "ติดตามสินค้าในองค์กร" ไปสู่ "แลกเปลี่ยนเหตุการณ์ข้ามองค์กร" ด้วยโครงสร้างข้อมูลร่วมกันจริงๆ EPCIS คืออะไร — แกะกล่องมาตรฐานให้เห็นชิ้นส่วนจริง EPCIS เริ่มต้นจากความพยายามของ MIT Auto-ID Center ในปี 2001 ที่เสนอแนวคิด PML (Physical Markup Language) เพื่ออธิบายวัตถุทางกายภาพ ก่อนถูกพัฒนาต่อเป็นมาตรฐานสากลภายใต้ GS1 และตีพิมพ์เวอร์ชัน 1.0 ครั้งแรกในปี 2007 จุดร่วมสำคัญคือ EPCIS ไม่ได้ผูกกับ RFID อย่างที่หลายคนเข้าใจ — ตั้งแต่เวอร์ชัน 1.1 ไม่บังคับให้ระบุระดับ instance และใช้กับแอปพลิเคชันที่ใช้บาร์โค้ดล้วนหรือผสม RFID ได้ (ชื่อ EPC ที่ฝังอยู่เป็นเพียงมรดกทางประวัติศาสตร์) หัวใจของ EPCIS คือการแลกเปลี่ยน "visibility event data" — เหตุการณ์ที่บอกว่า อะไร (What), ที่ไหน (Where), เมื่อไหร่ (When) และ ทำไม (Why) ผ่านสถาปัตยกรรม 3 ส่วน: EPCIS Capture…
Read More
Smart Materials ในโรงงานอุตสาหกรรม: เมื่อวัสดุกลายเป็นเซ็นเซอร์และ Actuator ไปพร้อมกัน

Smart Materials ในโรงงานอุตสาหกรรม: เมื่อวัสดุกลายเป็นเซ็นเซอร์และ Actuator ไปพร้อมกัน

Article
ถ้ามองย้อนไปสิบปีที่แล้ว "วัสดุ" ในโรงงานคือสิ่งที่ถูกซื้อมา ถูกใช้ และถูกเปลี่ยนเมื่อเสีย — ไม่มีส่วนร่วมในระบบดิจิทัลเลย แต่ในปี 2026 แนวคิดกำลังพลิกไปจากเดิม: วัสดุอัจฉริยะ (Smart Materials) กลายเป็น "โหนดข้อมูลชิ้นหนึ่งของระบบ IIoT" ที่รู้สภาพตัวเอง สื่อสารได้ และตอบสนองต่อสภาพแวดล้อมโดยไม่ต้องรอคำสั่งจากภายนอก รายงานเทรนด์อุตสาหกรรมล่าสุดถึงกับจัดให้ Smart Materials เป็นหนึ่งใน 6 เทรนด์หลักของการผลิตปี 2026 พร้อมคาดการณ์มูลค่าตลาดระดับ 1.33 แสนล้านดอลลาร์ภายในปี 2030 บทความนี้เจาะลึกกลไกทางฟิสิกส์ของวัสดุอัจฉริยะ 4 ตระกูลหลักที่เริ่มใช้งานจริงในภาคอุตสาหกรรม พร้อมชี้จุดที่วิศวกรโรงงานควรประเมินก่อนตัดสินใจนำไปใช้ วัสดุอัจฉริยะต่างจากวัสดุทั่วไปอย่างไร วัสดุทั่วไปมีสมบัติคงที่ (Passive) — แข็งแรงเท่าเดิม นำความร้อนเท่าเดิมไม่ว่าสภาวะรอบตัวจะเปลี่ยนไปแค่ไหน วัสดุอัจฉริยะต่างออกไปตรงที่มีสมบัติที่ ตอบสนองต่อสิ่งเร้า (Stimuli-Responsive) อย่างตั้งใจ ไม่ว่าจะเป็นความร้อน แรงสั่น สนามไฟฟ้า หรือความชื้น เมื่อสิ่งเร้าเปลี่ยน โครงสร้างระดับโมเลกุลของวัสดุจัดตัวใหม่ ทำให้เกิดการเปลี่ยนรูป สร้างประจุไฟฟ้า หรือเปลี่ยนสีอย่างย้อนกลับได้ จุดที่ทำให้เรื่องนี้สำคัญกับคนทำ IIoT คือ เมื่อวัสดุ "ตอบสนอง" ได้เอง เราสามารถอ่านค่าการตอบสนองนั้นออกมาเป็นข้อมูล หรือใช้มันเป็นตัวขับ (Actuator) ได้โดยตรง — วัสดุจึงกลายเป็นทั้งเซ็นเซอร์และอินสตรูเมนต์ในชิ้นเดียว ลดจำนวนอุปกรณ์เสริมที่ต้องติดตั้งบนเครื่องจักร เซ็นเซอร์เพียโซอิเล็กทริกแบบแผ่น — หนึ่งในรูปแบบที่พบมากที่สุดของวัสดุอัจฉริยะในงาน Monitor แรงสั่นสะเทือนเครื่องจักร (ภาพ: Wikimedia Commons) 4 ตระกูลวัสดุอัจฉริยะที่ใช้งานจริงในโรงงาน 1. Piezoelectric — วัสดุที่แปลงแรงกดเป็นไฟฟ้า ผลึกเพียโซอิเล็กทริกเช่น PZT (Lead Zirconate Titanate) จะเกิดประจุไฟฟ้าบนผิวเมื่อถูกกดหรือสั่น หลักการนี้ถูกใช้สองทางคู่ขนานกัน: ทางแรกคือเป็นเซ็นเซอร์วัดแรงสั่นความถี่สูง (เหมาะกับงาน Vibration Analysis ของลูกสูบ ปั๊ม และแบริ่งความเร็วสูงที่สัญญาณอยู่ในย่าน kHz) ทางที่สองคือ Energy Harvesting — ใช้แรงสั่นเหลือทิ้งจากเครื่องจักรสร้างไฟฟ้าระดับมิลลิวัตต์เลี้ยงเซ็นเซอร์ไร้สายแบบไม่ต้องเปลี่ยนแบตเตอรี่ ซึ่งเปลี่ยนเกมการติดตั้งเซ็นเซอร์บนเครื่องจักรหมุนที่เดิมต้องวางสายไฟข้ามจุดหมุน 2. Shape Memory Alloy (SMA) — โลหะที่จำรูปและกลับตัวเองได้ โลหะผสมนิกเกิล-ไทเทเนียม (NiTi) สามารถ "จำ" รูปร่างที่ตั้งโปรแกรมไว้ แล้วกลับไปหารูปนั้นเมื่อได้รับความร้อนหรือกระแสไฟฟ้า ในโรงงาน SMA ถูกใช้ทำ Actuator ขนาดเล็กที่มีอัตราส่วนแรงต่อน้ำหนักสูงและกลไกน้อยชิ้นกว่า ตั้งแต่วาล์วนิวแมติกทดแทน คลัตช์แบบอ่อนตัวเมื่อร้อน (ป้องกัน Overload) ไปจนถึงข้อต่อกันสั่นสะเทือนในโครงสร้างอาคารและงานยานยนต์ กลไก Shape Memory Effect: โครงผลึกเปลี่ยนเฟสระหว่างมาร์เทนไซต์ (เย็น)…
Read More
Knowledge Graph กับ Digital Twin: เมื่อกราฟความรู้ทำให้ดิจิทัลทวินเข้าใจโรงงานของคุณจริงๆ

Knowledge Graph กับ Digital Twin: เมื่อกราฟความรู้ทำให้ดิจิทัลทวินเข้าใจโรงงานของคุณจริงๆ

Article
ทำไมโรงงานจึง "มีข้อมูลมหาศาล แต่ตอบคำถามง่ายๆ ไม่ได้" คำถามที่ดูเหมือนง่ายอย่าง "เครื่องอัดกระแทกเนื้อ (hydraulic press) หมายเลข 7 ที่สาย 2 ใช้ VFD รุ่นไหน ติดตั้งเมื่อไร และเชื่อมกับ HMI ตัวไหน" มักต้องข้ามไปถาม 3 แผนก รอคำตอบ 2 วัน เพราะข้อมูลชิ้นนี้กระจายอยู่ใน Excel ของฝ่ายวิศวกรรม, ไฟล์ PDF แผนภาพ P&ID, ฐานข้อมูล SCADA และใบสั่งซื้อในระบบ ERP — ทุกระบบเก็บ "ข้อเท็จจริง" ไว้คนละที่ แต่ไม่มีระบบใดเก็บ "ความสัมพันธ์" ระหว่างข้อเท็จจริงเหล่านั้นเลย Digital Twin ยุคแรกแก้ปัญหาการ "เห็น" เครื่องจักรผ่านโมเดลสามมิติและข้อมูลเรียลไทม์ได้แล้ว แต่ความท้าทายระยะถัดไปคือการทำให้ดิจิทัลทวิน เข้าใจบริบท (context) ว่าอุปกรณ์แต่ละตัวเป็นใคร อยู่ที่ไหน ติดต่อกับใคร และมีความหมายอย่างไรต่อกระบวนการผลิต — นี่คือจุดที่ Knowledge Graph (กราฟความรู้) เข้ามาเป็นชั้นความหมายที่ขาดหายไป ตัวอย่างโครงสร้าง Knowledge Graph: เอนทิตี (วงกลม) เชื่อมกันด้วยความสัมพันธ์ที่มีความหมายชัดเจน (เส้น) — หลักการเดียวกับที่ใช้จัดระเบียบข้อมูลสินทรัพย์ในโรงงาน (ที่มา: Wikimedia Commons, CC0) Knowledge Graph คืออะไร และต่างจากฐานข้อมูลเดิมอย่างไร ฐานข้อมูลแบบตาราง (relational) ออกแบบมาเพื่อเก็บ "ข้อเท็จจริง" ที่โครงสร้างคงที่ เช่น รายการเครื่องจักร รายการใบสั่งซื้อ ส่วน Knowledge Graph ออกแบบมาเพื่อเก็บ "ความสัมพันธ์" เป็นชุดของ triple สามส่วน: หัวเรื่อง → ความสัมพันธ์ → วัตถุ เช่น Motor-M-201 → isPartOf → Line-2, Motor-M-201 → hasSensor → VIB-014, VIB-014 → measures → VibrationVelocity โครงสร้างพื้นฐานของ RDF triple (subject–predicate–object) ที่ Knowledge Graph ใช้เก็บความสัมพันธ์ระหว่างสินทรัพย์ในโรงงาน (ที่มา: Wikimedia Commons, CC BY-SA 4.0) เมื่อทุกข้อเท็จจริงเชื่อมกันเป็นสายโซ่ของความสัมพันธ์…
Read More
บทวิเคราะห์ Hybrid Cloud ในโรงงานอุตสาหกรรม 2026: งานไหนควรอยู่ On-premise งานไหนควรขึ้นคลาวด์

บทวิเคราะห์ Hybrid Cloud ในโรงงานอุตสาหกรรม 2026: งานไหนควรอยู่ On-premise งานไหนควรขึ้นคลาวด์

Article
คำถามที่ฝ่าย IT ของโรงงานไทยถามกันบ่อยที่สุดในปี 2026 ไม่ใช่ "ควรขึ้นคลาวด์ไหม" อีกต่อไป แต่คือ "งานไหนควรอยู่ที่ไหน" เมื่อระบบ SCADA, MES และ data platform ต้องทำงานร่วมกันทั้งบน on-premise และคลาวด์ คำตอบที่กำลังได้รับความนิยมคือ Hybrid Cloud — สถาปัตยกรรมที่ไม่เลือกข้าง แต่จัดวาง workload ตามลักษณะของงาน บทความนี้วิเคราะห์มุมมองของเราที่ Honey Corporation จากประสบการณ์ทำ System Integration ในภาคอุตสาหกรรมไทย ว่าเส้นแบ่งระหว่าง on-premise กับคลาวด์ควรอยู่ตรงไหนจึงจะได้ประโยชน์สูงสุดโดยไม่สร้างความเสี่ยงใหม่ เซิร์ฟเวอร์ในโรงงาน (on-premise) ยังคงเป็นที่พำนักของระบบ real-time control และข้อมูลดิบ — ขณะที่คลาวด์รับงานวิเคราะห์ระยะยาว (ภาพ: Wikimedia Commons) ทำไม "All-in Cloud" และ "All-in On-premise" ต่างก็ไม่ใช่คำตอบ ฝ่ายที่ผลักดัน all-in cloud มักอ้างเรื่องความยืดหยุ่น ไม่ต้องลงทุน hardware ล่วงหน้า และเข้าถึงบริการ AI ได้ทันที แต่ในบริบทโรงงาน มีสามข้อจำกัดที่ยังแก้ไม่ตก: Latency และ dependency — ระบบควบคุมกระบวนการผลิตต้องทำงานต่อแม้อินเทอร์เน็ตขาด การพึ่งพาคลาวด์ 100% ในงาน critical loop คือความเสี่ยงที่ยอมรับไม่ได้ ปริมาณข้อมูลดิบ — เซ็นเซอร์หลายพันจุดสร้างข้อมูลดิบมหาศาล การเก็บทั้งหมดบนคลาวด์เป็นการใช้ทรัพยากรอย่างสิ้นเปลือง ทั้งยังมีค่าใช้จ่าย egress เมื่อต้องดึงกลับมาวิเคราะห์ ข้อกำหนดด้านข้อมูล — ลูกค้าบางรายหรือกฎหมายบางประเทศกำหนดว่าข้อมูลกระบวนการผลิตบางประเภทห้ามออกนอกประเทศ ในทางกลับกัน all-in on-premise ก็แพ้ในเกมระยะยาว: ทีมงานจำกัด การขยายระบบช้า และการเข้าถึงเครื่องมือ AI/ML สมัยใหม่ที่คลาวด์พัฒนาออกมาตลอดเวลา ทำได้ลำบากกว่ามาก เส้นแบ่งที่เราใช้: วาง workload ตาม 4 คำถาม จากประสบการณ์ติดตั้งระบบให้โรงงานหลายแห่ง เราสรุปกรอบการตัดสินใจ 4 คำถาม ก่อนวาง workload ใดๆ ลงที่ไหน: Workload ความเร็วที่ต้องการ ลักษณะข้อมูล ที่วางที่เหมาะสม Real-time control / interlockมิลลิวินาทีข้อมูลดิบหมุนเร็วOn-premise (PLC/DCS) Line dashboard / Andonวินาทีข้อมูลรวมระดับสายผลิตOn-premise edge server OEE, production reportนาที–ชั่วโมงข้อมูลสรุปรายวัน/รายสัปดาห์Cloud ML…
Read More
How-to: ออกแบบ Edge-to-Cloud Data Pipeline สำหรับโรงงาน IIoT ใน 5 ขั้นตอน — จาก Data Source Inventory ถึงกฎการไหลของข้อมูล

How-to: ออกแบบ Edge-to-Cloud Data Pipeline สำหรับโรงงาน IIoT ใน 5 ขั้นตอน — จาก Data Source Inventory ถึงกฎการไหลของข้อมูล

Article
หลายโรงงานที่เริ่มทำ IIoT ติดอยู่ที่เดิม: เซ็นเซอร์ติดแล้ว ข้อมูลเห็นแล้ว แต่พอจะนำไปใช้จริงกลับพบว่าข้อมูลกระจัดกระจายในหลายระบบ รูปแบบไม่ตรงกัน และ dashboard ที่สวยงามนั้น ดูได้อย่างเดียว ไม่เชื่อมกับการตัดสินใจ รากของปัญหามักไม่ใช่เซ็นเซอร์หรือ AI แต่เป็น สายการไหลของข้อมูล (Data Pipeline) ที่ไม่ถูกออกแบบมาตั้งแต่ต้น บทความนี้เป็นคู่มือแบบทีละขั้น สำหรับวิศวกรที่ต้องการวาง pipeline จากเซ็นเซอร์ในสายการผลิต ผ่าน edge gateway ไปจนถึงคลาวด์อย่างเป็นระบบ — โดยไม่ต้องเป็น data engineer เต็มตัว สายการผลิตสมัยใหม่มีจุดเก็บข้อมูลกระจายอยู่ทั้งสาย — pipeline ที่ดีต้องรวมข้อมูลเหล่านี้ให้เป็นภาพเดียวก่อนส่งขึ้นคลาวด์ (ภาพ: Wikimedia Commons) ทำไมต้องเป็น Edge-to-Cloud (ไม่ใช่ส่งตรงขึ้นคลาวด์) ลองคำนวณง่ายๆ: มิเตอร์พลังงาน 200 จุด ส่งค่าทุก 1 วินาที รวมกว่า 17 ล้านค่าต่อวัน เพียงพอจะทำให้ฐานข้อมูลที่ออกแบบมาไม่ดีบวมในไม่กี่เดือน และการส่งข้อมูลดิบทั้งหมดขึ้นคลาวด์เป็นภาระ bandwidth ที่หลีกเลี่ยงได้ การคาดการณ์ของ Gartner ที่ชี้ว่าตลาด edge computing จะเติบโตจาก 131,000 ล้านดอลลาร์ (2023) สู่ 511,000 ล้านดอลลาร์ (2033) สะท้อนว่าโลกกำลังย้ายการประมวลผลกลับมาใกล้โรงงาน ไม่ใช่เพื่อแทนคลาวด์ แต่เพื่อส่งขึ้นคลาวด์เฉพาะ ข้อมูลที่มีคุณค่า Step 1: สำรวจและจัดทำ Inventory ของแหล่งข้อมูล ก่อนซื้ออุปกรณ์ใด ให้ทำ Data Source Inventory ให้ครบก่อน — ทุก PLC, VFD, มิเตอร์, เซ็นเซอร์ และไฟล์ที่คนงานบันทึกด้วยมือ ตัวอย่างตาราง: แหล่งข้อมูล โปรโตคอล อัตราการเก็บข้อมูล ปลายทางที่เหมาะสม PLC สายประกอบOPC UA100 msEdge สรุปผลก่อนส่ง Cloud VFD / มอเตอร์Modbus TCP1 วินาทีEdge (แจ้งเตือนความผิดปกติ) มิเตอร์พลังงานModbus RTU1 วินาทีEdge (สรุปเป็น profile 15 นาที) เซ็นเซอร์อุณหภูมิ/ความชื้นMQTT30 วินาทีEdge ส่งตรงขึ้น Cloud ตารางนี้จะบอกคุณเองว่าจุดรวมข้อมูล (aggregation point) ควรอยู่ที่ไหน และโปรโตคอลใดต้องการตัวแปลง Step 2: เลือก Edge Gateway ให้เหมาะกับงาน…
Read More
Edge Analytics ในโรงงานอุตสาหกรรม: วิเคราะห์ข้อมูลทันใจที่ตู้คอนโทรล ก่อนส่งขึ้นคลาวด์

Edge Analytics ในโรงงานอุตสาหกรรม: วิเคราะห์ข้อมูลทันใจที่ตู้คอนโทรล ก่อนส่งขึ้นคลาวด์

Article
Edge Analytics คืออะไร — ในโรงงานสมัยใหม่ เซ็นเซอร์และเครื่องจักรหนึ่งแห่งสามารถผลิตข้อมูลได้วันละหลายกิกะไบต์ การส่งข้อมูลดิบทั้งหมดขึ้นคลาวด์ก่อนค่อยประมวลผลไม่ใช่คำตอบอีกต่อไป ทั้งจากค่า bandwidth, latency และความเสี่ยงเมื่ออินเทอร์เน็ตขาดหาย Edge Analytics คือการนำกระบวนการวิเคราะห์ข้อมูล — ตั้งแต่การกรองสัญญาณ คำนวณค่าสถิติ ไปจนถึงโมเดล AI — มาวางไว้ที่ edge of the network ใกล้กับแหล่งกำเนิดข้อมูล ไม่ว่าจะเป็น Edge Gateway ในตู้คอนโทรล คอมพิวเตอร์อุตสาหกรรมข้างสายการผลิต หรือเซิร์ฟเวอร์ในโรงงานเอง ผลลัพธ์คือการตัดสินใจเกิดขึ้นภายใน มิลลิวินาที แทนที่จะต้องรอไป-กลับคลาวด์หลายร้อยมิลลิวินาที ซึ่งเป็นความต่างระหว่าง "หยุดเครื่องทันเวลา" กับ "เสียชิ้นงานทั้งล็อต" แผงควบคุมอัตโนมัติที่เก็บ historical data ของเครื่อง press — จุดที่ Edge Analytics ทำงานจริง ก่อนข้อมูลจะถูกส่งขึ้นคลาวด์ (ภาพ: Wikimedia Commons) ทำไมปี 2026 ต้องพูดถึง Edge Analytics อีกครั้ง ตัวเลขสองชุดอธิบายได้ดีที่สุด รายงานของ IoT Analytics (Industry 4.0 & Smart Manufacturing Market Report 2026–2030) ระบุว่าตลาด Smart Manufacturing ทั่วโลกปี 2025 มีมูลค่า 175,000 ล้านดอลลาร์ และจะเติบโตด้วย CAGR 9.3% ไปแตะ 274,000 ล้านดอลลาร์ในปี 2030 ขณะที่ Gartner คาดการณ์ตลาด edge computing โลกจะขยายจาก 131,000 ล้านดอลลาร์ (2023) สู่ 511,000 ล้านดอลลาร์ภายในปี 2033 — เกือบ 4 เท่าใน 10 ปี แรงขับเคลื่อนที่แท้จริงไม่ใช่ตัวเทคโนโลยีเอง แต่เป็นสามแรงกดดันที่โรงงานไทยกำลังเผชิญ: (1) ปริมาณข้อมูลจาก IIoT sensor ที่เพิ่มขึ้นแบบทวีคูณจนส่งขึ้นคลาวด์ทั้งหมดไม่คุ้ม (2) งานที่ต้องการความเร็วระดับมิลลิวินาที เช่น การตรวจจับความผิดปกติของ vibration signature และ (3) นโยบาย data residency ที่บังคับให้ข้อมูลอ่อนไหวบางประเภทอยู่ในประเทศ สถาปัตยกรรม 3 ชั้นของ Edge Analytics Edge…
Read More
บทวิเคราะห์ WRC 2026: เมื่อหุ่นยนต์ถูกถามว่า “ทำงานจริงได้หรือยัง” — สัญญาณจากปักกิ่งที่โรงงานไทยต้องอ่าน

บทวิเคราะห์ WRC 2026: เมื่อหุ่นยนต์ถูกถามว่า “ทำงานจริงได้หรือยัง” — สัญญาณจากปักกิ่งที่โรงงานไทยต้องอ่าน

Article
กลางเดือนสิงหาคมที่ผ่านมา งาน World Robot Conference (WRC) 2026 ที่ปักกิ่งปิดฉากลงด้วยภาพที่ต่างจากปีก่อนๆ อย่างชัดเจน — ไม่ใช่การแข่งกันอวดว่าโมเดลฉลาดแค่ไหน แต่เป็นการถูกถามคำถามตรงๆ ว่า "หุ่นยนต์ตัวนี้ทำงานจริงได้หรือยัง" และคำถามนั้น เป็นคำถามเดียวกันที่ผู้จัดการโรงงานในไทยถามทุกวัน ตัวเลขจากงานบอกอะไร ปีนี้ WRC มีผู้เข้าร่วมแสดงสินค้ามากกว่า 300 ราย เพิ่มขึ้นราว 40% จากปีก่อน พร้อมหุ่นยนต์บนเวทีราว 3,000 ตัว ในพื้นที่ 52,000 ตารางเมตร ขยายเป็น 4 ฮอลล์ แต่สิ่งที่น่าสนใจกว่าขนาดงานคือองค์ประกอบของคนในงาน: มี รัฐวิสาหกิจ (SOE) 49 แห่ง เดินทางมาร่วมกัน พร้อมส่งมอบ 12 สถานการณ์วิศวกรรมจริง ตั้งแต่งานโครงข่ายไฟฟ้า อวกาศ เหมืองแร่ ไปจนถึงงานโลหกรรม เพื่อหาโซลูชันหุ่นยนต์ที่ใช้งานได้จริง — ผู้ซื้อมาหาผู้ขายด้วยโจทย์จริง ไม่ใช่แค่มาชมเทคโนโลยี จาก VLA สู่ World Model — วิวัฒนาการที่โรงงานควรเข้าใจ กระแสเทคนิคที่เปลี่ยนไปจากปีก่อนคือ ปี 2025 คนพูดถึง Vision-Language-Action (VLA) model กันทั้งงาน แต่ปีนี้ผู้แสดงสินค้าหันมาพูดถึงการผสาน World Model เข้ากับ VLA แทน — งานวิจัยที่เผยแพร่บน arXiv ช่วงก่อนหน้านี้ก็ไปในทิศทางเดียวกัน โดยนำเสนอวิธี pre-train ที่ทำให้ policy เดียวทำงานข้ามรูปแบบหุ่นยนต์ที่ต่างกันได้ เหตุผลทางเทคนิคง่ายกว่าที่คิด: VLA เพียวๆ มองเห็นฉาก ตีความคำสั่ง แล้วสั่งการเคลื่อนไหวได้ แต่มันไม่ได้ "คาดเดา" ว่าสิ่งแวดล้อมจะเปลี่ยนไปอย่างไรหลังการกระทำนั้น เมื่องานยาวขึ้น ความผิดพลาดจึงสะสม และประสิทธิภาพตกทันทีที่เจอสถานการณ์ไม่คุ้นเคย — ซึ่งเป็นเรื่องปกติมากในสายการผลิตจริง ที่ตำแหน่งชิ้นงานคลาดเคลื่อนหรือของหลุดมือจาก pallet ได้ตลอดเวลา มุมเปรียบเทียบVLA เพียวๆVLA + World Model การมองสถานการณ์รับรู้ฉากปัจจุบันแบบ snapshotคาดการณ์การเปลี่ยนแปลงของสภาพแวดล้อม งานยาว (Long-horizon)error สะสม ประสิทธิภาพตกเสถียรกว่า เพราะคาดผลลัพธ์ก่อนลงมือ สถานที่ไม่คุ้นเคยต้องเทรนใหม่เมื่อ layout เปลี่ยน generalize ได้ดีกว่า ปรับตัวเร็วกว่า ความเร็วอนุมานเร็วกว่า (pipeline สั้น)ช้ากว่า แต่บางสถาปัตยกรรมลดช่องว่างได้ (มีรายงานเร็วขึ้น 2.71 เท่าจาก autoregressive แบบเดิม) การหยิบจับวัตถุด้วยมือหุ่นยนต์ในสภาพแวดล้อมจริง — งานที่ง่ายสำหรับคนแต่ยากที่สุดสำหรับโมเดล เพราะต้องคาดการณ์แรง…
Read More
State of IoT ล่าสุด: อุปกรณ์เชื่อมต่อทั่วโลกแตะ 21.1 พันล้านเครื่อง — โรงงานไทยควรอ่านตัวเลขไหนให้ขาด

State of IoT ล่าสุด: อุปกรณ์เชื่อมต่อทั่วโลกแตะ 21.1 พันล้านเครื่อง — โรงงานไทยควรอ่านตัวเลขไหนให้ขาด

Article
ทุกครั้งที่มีรายงานใหม่ออกมา เรามักเห็นพาดหัวแบบ "IoT โตมหาศาล" แต่คนทำงานในโรงงานควรสนใจตัวเลขจริงที่อยู่เบื้องหลัง เพราะมันบอกอะไรละเอียดกว่านั้นมาก — ล่าสุด IoT Analytics (ตุลาคม 2025) ปรับปรุงตัวเลข State of IoT รอบใหม่ และมีทั้งข่าวดีและสัญญาณเตือนที่น่าสนใจสำหรับผู้วางแผนระบบ IIoT ในไทย ตัวเลขหลักที่ต้องจำ จำนวนอุปกรณ์ IoT ที่เชื่อมต่ออยู่ทั่วโลกแตะ 21.1 พันล้านเครื่อง ณ สิ้นปี 2025 เพิ่มขึ้น 14% จาก 18.5 พันล้านเครื่องในปี 2024 และคาดการณ์ว่าจะไปถึง 39 พันล้านเครื่องในปี 2030 (CAGR 13.2%) ก่อนทะลุ 50 พันล้านเครื่องราวปี 2034–2035 น่าสังเกตว่าการเติบโต 14% นี้เกิดขึ้น "แม้" การลงทุนขององค์กรจะถูกเลื่อนออกไป และดีมานด์ในจีนชะลอตัวจน forecast ถูกปรับลงราว 300 ล้าน connection จากที่คาดไว้ก่อนหน้า ปีอุปกรณ์ IoT เชื่อมต่อ (พันล้านเครื่อง)การเติบโต YoY 202418.5+12% 202521.1+14% 2030 (คาด)39.0CAGR 13.2% 2035 (คาด)>50ชะลอหลังปี 2030 ที่มา: IoT Analytics, State of IoT 2025 (อัปเดต Fall 2025) 3 เทคโนโลยีที่กินส่วนแบ่งเกือบ 80% เบื้องหลังตัวเลขรวม การเชื่อมต่อ IoT แทบทั้งหมดกระจุกอยู่ใน 3 เทคโนโลยีหลักคือ Wi-Fi, Bluetooth และ Cellular IoT ซึ่งรวมกันคิดเป็นเกือบ 80% ของ connection ทั้งหมด โดย Cellular IoT โตเร็วกว่าค่าเฉลี่ยตลาด — เฉพาะปี 2026 คาดว่าจะมี connection แบบเซลลูลาร์ถึง 5.4 พันล้าน line (CAGR 14.3% ถึงปี 2030) เพราะงานอุตสาหกรรม โลจิสติกส์ และการแพทย์ ต้องการการเชื่อมต่อที่ควบคุมได้และครอบคลุมพื้นที่กว้างโดยไม่ต้องวางโครงข่ายเอง แผนภาพแนวคิด Industry 4.0 — การเชื่อมต่อระหว่างเครื่องจักร ข้อมูล และระบบสารสนเทศคือหัวใจของการเติบโตของ IoT (ภาพ: Wikimedia…
Read More
Cyber Resilience สำหรับโรงงาน: ศาสตร์แห่งการกลับมาผลิตให้เร็วที่สุด เมื่อการโจมตีหยุดไม่ได้

Cyber Resilience สำหรับโรงงาน: ศาสตร์แห่งการกลับมาผลิตให้เร็วที่สุด เมื่อการโจมตีหยุดไม่ได้

Article
เมื่อการโจมตีเปลี่ยนจาก "ขอเงิน" ไปเป็น "หยุดโรงงาน" — คำถามจึงไม่ใช่ว่าจะโดนหรือไม่ แต่คือกลับมาผลิตได้เร็วแค่ไหน ตลอดหลายปีที่ผ่านมา โรงงานอุตสาหกรรมคุ้นเคยกับ ransomware ในรูปแบบ "เข้ารหัสข้อมูล แล้วขอค่าไถ่" แต่แนวโน้มที่ชัดเจนในปี 2026 คือการเปลี่ยนเป้าหมายไปที่ operational disruption — การหยุดการผลิตโดยตรง ไม่จำเป็นต้องเข้ารหัสอะไรเลย อาจเป็นแค่การแก้ control logic ให้ไลน์หยุดเป็นพักๆ หรือปิดระบบ monitoring ชั่วคราวจนโรงงานต้องปิดเครื่องเพื่อความปลอดภัย รายงานจากสายงาน OT security ระบุว่า downtime ที่ไม่ได้วางแผนของบริษัทอุตสาหกรรมในเยอรมนีมีมูลค่าราว 147,000 ยูโรต่อชั่วโมง ตัวเลขนี้อธิบายว่าทำไมผู้โจมตีจึงหันมา "เล่นกับเวลา" แทนการเล่นกับข้อมูล — ทุกชั่วโมงที่ไลน์หยุด คือแรงกดดันที่เพิ่มขึ้นต่อฝ่ายบริหาร และคือ leverage ของฝ่ายโจมตีในการเจรจา ในโลกที่การป้องกันร้อยเปอร์เซ็นต์เป็นไปไม่ได้ Cyber Resilience จึงกลายเป็นคำถามที่วิศวกรโรงงานต้องตอบให้ได้: ไม่ใช่ "จะไม่ให้โดนได้อย่างไร" แต่คือ "เมื่อโดนแล้ว จะกลับมาผลิตได้เร็วแค่ไหน โดยไม่เสียความปลอดภัย" ระบบ IT ที่รองรับการกู้คืนโรงงาน — backup ที่ดีไม่ได้อยู่แค่ในห้องเซิร์ฟเวอร์ แต่ต้องมีสำเนาที่ผู้โจมตีแตะไม่ได้ (ภาพ: Wikimedia Commons, CC BY-SA 3.0) เปลี่ยนกรอบคิด: จาก Prevention เป็น Resilience กรอบคิดเดิมวางเงินไปที่กำแพง — firewall, antivirus, access control ซึ่งยังจำเป็นอยู่ แต่กรอบคิด resilience เพิ่มคำถามอีกสามข้อที่มักถูกลืม: ระบบจะ ตรวจจับการโจมตีได้เร็วแค่ไหน (MTTD), จะ จำกัดความเสียหายไม่ให้ลามไปทั้งโรงงานได้อย่างไร และจะ กู้คืนกลับมาผลิตได้ภายในเวลาเท่าไร (MTTR) มิติ กรอบคิดแบบ Prevention กรอบคิดแบบ Resilience เป้าหมายไม่ให้ผู้โจมตีเข้ามาได้เข้ามาแล้วรอด เห็นเร็ว กลับมาผลิตได้เร็ว ตัวชี้วัดหลักจำนวนการโจมตีที่บล็อกได้MTTD และ MTTR เทียบกับ RTO ที่ธุรกิจกำหนด บทบาทของ backupเป็นงานฝ่าย IT ตามหลังเป็นแกนหลักของการกู้คืน ต้องทดสอบทุกไตรมาส การซ้อมซ้อม table-top ปีละครั้ง (ถ้ามี)restore drill บน testbed ทุกไตรมาส วัดเวลาจริง ผู้รับผิดชอบทีม IT securityทีมผลิต + วิศวกรรม + IT ร่วมกัน หัวใจของการกู้คืนโรงงาน: สำรองสิ่งที่ "เป็นตัวโรงงาน"…
Read More